
要約:
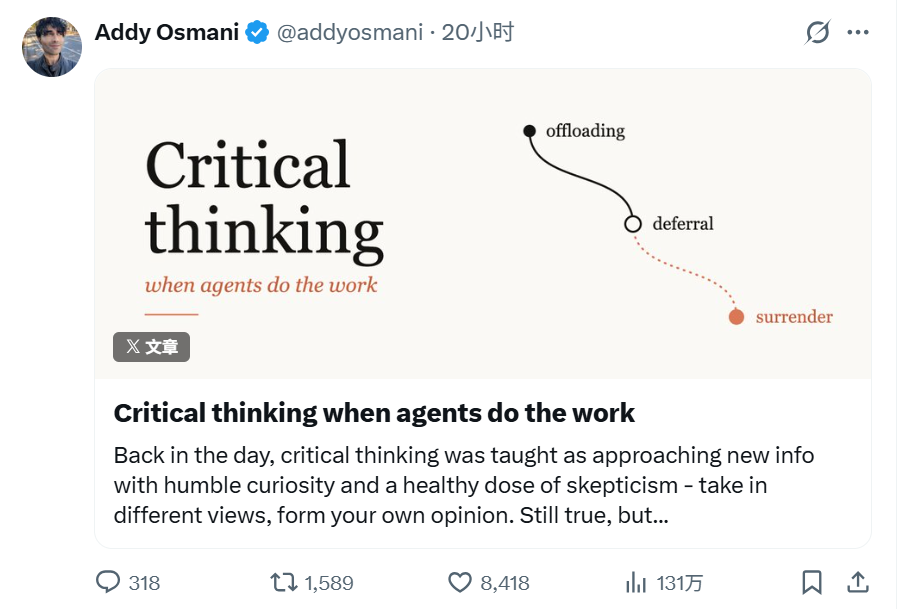
11 月 4 日、Anthropic の Claude Code チームのエンジニアであり、元 Google テクノロジー幹部であるアディ オスマニ氏は、最近ソーシャル プラットフォームに長い記事を公開しました。彼はこの現象を
「認知的降伏」
と呼んでいます。 (認知的降伏)。
Osmani は Google で 14 年以上勤務し、Chrome 開発者エクスペリエンスと Google Cloud AI 関連ビジネスを担当してきました。彼は現在、Anthropic で Claude Code に取り組んでいます。
オスマニ氏は、AI エージェントのワークフローの熱心な支持者であり、日常業務で複数のエージェントを同時に実行することが多いと述べました。しかし、彼は警戒に値する変化を発見しました。
AI モデルが改良され続けるにつれて、出力結果に明らかなエラーがどんどん少なくなり、人間が警戒を続けることが難しくなってきています。
これまでは、答えを得るために情報収集、分析、判断などのプロセスを経る必要がありましたが、現在ではこのプロセスが数秒に短縮される可能性があります。 AI によって生成されたコンテンツは、多くの場合、適切に構造化され、流暢に表現され、ほとんどの場合正しいため、ユーザーが独自の思考や検証を省略することがますます容易になっています。
彼は人間による AI の使用状況を 3 つのレベルに分けました。 1 つ目は
「認知オフロード」
(コグニティブオフロード)、つまり、タスクは完了するために AI に引き渡されますが、結果に対しては引き続き AI が責任を負います。 2 つ目は「判断の延期」
(延期)つまり、AI の出力は検証が必要な仮説とは見なされなくなり、次の作業ステップの基礎として直接使用されます。最後は「認知的降伏」
,つまり、AI の出力は徐々にユーザー自身の判断になり、ユーザーは確認する必要すら考えなくなります。
その中で、「認知的降伏」という概念は、ウォートン スクールの研究者スティーブン ショーとギデオン ネーブによって最初に提案されました。
オスマニ氏は、
この変革は多くの場合突然起こるのではなく、AI を継続的に使用する過程で徐々に形成される
と考えています。。
ユーザーは、最初の AI レポートを注意深く読んでも、2 番目の AI レポートはざっと見るだけ、さらには 3 番目の AI レポートの概要を確認するだけでも構いません。最終的に、特定の結論について尋ねられたときに、ユーザーはロジックを説明できないことに気づくかもしれません。彼はこの現象を「認知的負債」に関連付けました。ソフトウェア開発の分野では、AI が大量のコードを生成し、すべてのテストに合格する可能性がありますが、システム アーキテクチャと実装ロジックに対するチーム メンバーの理解は減り続けています。ある日、システムを変更する必要が生じたときになって初めて、開発者は特定の機能がどのように機能するかを誰も実際には理解していないことに気づきました。
しかし、オスマニ氏は、開発者が巨大なコードベースの詳細をすべて記憶する必要があるとは考えていません。同氏は、Claude Code チームは必要に応じて AI を使用して特定のコード モジュールの理解を再確立する予定であると指摘しました。本当に大切なのは、常にすべてを知っていることではなく、何が分からないのかを知り、それを再理解する能力を持つことです。
「認知的降伏」を回避する方法についてオスマニ氏は、
AI に複雑な質問をする前に、人間は答えを与えるために AI に完全に依存するのではなく、独自の予備的な仮定を立てる必要があると提案しました。
たとえ最初の推測が正確でなかったとしても、ユーザーが AI の結果を受け取ったときに独立した判断の根拠を保持するのに役立ちます。彼はまた、
ユーザーは単にモデルの答えにどの程度自信があるかを尋ねるのではなく、AI の結論を覆す可能性のある証拠を積極的に探すべきであると提案しました。
物議を醸す問題については、さまざまなモデルが反対の立場から議論を提示し、人間が総合的な判断を下すことができます。ソフトウェア開発の分野において、オスマニ氏は、AI 時代のボトルネックがコードの作成からコードが正しいかどうかの検証に移行していると考えています。
現在、AI エージェントは独立してコードを作成し、テストを実行し、エラー メッセージを読み取り、テストに合格するまで繰り返し変更できます。しかし問題は、テスト自体も AI によって記述される可能性があることです。テストロジックとコードに同じエラーがある場合、すべてのテストがパスしたとしても、ソフトウェアに問題がないことを証明することはできません。
したがって、開発者はテストが合格するかどうかに注意を払うだけでなく、テストで何が証明され、どのようなリスクがカバーされないのかを明確にする必要があると彼は強調しました。 AI によって提供される結果の合格基準は、AI によって生成された一見合理的な概要ではなく、実際のテスト結果、操作ログ、スクリーンショットなどの検証可能な証拠である必要があります。
オスマニ氏はまた、開発者はエージェントに対して、タスクの実行中に自律的に下した決定、採用した前提、無視した条件を明確にリストするよう要求すべきであると提案しました。これらの内容は通常、最終的な作業概要には表示されないためです。
AI がより多くのタスクを同時に実行できるようになると、別の問題が発生し始めます。オスマニ大統領はこれを
「オーケストレーション税」
と呼んでいます。 (オーケストレーション税)、つまり、AI が結果を生み出す速度と、人間が慎重にレビューして責任を負う速度との間のギャップです。AI によって生成された作業結果が蓄積され続け、人間がそれを確認する十分な時間がなくなった場合、エージェントの数を増やし続けても問題は解決されません。この場合、チームは自動検証メカニズムを改善するか、タスクの生成速度を適切に下げる必要があると彼は考えています。
オスマニ氏はまた、
AI の高度な自動化により、人間が本来のスキルを練習することを徐々に放棄する可能性があると警告しました。
同氏は、開発者に対し、AI を使用せずにコードを毎週書いてみること、練習をやめたスキルを毎月見直して、どの能力がまだ保持する価値があるかを判断することを推奨しています。彼はまた、社内エンジニアや研究者による AI の使用に関する Anthropic の研究を引用し、「監督のパラドックス」があると指摘しました。つまり、クロードを監督するにはプログラミング能力が必要ですが、AI を過度に使用するとこれらの能力が低下する可能性があります。
オスマニ氏は、これらの見解は AI の使用を削減すべきであるという意味ではないと強調しました。エラーのコストが低いタスクは完全に AI に任せても問題ありませんが、投資、キャリアの選択、製品の安全性、または他の人々に影響を与える重大な決定に関しては、依然として人間が重要な判断権を保持する必要があります。
彼の見解では、将来の AI モデルは人間よりもエラーを見つける能力が優れているかもしれませんが、だからといって人間の責任がなくなるわけではありません。
どの製品を開発するか、なぜ開発する価値があるのか、誰に影響を与えるのか、そのためにいくらの価格を支払ってもよいのかを決定するには、依然として人間の選択が必要です。
彼は記事の最後で次のように結論付けています。「
作業とほとんどのレビュー タスクを AI に引き渡すことはできますが、責任も引き継ぐことはできません。
”
コメント