
要約:
Apple の研究チームがロボットの「脳」に関する研究の進歩を明らかに。現地時間11月4日、Appleの研究チームは論文「Perceptive Humanoid Motion from Simulation」をプレプリントプラットフォームarXivに投稿し、ヒューマノイドロボット自律制御システムHALOを公開した。研究チームは検証のためにこのシステムをYushu TechnologyのG1人型ロボットに導入し、ロボットがシミュレーション環境で学習した動作を、見慣れない現実の部屋でも実行できるようにした。
研究チームはまた、アクション生成、アクション追跡、タスク オーケストレーション、シミュレーション、実際のロボット操作をカバーするデータ生成、モデル トレーニング、展開コードも公開しました。
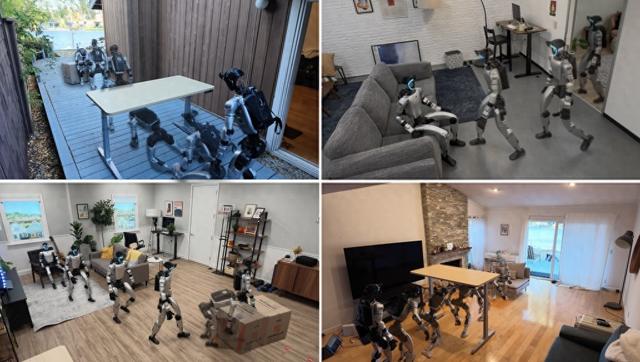
Yushu G1 ロボットHALO システムを搭載したユーザーは、実際のさまざまな環境で、テーブルの下にもぐり込む、ソファに座る、箱を押すなどのタスクをデモンストレーションします。画像出典: HALO 研究チーム
プロジェクト ページでは、ロボットが箱を押す、人の後を追う、椅子に座る、半開きのドアを横から通過する、かがむかテーブルの下を這うなどの指示に従っている様子が示されています。これらのタスクでは、ロボットが周囲の環境を理解し、空間条件に応じて体の姿勢を調整する必要があります。
タスクを実行するとき、HALO は 3 つのレベルで連携して制御されます。最上位層は、ビジュアル言語モデル (VLM) に基づくタスク オーケストレーション モジュールです。デフォルトでは Qianwen Qwen3.6-35B-A3B を使用します。ロボットに搭載された Mac mini 上でローカルに動作します。モデル サービス エンジンをアクション ジェネレーターと共有し、インターネット接続を必要とせずに動作します。システムは、より強力な推論機能と計画機能を取得するために、API を介してクラウド モデルを呼び出すことも選択できます。
この層は、命令内のあいまいな情報を処理し、環境に従ってアクションを配置する必要があります。たとえば、「座る」には明確に指定された目標はなく、ロボットは目の前のシーンからどこに座るかを決定する必要があります。 「椅子に座る」は、道に障害がない場合は直接実行できますが、テーブルが邪魔になっている場合は、身を乗り出す、椅子に近づく、座るなどの連続したサブタスクに分割する必要があります。タスク オーケストレーション モジュールは、ロボットの視点からビデオを通じて環境を継続的に観察し、現在のアクションが成功したかどうかを判断し、それに応じて計画を進めるか再試行し、毎回明確なサブタスクをアクション ジェネレーターに発行します。
中央のアクション生成層は、別の Qianwen モデル Qwen3.5-2B を使用します。研究チームはこれをパラメータ凍結エンコーダとして使用し、アクションの生成を担当する DiT デコーダと連携して、ロボットが見た画像と現在のサブタスクに基づいて、将来の約 5 秒間の全身の動きを計画します。このレイヤーは 1 秒あたり約 3 回再計画されるため、環境の変化に応じてアクション プランを継続的に更新できます。
最下層は、強化学習、ポリシー抽出、その他のステップを通じてトレーニングされたアクション トラッカーです。 1 秒あたり 50 回の頻度で実行され、深度画像とロボット自身のステータスを組み合わせて、アクション プランを共同制御命令に変換します。
3 つのレベルはそれぞれ、タスクの配置、行動計画、身体制御を担当し、指示の理解から行動の実行までのプロセスを協力して完了します。
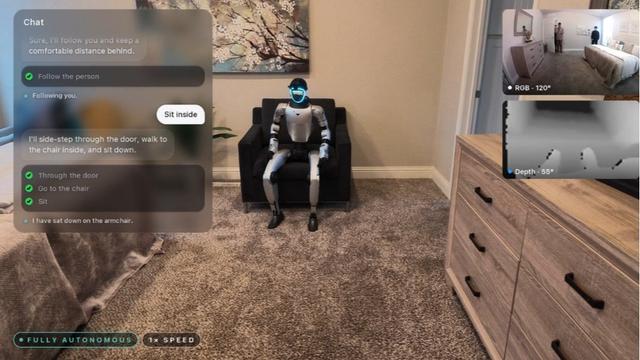
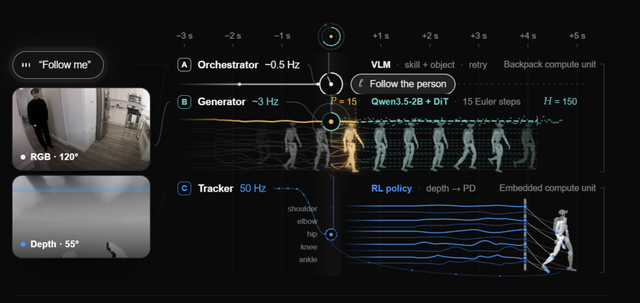
HALO の 3 層の制御アーキテクチャ: 視覚言語モデルはタスクのオーケストレーションを担当し、生成モジュールは全身の動きを計画し、強化学習によって訓練されたアクション トラッカーは共同制御を実行します。画像ソース: HALO プロジェクト ページのスクリーンショットのモザイク
論文によると、研究チームは事前スキャンやマッピングを行わずに 6 つの実際の環境で 360 のシングル タスク テストを実施し、平均成功率は 91% でした。別の実際の環境では、3 つのタスクを組み合わせて 10 回のテストが実行され、平均成功率は 70% でした。このうち、「障害物に身を乗り出す→目標に向かって歩く→箱を押す」の組み合わせの成功率は50%。
ロボットがこれらのタスクを完了するために必要なデータをどのように取得するかが、この研究の焦点です。研究チームは、プログラムで生成された1,000の模擬家庭環境で約300時間の一次トレーニングデータを合成し、「ロボットが見たもの」「受け取った指示」「動き方」を照合した。
具体的には、システムは最初にアクションを生成し、次にそのアクションを仮想部屋に配置し、最後にロボットの視点から画像を生成します。プロジェクトページでは「肘掛け椅子に座る」を例に、前に歩く、向きを変える、座るなどのセグメントに分割しています。アクション生成モデルは、テキスト プロンプト、ウェイポイント、および主要な姿勢に基づいてアクション シーケンスを生成します。その後、幾何学的チェックによってアクションが選別され、足の滑りや地面への身体の侵入などの問題が軽減されます。
次に、システムはプログラムで生成された部屋にアクションを配置し、ロボットと家具の間の位置関係をチェックし、衝突のない配置計画を探します。その後、シミュレーション ツールを使用して、ロボットがアクションを実行するときに見えるものをレンダリングします。トレーニング中は、照明、色調、画像のぼかしなどの条件も変更され、視覚的な入力がより多様になります。このようにして、同じプロセスで、指示、視覚的画像、全身の動きなどのサポート データを生成できます。
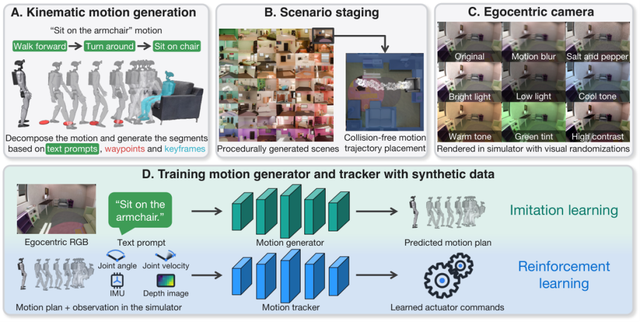
HALO の合成データの生成とトレーニングのプロセス: まずアクションの軌跡を生成し、それを仮想シーンに配置し、次にロボットの視点から画像をレンダリングして、アクション ジェネレーターとアクション トラッカーをトレーニングするためのサポート トレーニング データを形成します。画像ソース: HALO 論文
レポートによると、研究チームは 250 個の NVIDIA H100 GPU を使用し、メインのトレーニング データを合成するのに約 48 時間かかりました。アクション ジェネレーターは、64 台の B200 を使用した模倣学習を通じてトレーニングされます。アクション トラッカーは、4 つの H100 を使用して、強化学習、ポリシー抽出、およびその他のステップを通じてトレーニングされます。
シミュレーションによって生成されたデータは人間の参加を完全に排除するものではないことに注意してください。研究チームは、新しい物理的タスクでは依然としてプロンプトワードの手動作成とアクションキーフレームの設計が必要であり、一部のアクションでは人間のビデオやモーションキャプチャ素材も使用されると述べた。
研究チームはまた、現在のロボットは主に視覚に依存しており、接触状況を直接認識するのは難しいとも指摘しました。オブジェクトがカメラの視野から外れたり、遮られたりすると、より多くの接触を伴うタスクのパフォーマンスが低下します。触覚の追加は、その後の改善の方向性の 1 つです。
コメント