
要約:
人工知能の新興企業 Architect Labs は、実験的な Frostbite CPU アーキテクチャは従来のプロセッサ コアよりもワットあたりのパフォーマンスが 4.59 倍、単位面積あたりのパフォーマンスが 8.77 倍高いと主張しています。人工知能を使用してゼロから設計された Frostbite は、コンピューティングに対して根本的に異なるアプローチを採用していますが、その素晴らしい結果はまだ実際のチップで検証されていません。
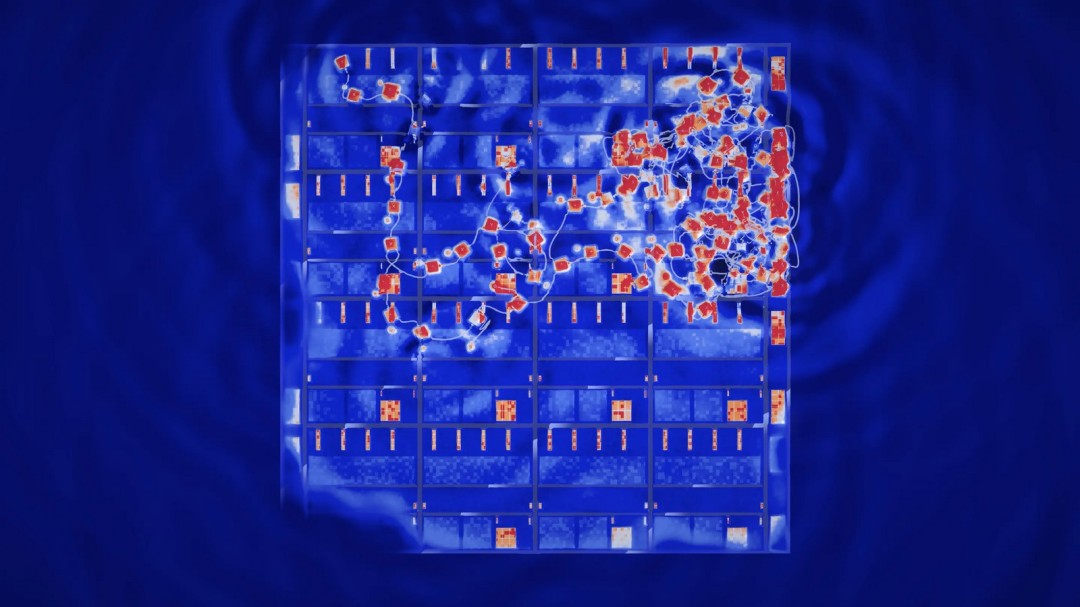
アメリカの人工知能スタートアップ企業 Architect Labs は、同社の人工知能システムが命令セット、マイクロアーキテクチャ、RTL コード、検証、最終的な GDS レイアウトを含む新しい汎用 CPU アーキテクチャをゼロから設計したと主張しています。同社によれば、25 のワークロードの下で、新しい設計のワットあたりのパフォーマンスは従来の CPU コアの 4.59 倍、単位面積あたりのパフォーマンスは従来の CPU コアの 8.77 倍になります。ただし、これらの結果は、実際の物理プロセッサではなく、チップ製造前のシミュレーションから得られたものです。
従来の CPU とは異なり、Frostbite アーキテクチャは、1990 年に初めて提案されたインタラクションネットと呼ばれる数学モデルに基づいています。単一の大きなコアに依存するのではなく、インタラクション ネットワークの形式で表されるプログラムを実行する小さなコンピューティング ユニットのグリッドを使用します。インタラクション ネットワークは、接続されたノードのローカルな書き換えによって計算が実行されるグラフです。各コンピューティング ユニットは最初に自身のタスクを処理し、アイドル状態のときに隣接するコンピューティング ユニットから追加の作業を受け取ります。実行する作業がない場合は、電力を節約するために非アクティブ状態になることがあります。この分散アプローチにより、集中スケジューラの必要性がなくなり、アーキテクチャがよりスケーラブルになるように設計されています。
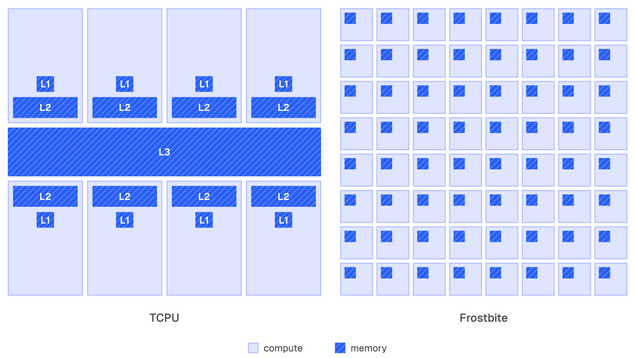
Architect Labs によれば、このアプローチにより、共有可変メモリ、複雑なキャッシュ階層、キャッシュ コヒーレンス メカニズムの必要性も軽減されます。各値の所有者は 1 人だけであり、計算は接続されたノード間のローカルな対話を通じて行われます。プログラムは同社が開発したVine言語でRustに似た構文で記述され、Ivyと呼ばれる中間表現にコンパイルされる。
同社は、AI システムが「アーキテクチャに関する事前知識ゼロ」でアーキテクチャを探索し、コンパイラ、命令セット、アーキテクチャ、マイクロアーキテクチャ、RTL、検証、最終的な GDS レイアウトを反復処理したと述べました。このプロセスでは、正式な機械検証可能な仕様とマルチエージェント クラスターが使用され、4 ラウンドの検索と最終ラウンドのテストで合計 58 の提案が検討されました。 Architect Labsは、最終的に37件の提案が保留されたと述べた。
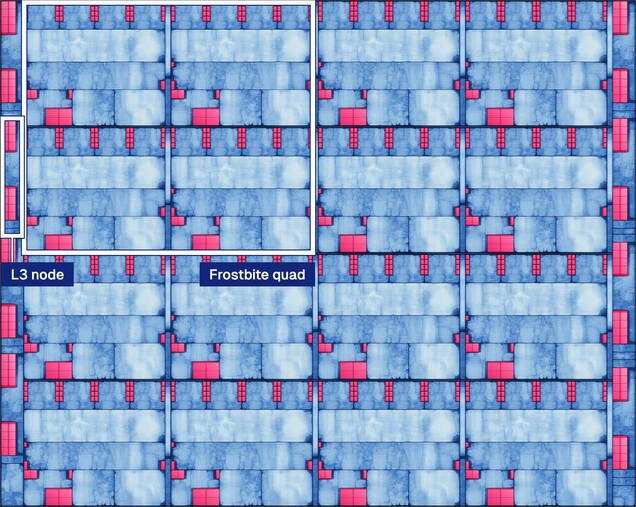
Frostbite の 7nm レイアウトは 4×4 グリッドを特徴とし、2×2 Frostbite クアッドと L3 ノードを強調表示します
パフォーマンス評価のために、Architect Labs は 7nm プロセスを使用して Frostbite コアを合成しました。設計は合成プロセス中に 800MHz の周波数に達し、最終的な物理レイアウトは 500MHz でした。 Frostbite Quad は、2×2 グリッドに配置された 4 つのコンピューティング ユニットと 4 つの L3 キャッシュ ノードで構成され、面積は 0.792 平方ミリメートルです。比較用のCPUコア(同社はTCPUと呼ぶ)は同じプロセス技術を使用しており、面積は0.895平方ミリメートル。法的な理由から、Architect Labs は競合プロセッサの正体を明らかにしていません。
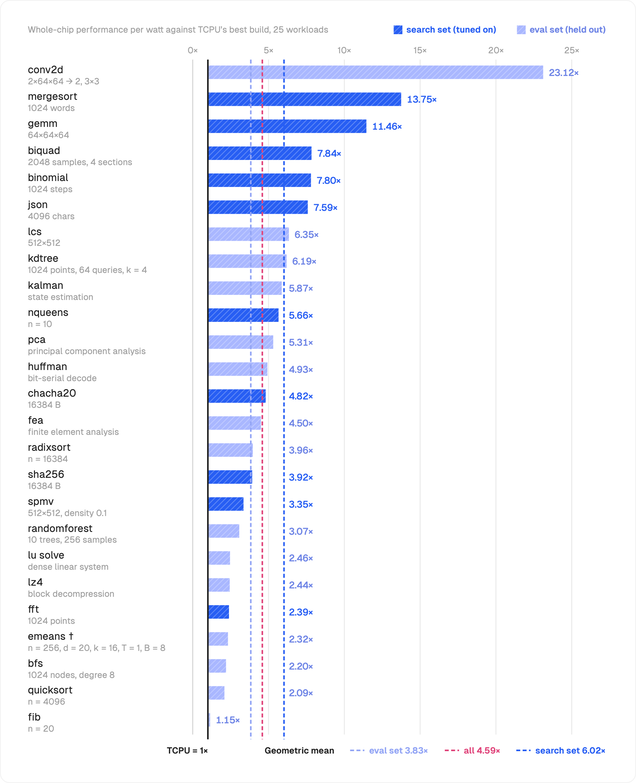
25 回のワークロード テストを通じて、Frostbite アーキテクチャは、リファレンス CPU コアの 4.59 倍のワットあたりの幾何平均パフォーマンスを達成しました。この利点は、最適化プロセス中に使用された 10 回のワークロード テスト全体で 6.02 倍に達し、最終評価前に保持された 15 回のワークロード テスト全体では 3.83 倍に達しました。同社はまた、単位面積あたり最大 8.77 倍のパフォーマンス上の利点があると報告しました。
25 ワークロードでの Frostbite アーキテクチャのワットあたりのパフォーマンスは、従来の CPU とどのように比較されますか?破線は、検索セット、ホールドアウト セット、およびすべてのワークロードの幾何平均を表します。
Architect Labs は、パフォーマンスの向上はメモリ トラフィックと命令オーバーヘッドの削減によるものであると述べています。テスト結果はワークロードによって大きく異なります。 Frostbite は、並列性の高いタスクで特に優れたパフォーマンスを発揮します。また、Architect Labs は、分岐や動的なワークロードでもリファレンス コアよりも優れたパフォーマンスを発揮すると指摘しています。同社は、業界標準の SPEC および PARSEC ベンチマークを含むようにテストを拡大し、それらをより大規模で幅広のアウトオブオーダーの CPU 設計と比較する予定です。
結果は有望ですが、Frostbite アーキテクチャはまだ実験段階にあり、大量生産されるプロセッサではありません。 Architect LabsはFrostbiteチップの量産や発売の計画を発表していない。同社は、RTL と命令セット アーキテクチャ (ISA) をリリースし、FPGA ベースのソフトウェア テスト プラットフォームを構築し、予備的なオペレーティング システムを開発し、SPEC や PARSEC などの業界標準のベンチマーク ツールを使用して、マルチコア CPU を備えた大規模な Frostbite 構成のパフォーマンスを比較する予定です。
コメント