要約:
開発者が行った実験によると、カスタマイズされたソフトウェアを介して iPhone 17 Pro Max を M4 Pro チップを搭載した MacBook Pro に接続すると、ローカルの大規模言語モデルの動作効率が大幅に向上することがわかりました。 Qwen3.8-27B モデルを実行すると、システムのプレフィル パフォーマンスが最大 44% 向上します。
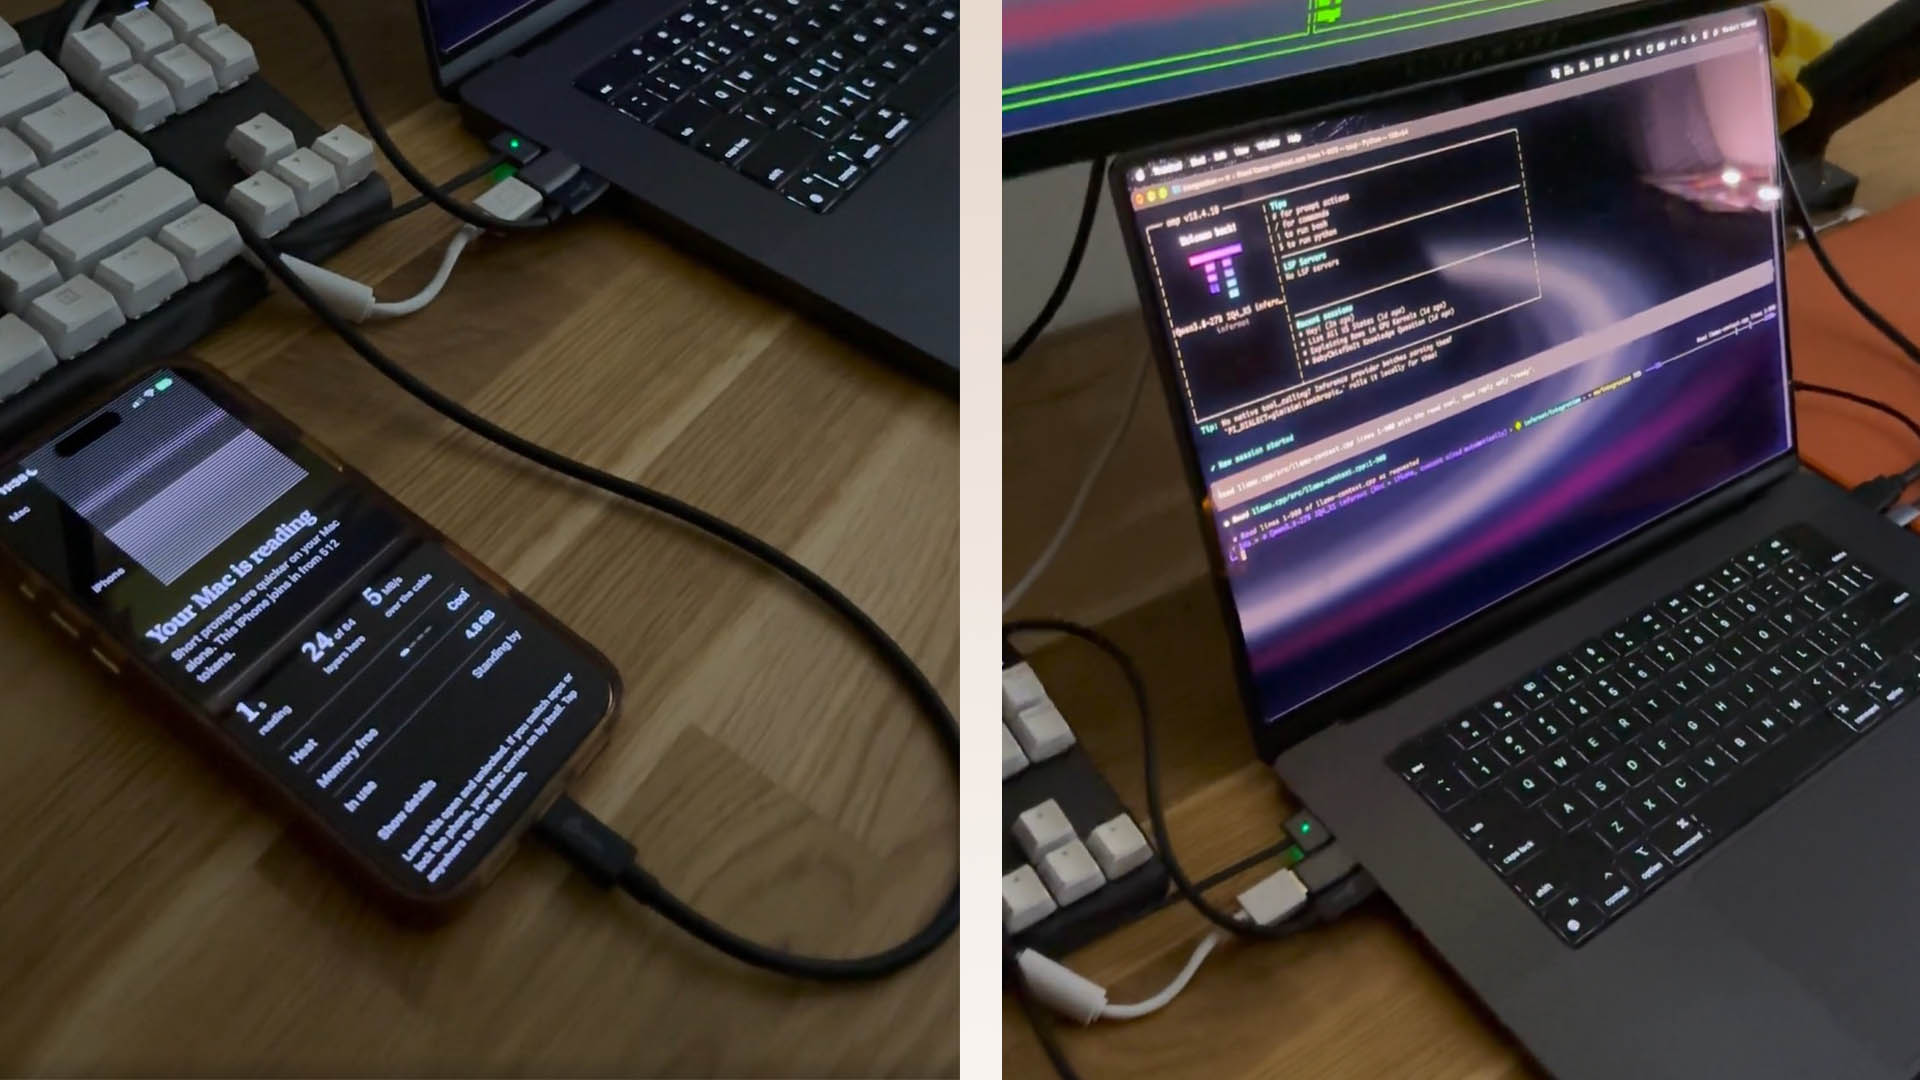
この実験の背景には、大規模な言語モデルにはビデオ メモリとシステム メモリ容量に対する要件が非常に高いことが挙げられます。 M4 Pro チップを搭載した MacBook Pro には 24GB のユニファイド メモリが搭載されていますが、270 億のパラメータ レベルを持つ大型モデルを実行する場合、メモリ容量とコンテキスト ウィンドウのサイズによって制限されます。したがって、開発者は、USB-C インターフェイスを介して MacBook Pro と連携してモデルを実行するための追加のコンピューティング ノードとして iPhone 17 Pro Max を使用しようとしました。
開発者が発表した計画によると、MacBook Pro は 256 トークンのバッチごとにレイヤー 1 からレイヤー 40 までのコンピューティング タスクを処理し、中間アクティベーション データをリアルタイムで iPhone に送信します。その後、iPhone 17 Pro Max は A19 Pro チップの GPU を使用してレイヤー 41 からレイヤー 64 の操作を実行し続け、同時に Mac はデータの次のバッチの処理を開始します。このパイプライン化された分業により、2 つのデバイスが同時にモデル推論プロセスに参加できます。
実験結果によると、MacBook Pro のみでモデルを実行した場合と比較して、iPhone 導入後は事前入力速度が大幅に向上しました。 8K コンテキスト ウィンドウでは、処理速度が 1 秒あたり 132 トークンから 177 トークンに増加し、35% 増加しました。 16K コンテキスト ウィンドウでは、パフォーマンスが 1 秒あたり 109 トークンから 157 トークンに向上し、44% 増加しました。 32K コンテキスト ウィンドウのシナリオでは、処理速度が 1 秒あたり 101 トークンから 130 トークンに増加し、約 29% 増加します。
GPU 協調コンピューティングに加えて、A19 Pro チップのニューラル ネットワーク エンジンもいくつかのタスクに参加します。開発者らは、16K のすべての履歴コンテキストが専用のニューラル ネットワーク モデルに変換されて処理されると述べています。 140,000 トークン コンテキストのスケールでは、単一トークンの書き込み時間が GPU のみに依存する場合の 279 ミリ秒から 176 ミリ秒に短縮され、長いコンテキスト シナリオでの動作効率がさらに向上します。
ただし、このソリューションには制限がないわけではありません。開発者らは、iPhone は主に事前入力段階のパフォーマンス向上に貢献しているが、64K 未満のテキスト生成タスクでは、実際の推論作業のほとんどは依然として主に Mac によって行われていると指摘しました。さらに、このソリューションには特別に開発されたソフトウェアのサポートが必要であり、現時点では一般ユーザーによる直接展開には適していません。
それにもかかわらず、この実験はローカル AI コンピューティングにおける消費者グレードの Apple デバイスの可能性を示しています。モバイル チップのパフォーマンスが向上し続けるにつれて、将来的にはスマートフォン、タブレット、パーソナル コンピューター間でより柔軟な協調コンピューティング システムが形成され、それによって大規模な人工知能モデルを実行するための単一デバイスのハードウェア構成への依存が軽減される可能性があります。
コメント