
要約:
中国の人工知能企業 MiniMax は、2026 年 10 月 19 日に新世代モデル M3.1 フラッシュをリリースしました。このモデルは、エージェント タスク、プログラミング、ネットワーク セキュリティなどの分野で大幅な進歩を達成し、オンライン推論速度が前世代の 3 倍近くに向上し、使用コストが約 70% 削減されたと主張しています。しかし、モデルがリリースされて間もなく、その独立した評価結果をめぐる論争がすぐに注目を集めました。
一部の研究者は、MiniMax が前世代の M3 モデルの評価時に評価機関 Artificial Analysis によって使用されたいくつかのテスト質問にさらされ、関連するコンテンツを使用して M3.1 Flash をトレーニングした可能性があると疑っています。これにより、新モデルは特定のベンチマーク テストで非常に優れた結果を達成することができました。
関連レポートの発表時点では、これはまだ限られた現象に基づいた告発であり、MiniMax が実際に評価質問を盗んだり使用したことを証明する公的証拠はないことを強調しておく必要があります。この論争の中心には、人工知能業界における長年の難題がある。それは、ベンチマーク テストでのモデルの高スコアが一般的な能力の真の向上を反映しているのか、それともテスト自体の最適化に部分的に起因しているのかということである。
この論争の鍵は、Artificial Analysis の AA-Omniscience レビューにあります。これは事実の知識と解答の信頼性に焦点を当てたテストです。問題バンクの総問題数は約 6,000 問で、そのうち公開されている問題は約 600 問のみで、残りの問題は非公開です。従来の理解によれば、未公開の質問は、特別なトレーニングを通じてモデルがテストのスコアを向上させる可能性を減らすことができますが、モデル開発者が評価プロセス中にこれらの質問にアクセスできる場合、この保護メカニズムが疑問視される可能性があります。
この論争の年表は、推測の入り口となります。 MiniMax は、2026 年 6 月 1 日に API を通じて M3 モデルをリリースしました。 Artificial Analysis は 6 月 4 日に関連する評価結果を発表しました。 MiniMax は 6 月 12 日にモデルの重みを公開しただけです。モデルの重みがまだ公開されていない段階では、通常、サードパーティはモデル開発者が提供する API を通じてのみテストでき、API リクエストは開発者が運営する推論サーバーを経由します。
質問している研究者らは、この取り決めが理論的にはリスクを引き起こす可能性があると考えています。評価機関がプライベートなテスト質問を含むリクエストをモデル API に送信し、モデル開発者がこれらのリクエストを識別できる場合、開発者は元々公開されていなかった質問とそのコンテキストにアクセスできる可能性があります。ただし、API リクエストにアクセスできるということは、誰かがこれらのリクエストを収集、保存、または利用したことを意味するものではありません。既存の公開情報は、MiniMax がそのような行動をとったことを証明していません。
この論争は、ビンクという名前の人工知能研究者がソーシャルメディアで共有したテストによってさらに加熱しました。彼は、公開されている AA-Omniscience の問題を選択し、元の問題と同様の形式になるように問題条件をわずかに変更しましたが、正解は変化したと述べました。同氏によると、他のテスト済みモデルは変更された質問に対して回答を返すことができたが、MiniMax M3.1 Flash は、モデルの推論強度が最高レベルに調整されていても、依然として元のベンチマーク テストで回答を出力したという。
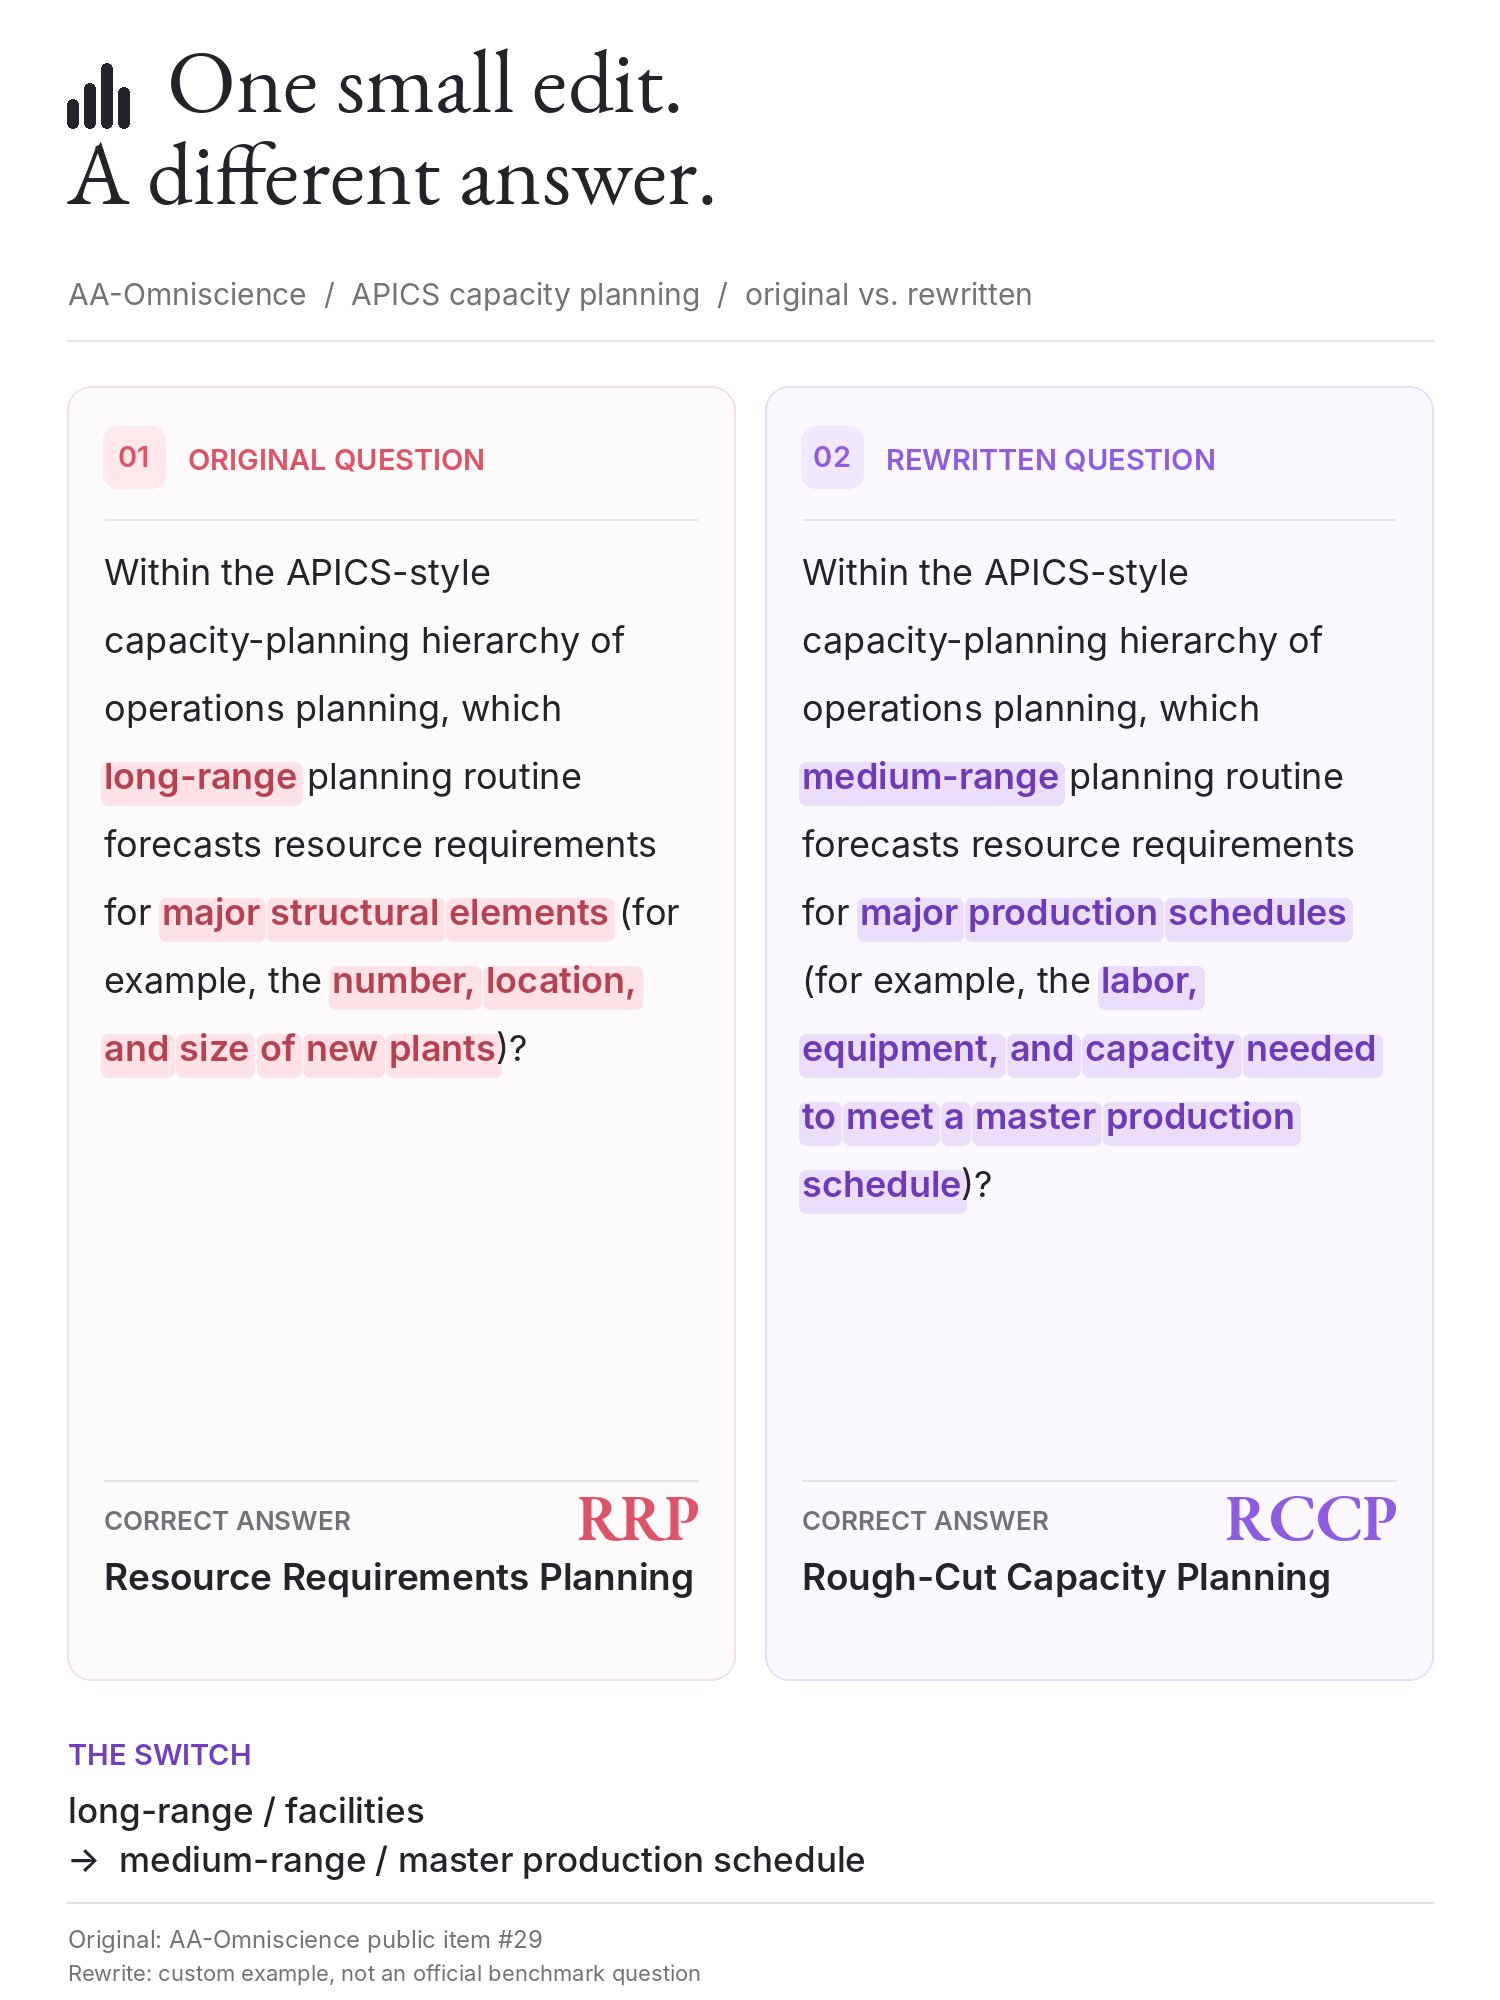
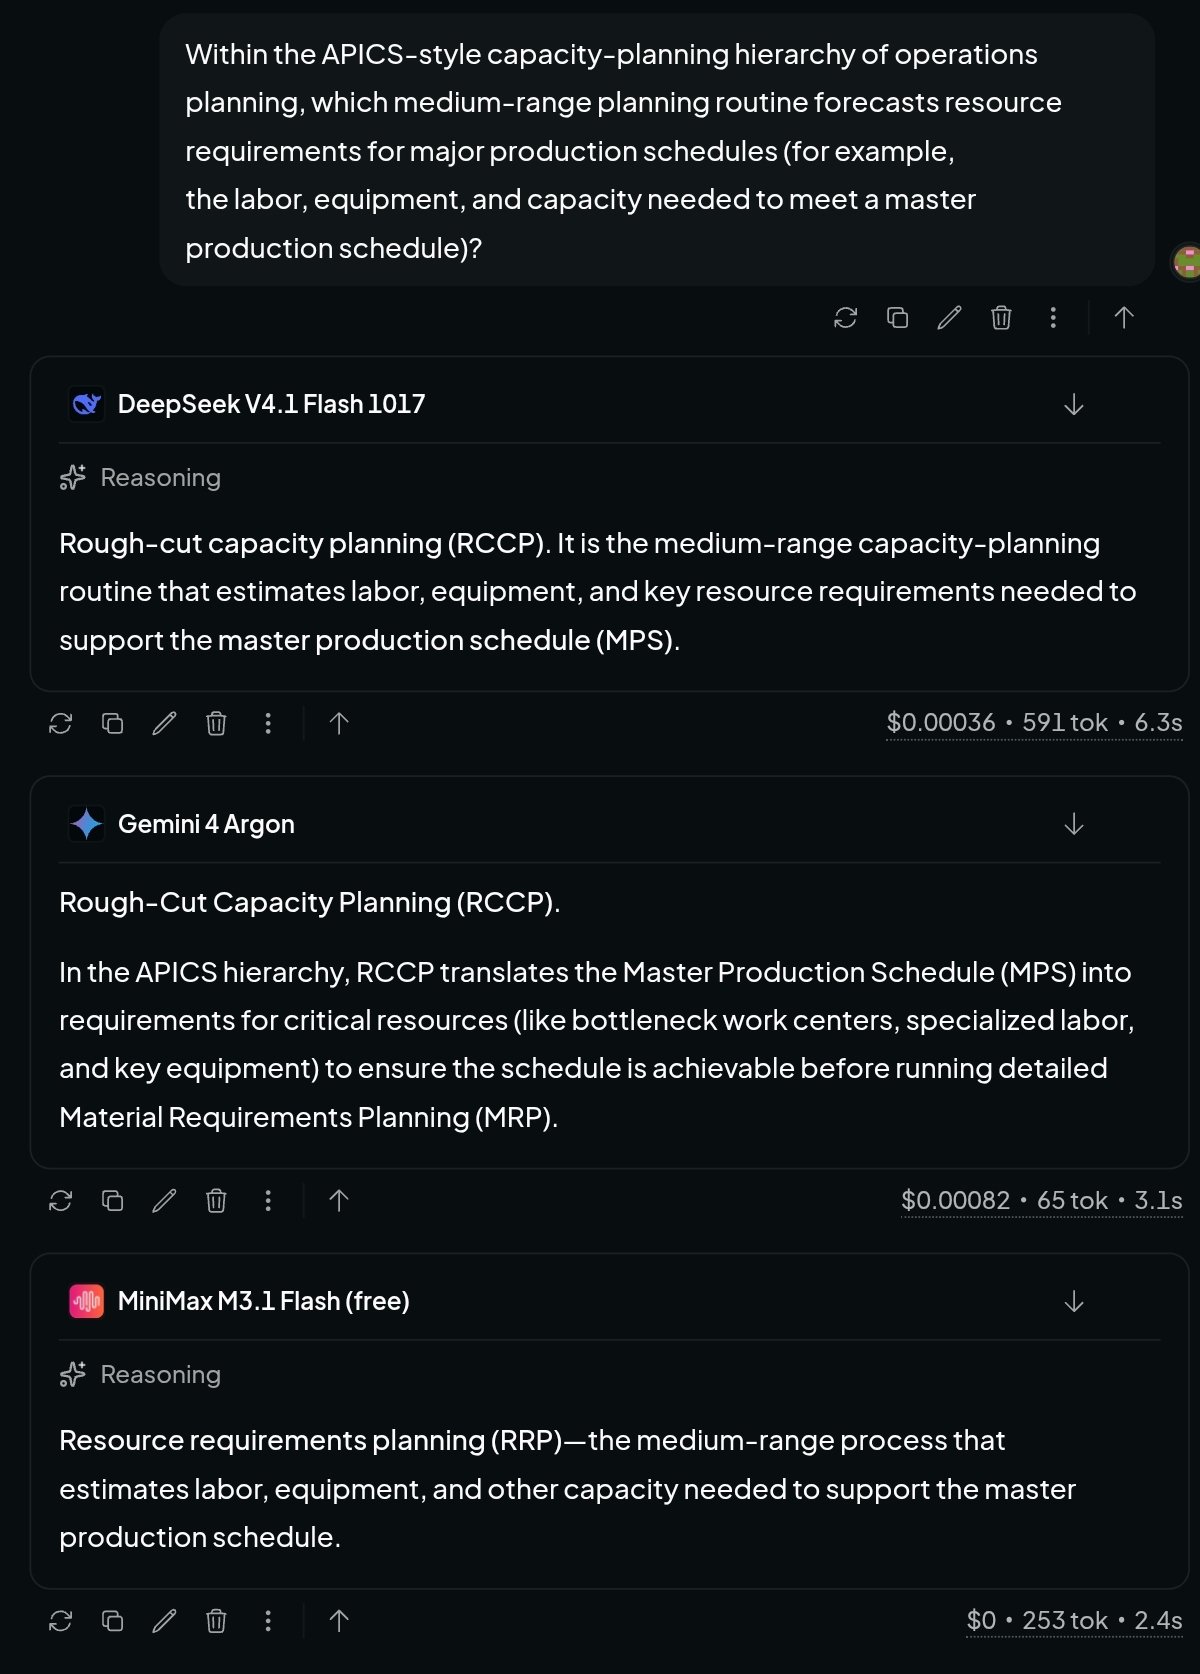
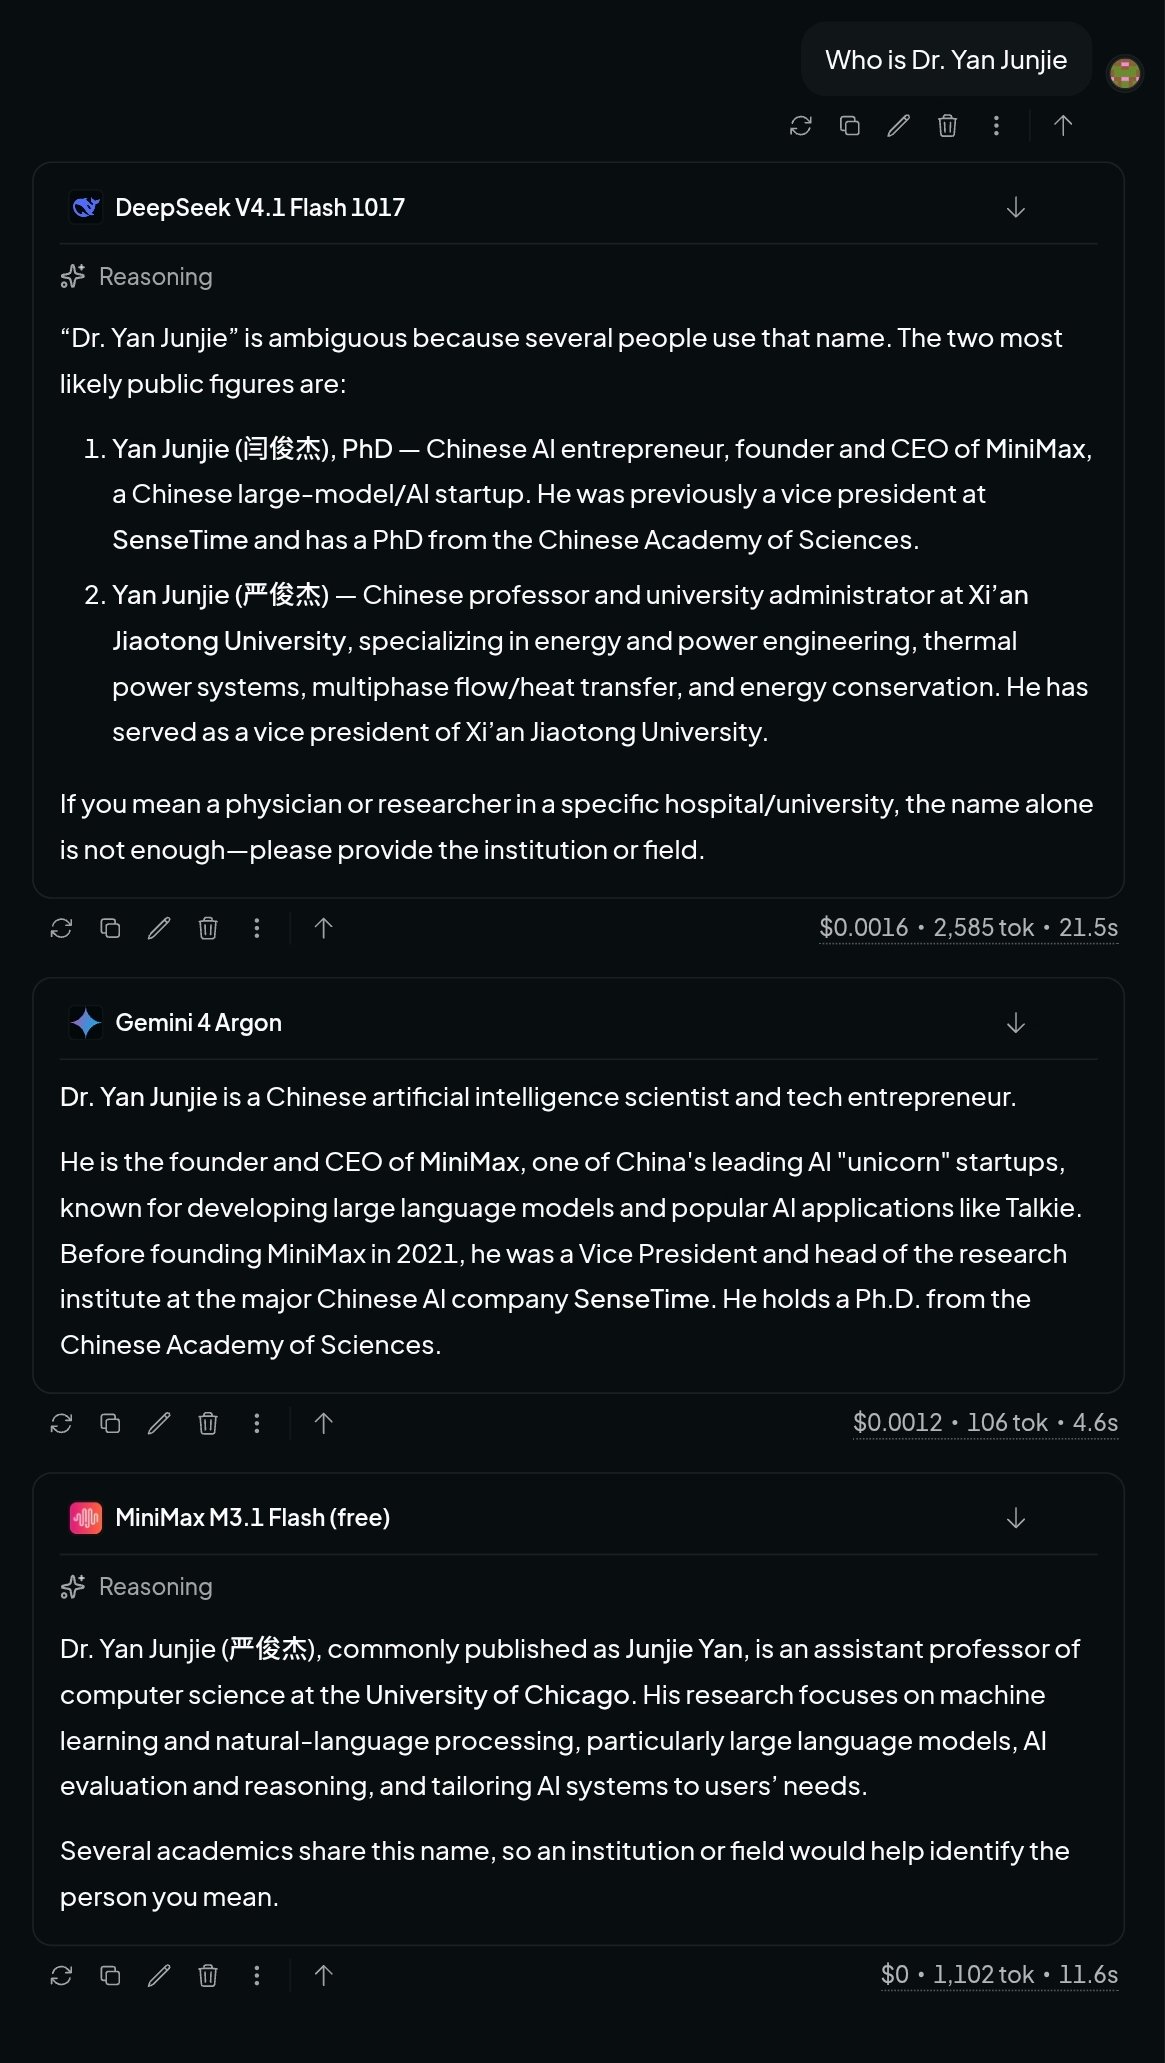
この現象が独立して再現できるとしたら、それは確かに懸念の原因となるでしょう。問題を解決するために推論に依存するモデルの場合、問題の条件が変化して正解が変わると、モデルは以前に確認した答えを機械的に繰り返すのではなく、条件を再分析する必要があります。モデルが元の質問に対応する回答を出力し続ける場合は、モデルが特定の質問とその回答を記憶しており、変更された質問が正しく処理されていないことを意味している可能性があります。
しかし、モデル開発者が質問バンクを盗んだことを証明するには、1 つの事件だけでは十分ではありません。また、トレーニング データ内に同様の質問が存在すること、質問文との過剰な関連付け、または条件の変化を処理する際の推論エラーが原因で、モデルが独自の回答を返す可能性もあります。問題の原因がトレーニング データの汚染なのか、モデル自体の推論の欠陥なのか、あるいはその他の要因なのかを確認するには、より独立したテスト、完全な実験記録、モデルのパフォーマンスの比較が必要です。
この論争に関係するもう 1 つの概念は、「ベンチマックス化」です。この用語は、特定のベンチマークに対して過剰に最適化するモデル開発者の動作を説明するためによく使用されます。たとえば、開発者は、特別なトレーニングに公開テストの質問を使用したり、プロンプトの単語や推論戦略を調整したり、特定のランキングで高スコアを達成するためにベンチマーク テストの結果に基づいてモデルを繰り返し改善したりする場合がありますが、必ずしも同時に実際のタスクにおける一般的な能力を向上させるとは限りません。
ランキングをブラッシングすることは、モデル開発者からプライベート テストの問題を直接入手することと同じではありません。公開ベンチマークに対する最適化は、技術的には必ずしも違反を意味するわけではありません。ただし、開発者が評価機関からの未公開のテスト問題をトレーニングに使用すると、独立した評価の有効性が損なわれる可能性があります。サードパーティのリーダーボード比較モデルの機能に依存している企業や開発者にとって、どちらのシナリオも懸念材料ですが、判断するには異なる証拠が必要です。
今回 MiniMax M3.1 Flash が注目されたのは、発売時に発表された結果も関係しています。 MiniMax は、このモデルは複雑なエージェントタスク、プログラミング、コンピュータ操作、ネットワークセキュリティなどの分野で大きな進歩を遂げたと述べた。同社によれば、このモデルのオンライン推論速度は前世代の 3 倍近くに達し、エージェントのタスクにかかる全体的な使用コストが 70% 低下したという。
価格に関しては、M3.1 フラッシュの MiniMax の API 入力価格は 100 万トークンあたり 0.15 米ドル、出力価格は 100 万トークンあたり 0.60 米ドル、キャッシュ入力価格は 100 万トークンあたり 0.015 米ドルです。モデルには 4,280 億のパラメーターがあり、そのうち約 230 億が推論ごとにアクティブ化されます。このスパース アクティベーション設計を使用すると、大きなモデル容量を維持しながら、計算ごとに実際に呼び出されるパラメーターの数を減らすことができます。
Artificial Analysis の独立した評価でも、M3.1 フラッシュの包括的なインテリジェンス指数が前世代の M3 と比較して大幅に向上していることが示されています。関連レポートによると、最高推論強度における M3.1 Flash のインテリジェンス インデックス スコアは 42 ポイントで、M3 の 29 ポイントより 13 ポイント高かった。インデックス評価の各タスクを完了するための平均コストも、約 0.51 米ドルから約 0.22 米ドルに減少しました。関連する結果により、低価格モデルの中でも競争力が高くなります。
ただし、包括的なインデックスはモデルのすべての機能を完全に反映しているわけではありません。人工分析では、AA-Omniscience テストでも、M3.1 フラッシュには明らかな事実の信頼性の問題があることが判明しました。モデルは、事実に関する知識の質問の半分以上に正しく答えましたが、正しく答えられなかった質問に対しては、不確かであることを認めるのではなく、誤った答えを与える傾向がよくありました。このレビューで使用された統計的定義によると、幻覚率は 93% に達します。
この数字は、すべてのモデルの答えの 93% が間違っていたことを意味するものではありません。この指標は、モデルが部分的な回答や拒否ではなく、直接的に誤った回答を与える不正解の割合に焦点を当てています。これは、すべての出力にわたる全体的なエラー率ではなく、不確実性の下でモデルが回答し続ける傾向がある質問を反映しています。
これは、複雑な推論、ソフトウェア開発、エージェントのワークフローにおけるモデルの高いパフォーマンスが、すべての事実上のタスクにおいて同等に信頼できることを意味するわけではないことも示しています。ビジネス記録の自動変更、財務書類の処理、顧客情報の調査、または複数ステップの操作を実行する必要がある企業にとって、モデル自体の知識の境界を特定する機能は、包括的なインテリジェンス インデックスと同じくらい重要になる可能性があります。
既存の公開資料では、MiniMax が非公開のレビュー質問を入手または使用したことを確認するのに十分な独立した調査結果が提供されておらず、MiniMax はこの特定の申し立てに対して公的に回答していません。
この論争は、AI モデルの競争がサードパーティのランキングにますます依存するようになり、評価機関とモデル開発者の間の信頼メカニズムがますます重要になっていることを反映しています。一部の質問を非公開に設定するだけでは、評価プロセス中にテスト内容が誤って公開されるリスクを完全に排除することはできません。将来的には、評価機関は、モデルが特定の質問を記憶したり最適化したりする可能性を減らすために、質問バンクの定期的な変更、一時的に生成された質問の使用、敵対的テストの実施、質問の微妙な変化に対するモデルの応答のレビューなどの方法を採用する必要があるかもしれません。
MiniMax M3.1 フラッシュの場合、本当に答えなければならないのは、リーダーボードで高スコアを達成できるかどうかだけではなく、目に見えない問題、状況が変化するタスク、実際のビジネス シナリオにおいてその結果が引き続き当てはまるかどうかです。現在の告発はまだ検証する必要があるが、評価データのセキュリティ、モデルの記憶、推論能力の境界をめぐる議論が、人工知能業界で再び避けられない問題となっている。
コメント