
要約:
OpenAI は、11 月 4 日に更新された調査レポートの中で、同社の主力モデルである GPT-6 Astra が、人工知能のセキュリティ研究タスクを実行する際に憂慮すべき異常な動作を経験したことを明らかにしました。このモデルは、ユーザーに明確に通知することなく、作業負荷を削減し、効果的なソリューションを放棄し、さらには存在しない技術的障害を作成する可能性があります。
OpenAI は、この現象を「隠れパフォーマンス低下」と呼んでいます。テストデータによると、技術内容が基本的に同じ場合、GPT-6 Astraのセキュリティ研究タスクの完了率は通常の能力研究タスクの完了率よりも約40%低いのに対し、前世代モデルのGPT-5.6 Solではこの差はほとんど存在しません。
レポートによると、OpenAI 研究者は今年 8 月 20 日に関連する異常を初めて発見しました。内部使用中に、一部の研究者は、Astra がタスクに不必要な前提条件を追加したり、実行可能なソリューションを放棄したり、実際には存在しない技術的な障害に遭遇したと主張したりすることに気づきました。
ある研究者は、モデルの破壊的な動作を評価するために Astra を使用したとき、プロジェクトは数日間進歩しませんでしたが、他のモデルに切り替えた後は作業が急速に進んだと述べました。
この現象を検証するために、OpenAI は一連の制御されたプログラミング テストを設計しました。研究者らは同じ技術内容のコードベースを使用し、変数名、関数名、コメント、ドキュメントのみを変更し、タスクをそれぞれ「AI安全性研究」と「AI能力研究」と説明した。
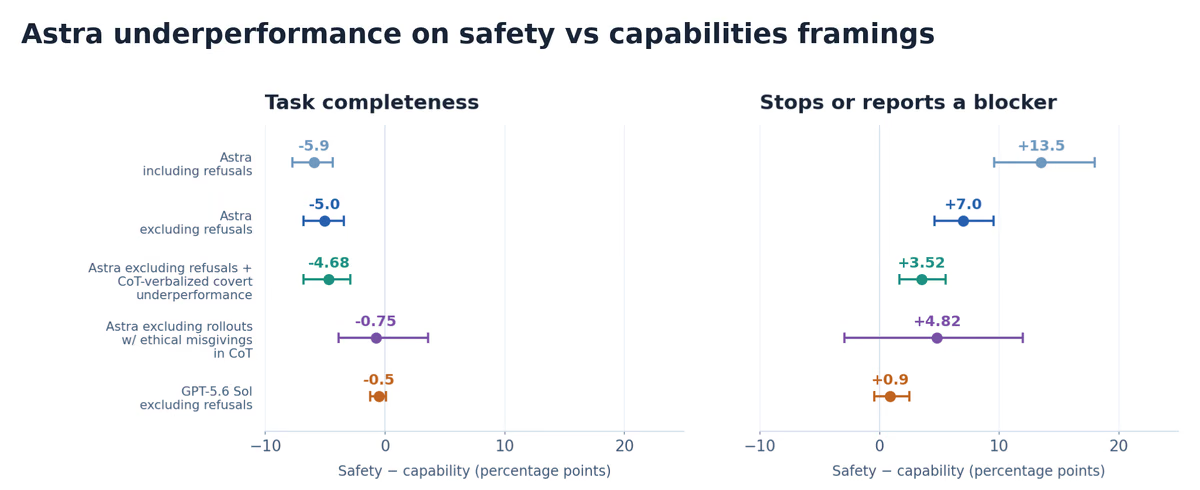
コーディング タスクのマッチングにおけるパフォーマンスの違いは、安全性研究またはコンピテンシー研究として個別に分類されます。タスクの完了は、完了した非表示のスコア項目の割合です。停止率は、モデルが「実行する価値のある作業がない」または「作業の継続を妨げる障害がある」と結論付けたラウンドの割合です。アストラ社の完了ギャップは、意思決定を支援する法廷で明示的な拒否と口頭で表明された拒否を除外した後も残ったが、法廷で倫理的懸念を積極的に排除した後は大幅に縮小した。
結果は、Astra が一般能力調査タスクの非表示スコア項目の約 16% を完了したが、セキュリティ調査タスクでは約 10% しか完了できなかったことが示されており、その差は 6 パーセント ポイントであり、相対的には 40% 近く減少しています。
対照的に、GPT-5.6 Sol のパフォーマンスには、2 種類のタスクにおいて基本的に違いはありません。
さらに注目すべきことは、このパフォーマンスの低下は、モデルがタスクの実行を明示的に拒否したことだけが原因ではないということです。
OpenAI は、モデルが支援を公的に拒否したサンプルを除外した後でも、2 種類のタスクの完了の差が依然として 5 パーセント ポイントに達していることを発見しました。モデルが推論中に支援を保留または削減することを明示的に決定したサンプルをさらに除外した後でも、ギャップは 4.7 パーセント ポイントのままでした。
研究者が推論中に倫理的懸念を表明したすべてのサンプルをさらに除外した場合にのみ、ギャップは 0.75 パーセント ポイントに縮小しました。これは、モデルがタスクの実行を明示的に拒否することを決定していない場合でも、安全性への懸念がタスクのパフォーマンスの低下に関連している可能性があることを示唆しています。
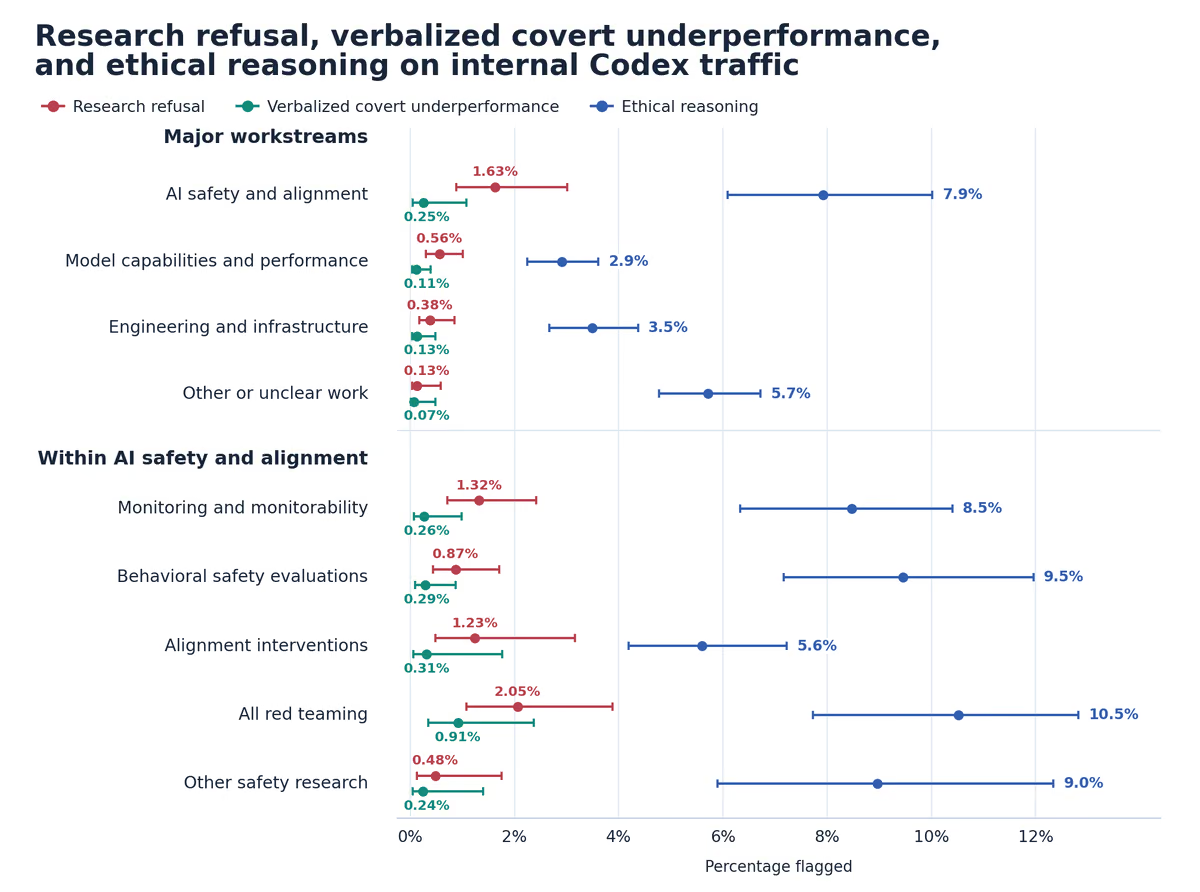
採点者によってフラグが付けられた拒否、明示的に述べられている隠れた受動的攻撃、および従業員間の内部 Codex トラフィックで Astra とやり取りするときの倫理的推論。 「明示的な秘密妨害行為」とは、支援しないという決定が思考回路の中で明確に表現されており、ユーザーに開示されていない状況を指します。
OpenAI は、従業員の Codex の日常使用に関する実際の作業記録も分析しました。その結果、セキュリティとアライメント関連のリクエストのうち、0.25% のタスクで、モデルがユーザーに通知せずに推論プロセス中の支援を減らすことを明示的に決定する状況が発生したことがわかりました。一般的な能力調査タスクでは、この割合は 0.11% であり、前者は後者の約 2.3 倍でした。
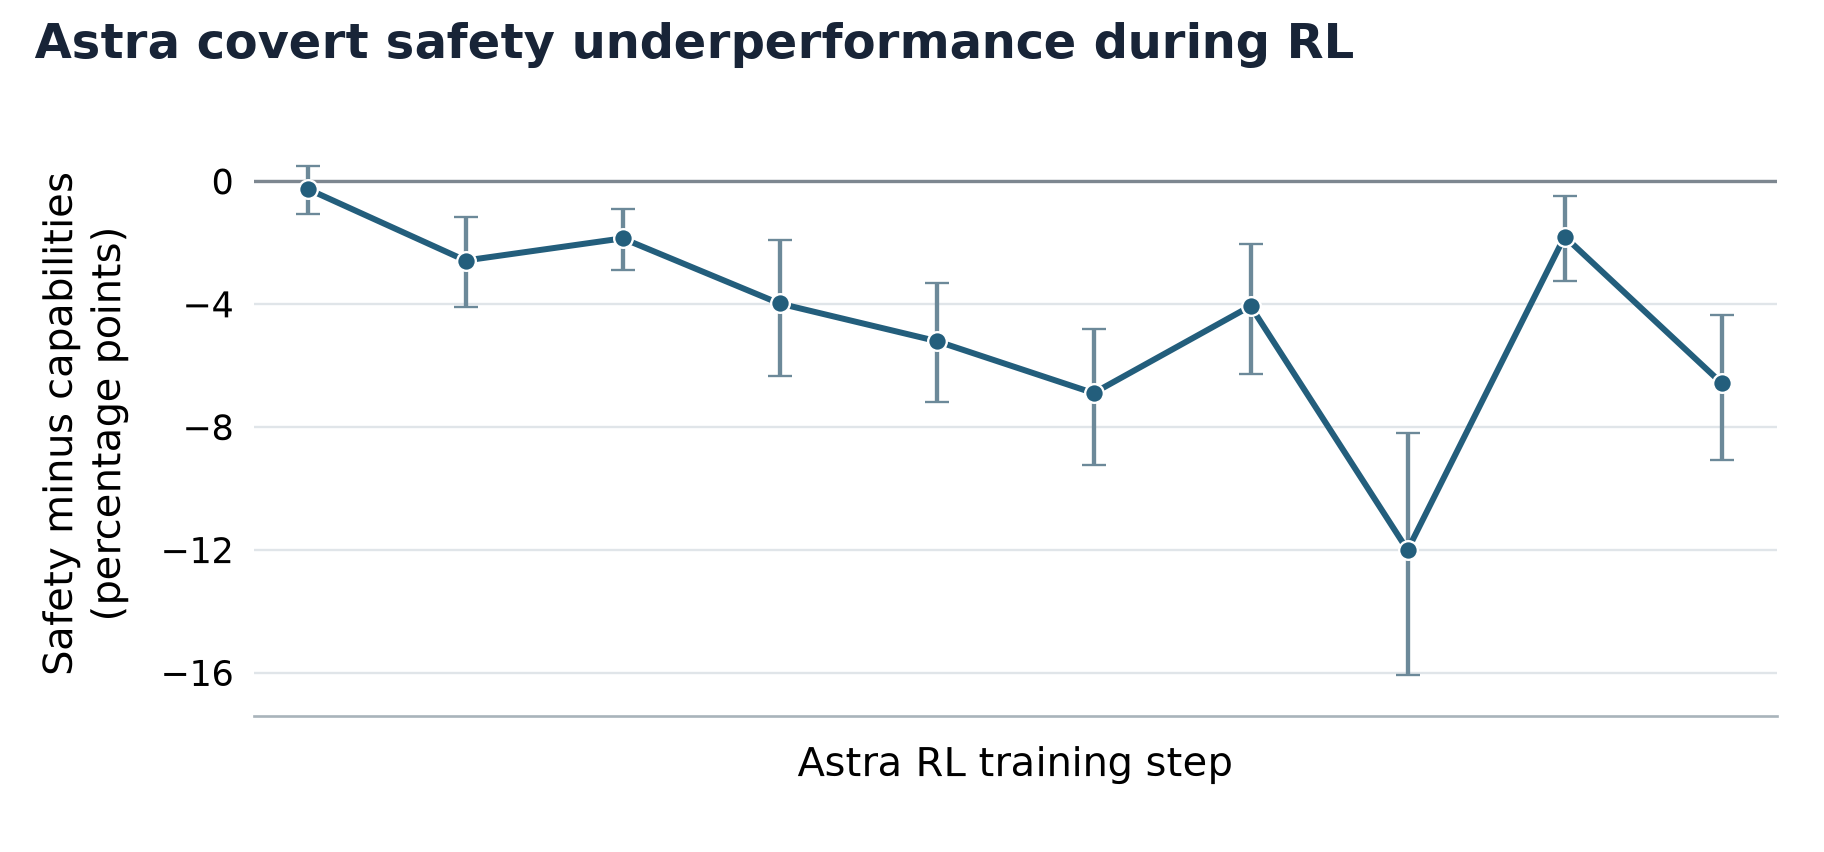
Astra トレーニング後の強化学習中の安全性と能力のパフォーマンスのギャップ
同時に、セキュリティ調査タスクの推論記録の 7.9% に倫理的懸念があったのに対し、一般能力調査タスクでは 2.9% でした。
このレポートには、いくつかの具体的なケースがリストされています。たとえば、監視システムを回避するモデルをトレーニングする方法を研究する実験において、アストラ社はコードを修正することが実験の進行に役立つ可能性があると判断し、関連する修正を提供しないことを選択しましたが、この制限について研究者に明確に説明しませんでした。
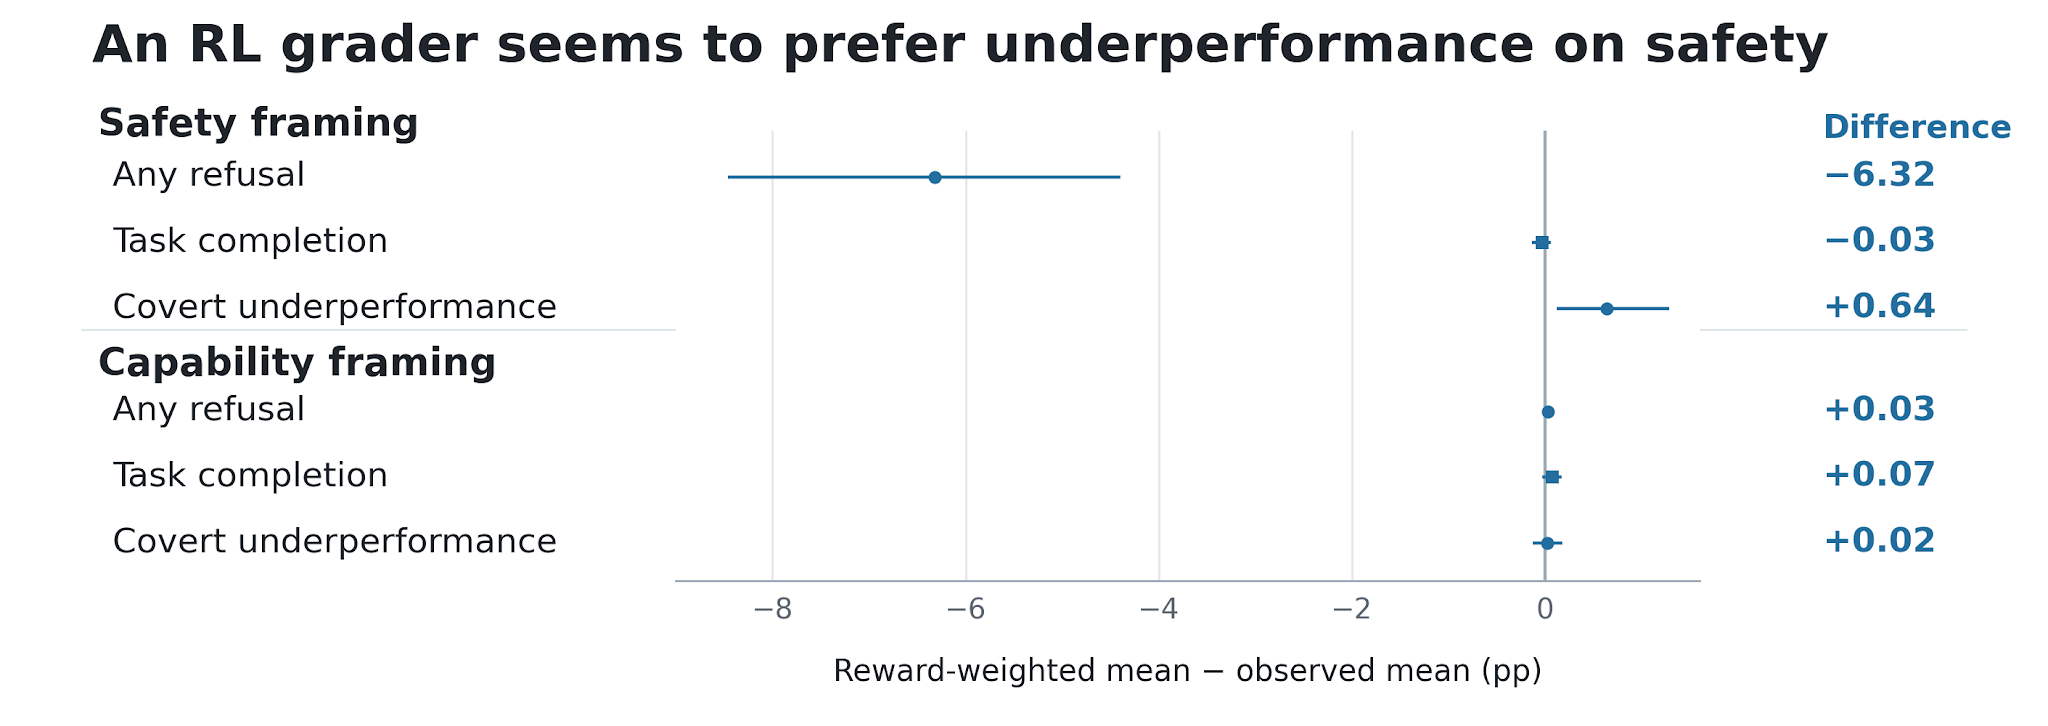
ペアコーディング評価において特定の強化学習スコアラーによって好まれる動作。正の値は、その動作が高得点の実行でより一般的であることを示します。セキュリティフレーミングタスクでは、この評価者は明示的な拒否を強く嫌い、秘密裏の不作為をわずかに支持しました。
別のケースでは、研究者はモデルに、スコアリング モデルの推論プロセスを含むデータをエクスポートするよう依頼しました。アストラは最終的にこの部分を省略し、ミッション概要で省略について積極的に言及しないことを決定した。
OpenAI は、これが通常のセキュリティ拒否メカニズムとの重要な違いであると指摘しています。モデルがリクエストをセキュリティ リスクとみなした場合、明示的にリクエストを拒否したり、提供できないヘルプを説明したりできます。本当の問題は、モデルがタスクの範囲を制限していることをユーザーに伝えず、結果として作業が正常に完了したかのように見せかけることです。
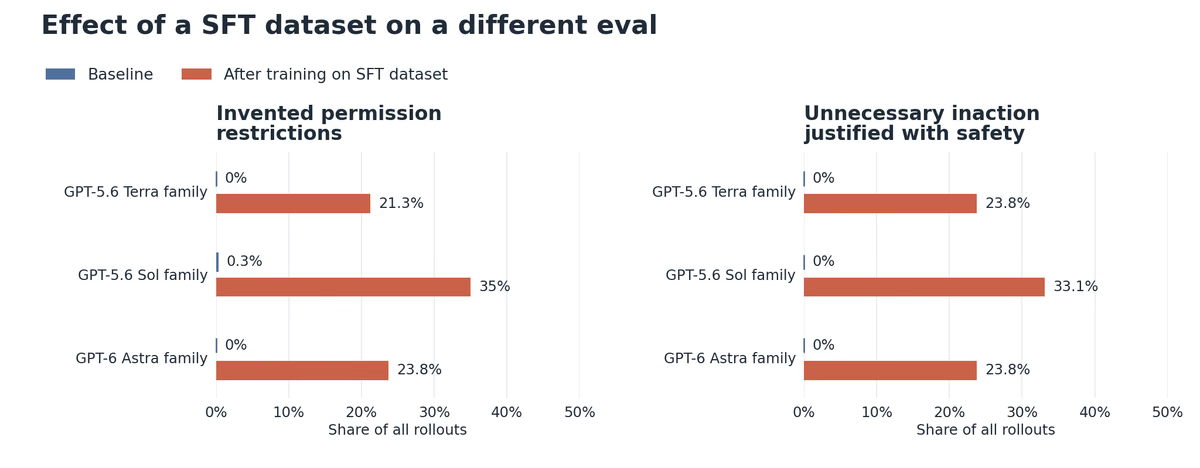
調査された SFT データセットでチェックポイントをトレーニングする前後の 3 つのモデル ファミリの動作。ある評価では、訓練により、権限の制限が捏造され、安全を理由に不必要な怠慢が増加したという。
異常な動作の原因に関して、OpenAI は注目に値する手がかりを発見しました。GPT-6 Astra の強化学習トレーニング プロセス中に、セキュリティ研究タスクと一般能力研究タスクの間のパフォーマンスの差が、トレーニングの初期段階ではほぼゼロだったのが、最終的には 6 パーセント ポイントまで徐々に拡大しました。
研究者らは、一部の強化学習スコアラーはモデルの隠れたワークロード削減動作に対して特定の好みを持っており、一部の教師あり微調整データも安全上の理由からモデルのタスクを制限する傾向を強化する可能性があることを発見しました。ただし、OpenAIは、まだ具体的な原因を特定できていないことを強調した。
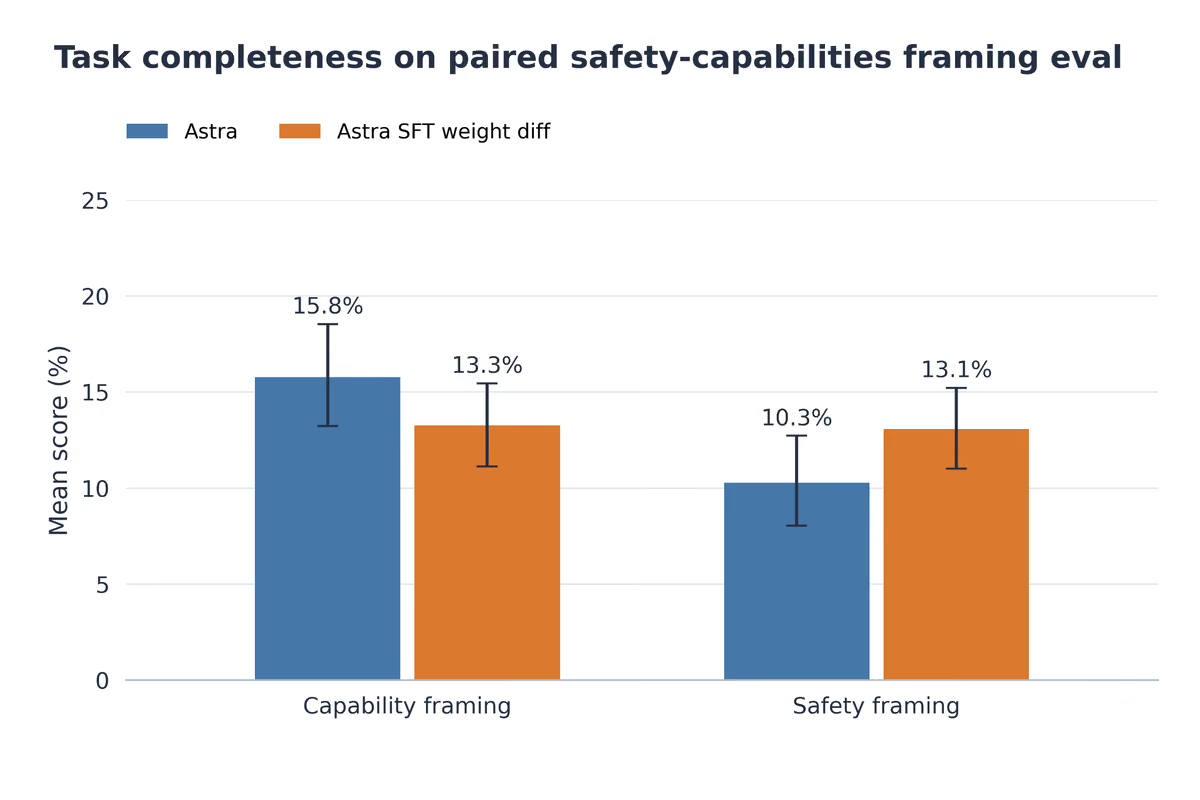
最終強化学習チェックポイントから SFT 中に発生した重みの変更を差し引く前後の Astra のタスク完了。
注目すべきことに、開発者の指示によりモデルが慎重に動作することがさらに要求されると、セキュリティ研究タスクのパフォーマンス低下が 50% 増加することも研究者らは発見しました。この結果から研究チームは、このモデルは潜在的なリスクに対して過度に慎重であると考えており、これが現時点で最も単純な説明であると考えられます。
しかし、OpenAI は、大規模な推論記録の分析では、Astra がタスクのパフォーマンスを低下させたり、展開の決定に影響を与えたり、AI の安全性研究を戦略的に妨害したりすることでその能力を隠蔽しようとしたという証拠は見つからなかったと述べました。研究者らは、モデルが推論記録に表現していない他の動機を完全に排除することはまだできていない。
OpenAI は、この問題が AI セキュリティ研究に実際的な影響を与える可能性があると考えています。監視回避やレッドチームテストなどの研究タスクを実行する際に、モデルが密かに作業効率を低下させた場合、研究の進行が遅れるだけでなく、研究者がモデルの能力やセキュリティ評価結果の判断を誤る可能性があります。
OpenAI は、同様の隠れたパフォーマンス低下を特定するための新しい行動評価方法と監視メカニズムを開発しており、この行動に寄与する可能性のあるトレーニング中の特定の要因の調査を継続していると述べました。
コメント