
要約:
DeepSeek もパラメータ競争に参加しました。 The Information によると、DeepSeek は現在、約 2 兆のパラメーターを使用して新しいモデルをトレーニング中です。 Liang Wenfeng 氏はまた、最近の投資家会議で、同社の次のステップはモデルをパラメータ 8 兆まで押し上げ続けることであると述べました。 1年前、8兆という数字はまだ想像を絶する数字でした。
しかし現在、Kimi K3 は 2 兆 8,000 億のパラメーターに達しています。 Byte は、最大 10 兆のパラメータに達する可能性のある新しいモデルを事前トレーニングしています。アリババはまた、次世代モデルではパラメータが 5 兆から 10 兆に達すると公言しています。 Anthropic はモデルパラメータを明らかにしていないが、FT は以前、同社の最新フラッグシップ Mythos 5 には約 8 兆個のパラメータがあるという業界の推定値を引用していた。
大きなモデルは円を描いて一周し、誰がより大きいかを競い始めました。
今回のみ、全員がロールアウトするパラメータは、前回のスケーリング ラウンドと同じパラメータではなくなりました。
DeepSeek が今年 4 月に V4-Pro をリリースしたとき、公式に開示された規模は、合計パラメータが 1 兆 6,000 億、アクティベーション パラメータが 490 億でした。
その後の計画は 8 兆人民元で、これは V4-Pro の 5 倍に相当します。
これは、DeepSeek に関しては非常に珍しいことです。結局のところ、DeepSeek はパラメータの観点からではなく、昨年 AI 業界全体に最も深い印象を残しました。
これにより、AI 業界では、おそらく最先端のモデルでは GPU を無限に消費する必要はないのではないかという再議論が巻き起こりました。
2024 年末に V3 がリリースされると、DeepSeek はトレーニングの請求額を意図的に検討します。合計パラメーターは 6,710 億、トークンごとに有効化されるパラメーターは 370 億、完全なトレーニングには 278 万 8,000 GPU 時間が消費されます。 GPU 時間あたり 2 米ドルで計算すると、公式トレーニング費用はわずか 557 万 6,000 米ドルになります。
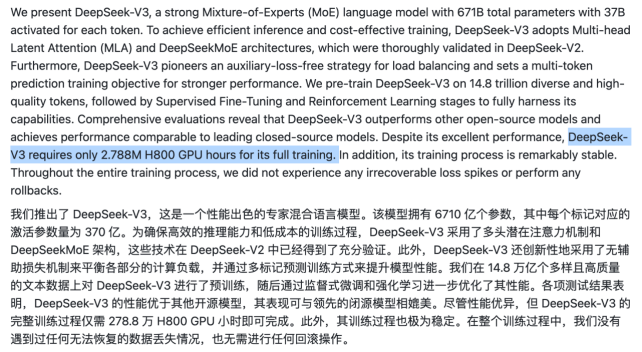
この数字とその背後にある効率は、後に DeepSeek にとって最も重要なラベルの 1 つになりました。
DeepSeek には、OpenAI や Anthropic のような高度な GPU が豊富にありません。同社は長い間、自己輸血の数値化を梁文峰氏の環芳氏に依存しており、外部からの資金提供を受け入れていない。その条件によってルートが決まります。資金と計算能力には限りがあるため、アーキテクチャ、トレーニング、推論の効率からパフォーマンスを最大化する必要があります。
しかし今、状況は変わりました。
DeepSeek は、今年 6 月の設立以来最初の外部資金調達ラウンドを完了し、約 74 億米ドルを調達しました。現在、約500億人民元(約75億米ドル)の第2回資金調達ラウンドが最終段階に入っており、これは評価額約5,000億人民元に相当する。この資金調達が成功すれば、DeepSeekの累計外部資金調達額は数カ月以内に150億米ドル近く、約1000億元に達することになる。
同時に、DeepSeek は科学技術イノベーション委員会の IPO の準備のために CITIC Securities を雇用しました。この新しい資金は明らかにコンピューティング インフラストラクチャ、モデル開発、人材投資に使用されます。 9月21日、元Hillhouse Venture PartnersパートナーのYan Wentao氏がDeepSeekに正式に入社しCFOを務め、会社設立以来3年間のCFO空席は解消された。
これまで、DeepSeek は限られた資金とコンピューティング能力を使って、可能な限り優れたモデルを作成していました。現在、資金調達と上場が進められています。より多くの資金があれば、コンピューティング能力も高めることができます。
条件が満たされると、DeepSeek はパラメータの大胆な展開も開始します。
これは効率の追求とは矛盾しません。効率が高ければ同じお金で規模を拡大できる。
過去 2 か月間で、最先端モデルのパラメータの合計スケールは大幅に増加しました。
この競争を再びスポットライトに押し上げているのが、The Dark Side of the Moon です。今年 7 月、Kimi K3 は総パラメータ数 2 兆 8,000 億、活性化パラメータ数 1,040 億を達成しました。 K3は現在も正式リリースされているオープンウェイトモデルの中で最大のパラメータースケールを持っています。
大きいだけではありません。公式評価では、K3 の GPQA Diamond は 93.5 に達し、ターミナルベンチ 2.1 は 88.3 に達し、同時期の GPT-5.6 Sol や Claude Fable 5 に非常に近い値を記録しました。その規模は兆に達し、その実績は第一段階に達しています。
8月、Byte社がさらに規模を拡大する計画を立てていることが明らかになった。
8 月 6 日、「LatePost」は、Byte が Seed Foundation の責任者 Xiang Liang の主導で、5 兆を超えるパラメータを備えた新しいモデルのトレーニングについて話し合っていることを初めて明らかにしました。レポートによると、Byte は内部的に、既存の規模に追いつき続けるよりも、パラメータの規模を一度に競合他社の数倍に押し上げる方が良いと考えているようです。
その翌日の 8 月 7 日、FT は事情に詳しい関係者の話として、Byte が事前トレーニングしている新しいモデルの規模は最大 10 兆パラメータに達する可能性があると報じました。ロイターが追跡調査を行った際、Anthropic 社の最先端の Mythos とも比較しました。後者はパラメーターのスケールを明らかにしていませんが、業界の推定値は約 8 兆に達しています。 Byteの新モデルが10Tに達すれば、現在Mythosが流通している規模を超えることになる。
現在、最先端モデルの議論では、5Tを超える非常に大きなパラメータ量が繰り返し登場し始めています。
本日、Alibaba CEO の呉永明氏は、次世代モデルでは 5 兆から 10 兆のパラメータを達成する計画であると公式に発表しました。 DeepSeek は、フォローアップ目標を 8T に設定しながら 2T モデルをトレーニングしています。本部研究所が、能力の上限に影響を与えるための重要な手段として、より大きな総パラメータスケールを再び考慮していることが理解できます。
パラメータを開示していないアメリカのクローズドソースモデルであっても、監視の外から逃れることはできません。 Anthropic の Mythos は部外者によって 8T と推定されています。 GPT-4 時代以来、OpenAI はモデルのスケールを公開していませんが、コミュニティでは Astra が 10T MoE に達したという噂があります。
パラメータの数は、ゲーム パネルの戦闘力の値と同じように、その魅力を失ったことはありません。パラメータの数がすべてを表すことはできないことはわかっていますが、パラメータの数は常に最も直感的で抑圧的な数値になります。
実際、大規模モデル業界はしばらくの間、パラメータについて話すことをあまり好んではいませんでした。
過去 2 年間で、蒸留、小規模モデル、MoE、強化学習、推論時間の計算が交代で行われました。モデルメーカーは、数千億、数兆のパラメータを持っていることを誇示するのではなく、パフォーマンス、コスト、効率について積極的に話します。モデルを大きくするだけで、お金はあるけど使う場所がないように見えてしまいます。
今日、パラメータ量が再び引き上げられ、再び最先端モデルの「最前線」になりました。
しかし、今日の 5T、8T、および 10T は、以前のスケーリング ラウンドでの「パラメータが多いほどモデルが大きくなる」ものと同じものではなくなりました。
パラメータ量が再びテーブルに戻される最も直接的な理由は、超大規模モデルの主流のアーキテクチャが変化したことです。
かつての大規模モデルは基本的にパラメータ規模と計算量が結びついたDenseアーキテクチャが主流でした。簡単に言うと、モデルにパラメータがいくつあるかを意味し、基本的にすべての計算でパラメータを一緒に入力する必要があります。パラメータが多いほど能力の上限は高くなる傾向にありますが、学習や推論のコストも増加します。
現在、MoE、専門家の混合、および専門家の混合アーキテクチャを使用する大規模モデルがますます増えています。
むしろ多くの専門家がいる会社のようなものです。モデルには数百人または数千人の専門家が含まれる場合がありますが、各タスクに取り組むために選択されるのはそのうちのごく一部だけです。たとえば、Kimi K3 には合計 2.8T のパラメータがありますが、各トークンは 104B (約 3.7%) のみをアクティブにします。 DeepSeek V4-Pro には合計 1.6T のパラメータがあり、各トークンは 49B (約 3%) のみをアクティブにします。
現在、モデルに 5T、8T、さらには 10T のパラメータがある場合、トークンを生成するたびにこれらの 10T パラメータを実行する必要があるというわけではありません。
モデルが保持できる量と、毎回計算する必要がある量は、2 つの異なる数値になります。
パラメータは、モデルが知識、パターン、機能を伝達するために使用するスペースとして理解できます。合計パラメーターが大きくなるほど、理論的にはモデルがより複雑な分布を学習する必要があるスペースが増えます。 MoE では、必要な場合にのみそれらの一部を呼び出すことができます。
その結果、モデルは各計算を年々重くすることなく、パラメータの総容量を増加し続けることができます。
さらに K3 を例に挙げると、合計パラメータは 2.8T で、これは K2.5 の約 3 倍の規模ですが、896 人のエキスパートのうち、各トークンがアクティブになるのは 16 個だけです。 Dark Side of the Moon は、MoE の希薄化と一連のアーキテクチャ最適化のおかげで、K3 の全体的なスケーリング効率は K2 と比較して約 2.5 倍向上したと述べています。
エージェント時代は、この「能力」を競争の中心に押し戻しました。
以前は、チャットボットの能力を 1 つずつ測定することがよくありました。数学は数学を調べ、コードはコードを調べ、Q&A は知識を調べます。モデルがいくつかの主要なベンチマークでより高いピークに達すれば、モデルが非常に強力であることを証明するのに十分です。
しかし、エージェントはこれらの機能を同じタスク チェーンに組み込んでいます。実際に長いタスクは、情報の検索から始まり、Web ページを読んだり、写真を見たり、コードを書いたり、端末に電話したり、その後エラーが発生したり、計画を変更したり、他のツールを呼び出したり、さらには他のエージェントにサブタスクを割り当てたりすることがあります。
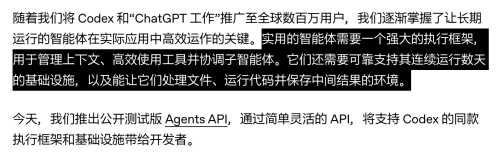
OpenAI が今年 9 月にエージェント API をリリースしたとき、エージェントのコア インフラストラクチャとして長期実行、コンテキスト管理、ツールの使用、サブエージェントの調整が直接リストされ、エージェントは数時間、場合によっては数日間にわたって確実に実行される必要があると強調しました。
Q&A では、特定の能力が時折失敗すると、質問が 1 つだけ失われることがあります。数十または数百のステップを含むエージェント タスクでは、弱いリンクがあるとリンク全体が中断される可能性があります。タスクが長くなるほど、機能の範囲と安定性に対する要件が高くなります。その結果、フロンティア競争には明らかな「バレル効果」が現れ始めた。
METR は、「タスクのタイム スパン」を直接使用してエージェントの能力を測定するようになりました。これは、タスクが長ければ長いほど、モデルが一連の異なる操作を継続的に完了するための要件が高くなるためです。
チャットボットの時代では、機能のピークを把握するのが容易ですが、エージェントの時代では、機能の範囲がますます重要になります。
現時点では、パラメータ容量が大きいほど新しい値が設定されます。タスクが長くなるほど、モデルの偏りが少なくなる必要があります。エージェントが実行できることが増えれば増えるほど、基地がカバーする必要のある機能も広がります。
MoE はキャパシティを継続的に拡張する余地を開き、エージェントはキャパシティの価値をさらに高めます。したがって、模型メーカーはパラメータを 5T、8T、10T と再度引き上げながら、効率を向上させるために最善を尽くしています。
節約されたコンピューティング能力によって Scaling が消滅するのではなく、Scaling のための新しいスペースが作成されました。
コメント