
要約:
それはクレイジーです。わずか2日間で4つの新モデルが登場!先頭に立って、Lao Ma の xAI は Grok 4.7 の発行を完了したところです。その直後、OpenAIは突然GPT-6 SolとLunaを投げ捨て、価格は半額に値下げされた。同じ日に、Anthropic は前世代より 40% 安い Claude Opus 5.5 も出品しました。 9 月 22 日、あるアニメーション画像が X 上で急速に広まり、再生回数は約 100 万回に達しました。
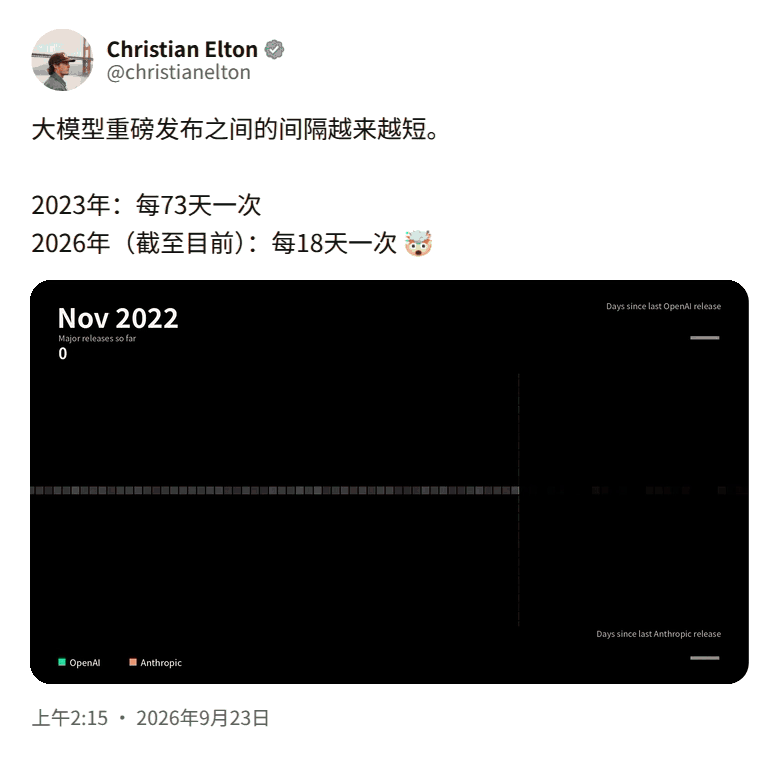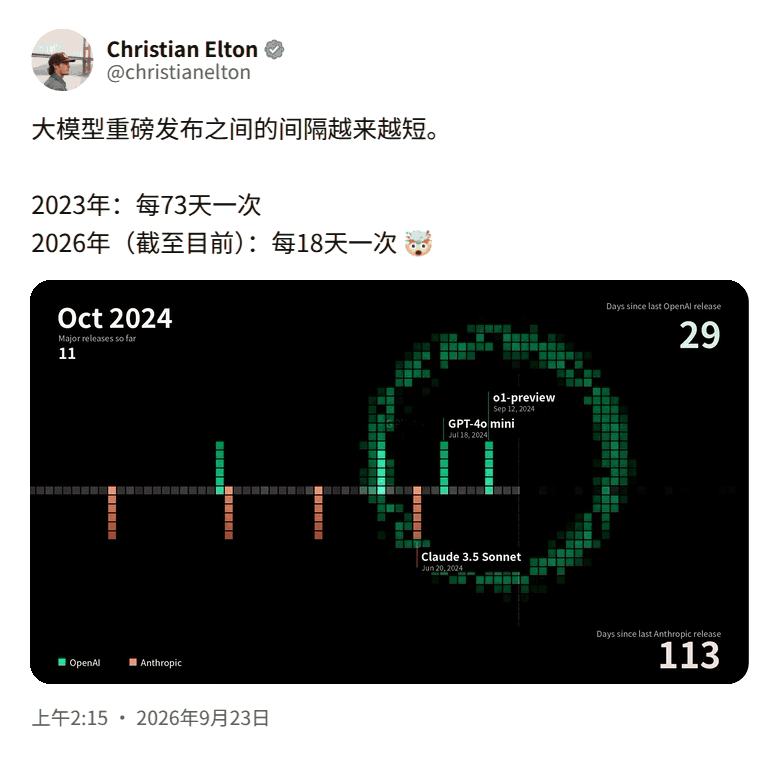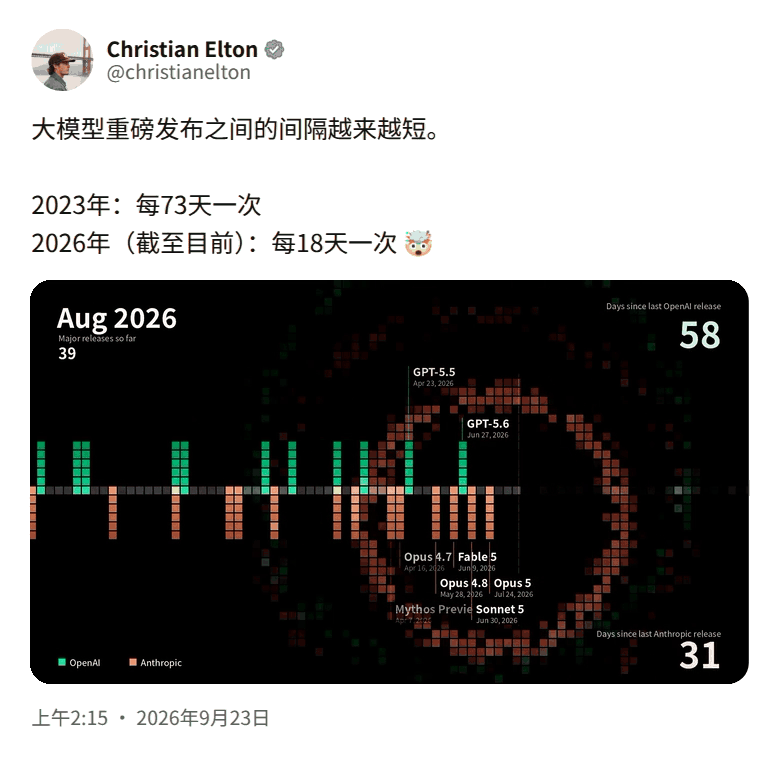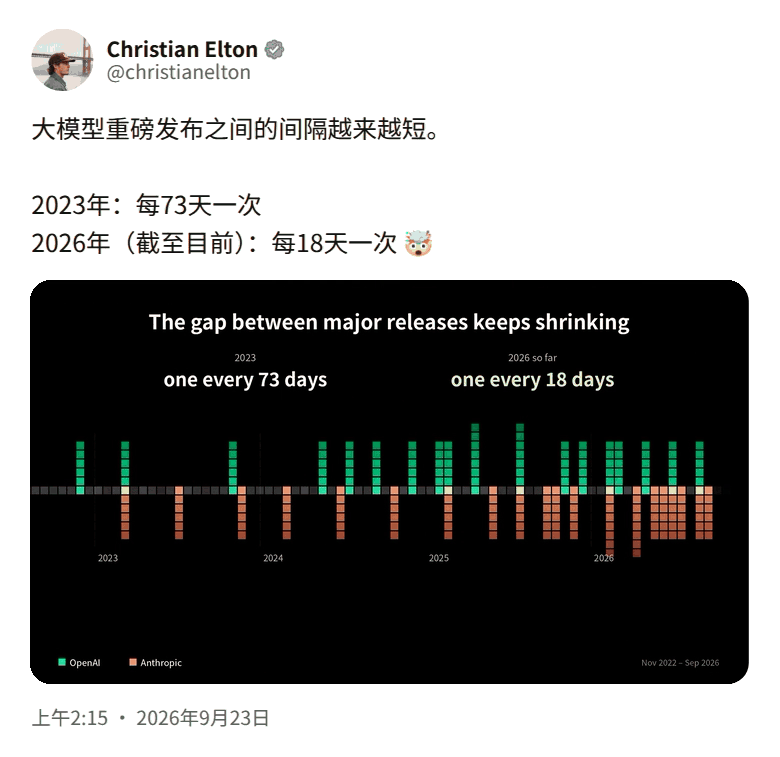
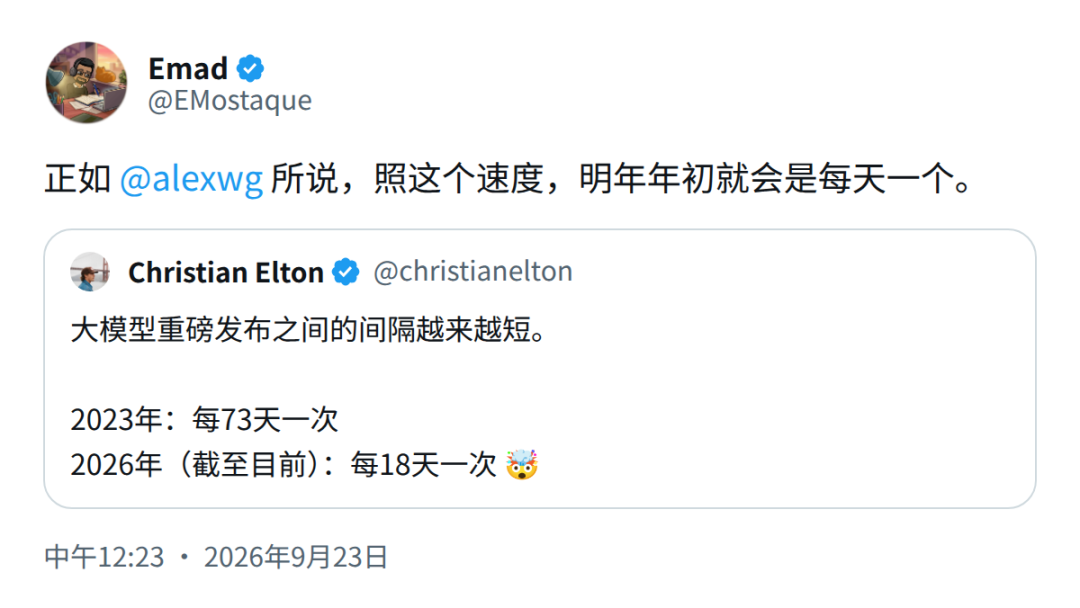
2023 年には、大規模モデルは 73 日ごとに更新され、2026 年には 18 日ごとに更新されます。
ChatGPT が発売されて以来、OpenAI と Anthropic は 42 個の大ヒット モデルを投入してきました (同日リリースされた GPT-6 Sol と Luna を含む 44 個)。
数時間後、Stability AI の創設者エマド モスタク氏がその写真をリツイートし、予言を追加しました。
「アレックスが言ったように、このペースでいくと、来年の初めには 1 日 1 件になるでしょう。」
2 つの巨人、「半月ごとのアップデート」を展開
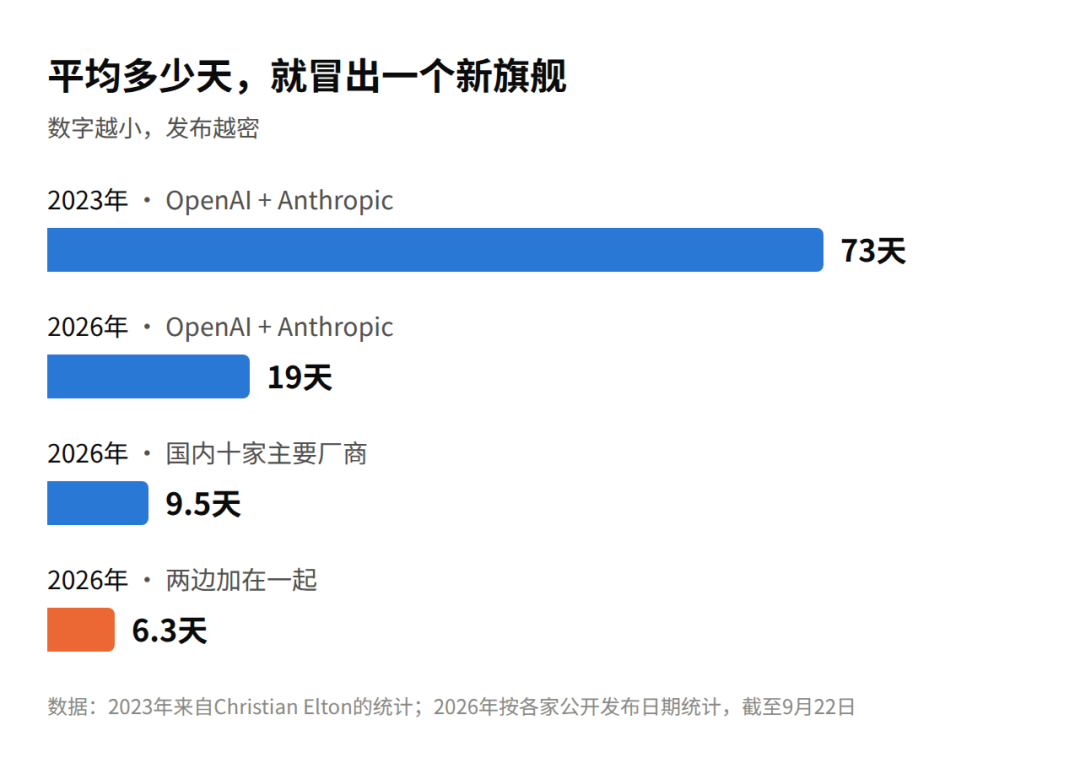
実際、「18 日ごとの更新」という数は OpenAI と Anthropic のみをカウントしているため、非常に控えめです。
今年の初めから 9 月 22 日までに、Anthropic は 8 つの主力モデルをリリースし、OpenAI は 6 つのフラッグシップ モデルをリリースしました。14 のモデルは 265 日にわたって展開され、モデルあたり平均 19 日でした。
同じ期間に、国内の主要大型モデル メーカー 10 社は、少なくとも 28 モデル以上の主力モデルをリリースしました。これは平均すると 9 日に 1 モデル以上のペースです。
彼らが一緒に立ち上げたときもありました。春節の前週、4社が次々と新フラッグシップを発表した。 4月20日から24日までの5日間でさらに4社が交代で参加した。
両方の立場を合わせると、新しい旗艦は平均 6 日以上で誕生します。これは、Emad 氏が述べた「1 日に 1 つ」からそれほど遠くありません。
Anthropic の速度向上は肉眼でも確認できます。
今年上半期はモデルのリリースまでに平均 46 日かかり、下半期は 26 日かかりました。オーパス4.8は5月28日、オーパス5は7月24日、オーパス5.5は9月22日です。
OpenAI は「究極の手を抑えてから奪う」というルートをとります。
GPT-6 アストラは 9 月 3 日にネットワーク全体を爆破したばかりで、そのわずか 19 日後にソルとルナも追随しました。
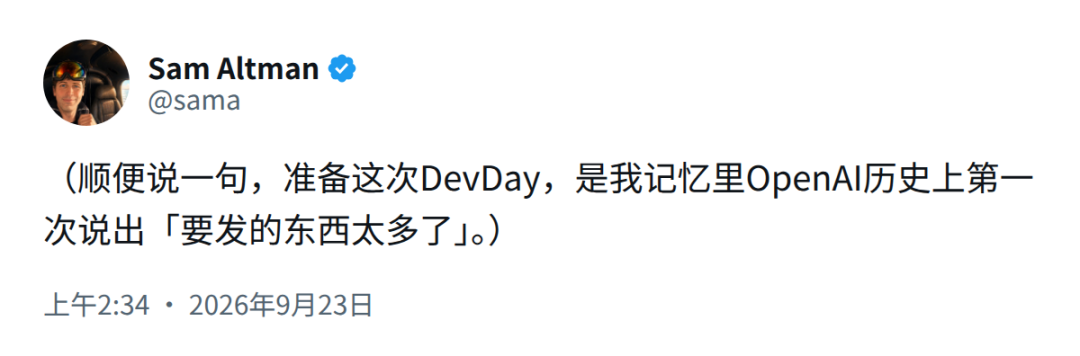
来週、DevDay カンファレンスが開催されます。アルトマン氏は、記者会見の準備中にOpenAIが「リリースすべきものが多すぎる」と叫んだのは記憶の中でも初めてだと嘆いた。
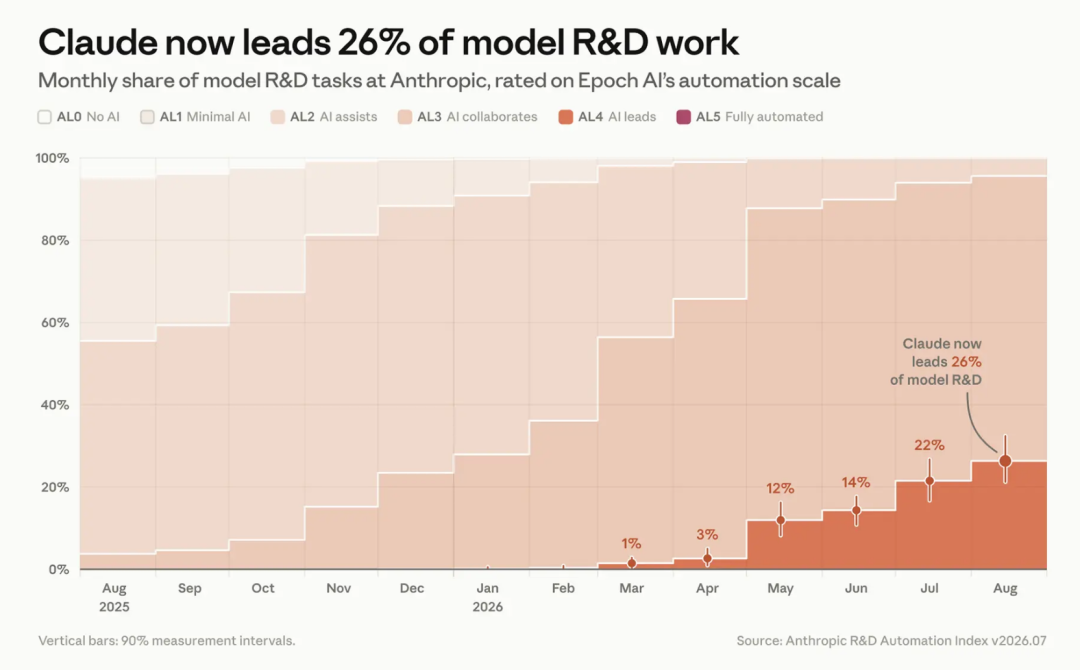
出版の密度がますます高まっているのはなぜですか? Anthropic はレポートで答えを示しました。 AI はすでに次世代の AI の作成に貢献しています。
今年 2 月、クロードが独立して主導できる AI 研究開発作業は 1% 未満でした。その後はほぼ毎月改善し、5月は12%、7月は22%、8月は26%に達した。
OpenAI では、8 月中旬の時点で、AI エージェントが費やした労働日数は人間の研究者の 3.1 倍となっています (1 日あたり 8 時間に基づく)。
Anthropic では、モデル作成の作業の 4 分の 1 がクロード自身に引き継がれています。次期モデルも続々と登場するでしょう。
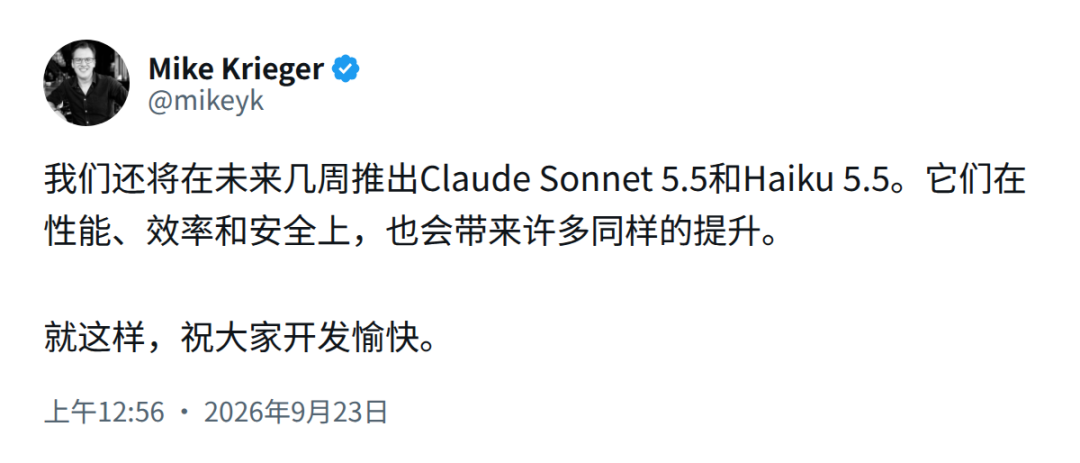
列はすでにドアに到達しています。 Anthropic の Mike Krieger は、Sonnet 5.5 と Haiku 5.5 が今後数週間以内にリリースされる予定であることを明らかにしました。
Google の Gemini 4 は、早くも 7 月に「これまでで最も野心的な事前トレーニング」を開始しており、外部の世界では一般に、それが年末頃に発表されると見込んでいます。少なくとも国内企業2社が次世代フラッグシップモデルを正式に発表しているが、発売日が不明なのは1社だけだ。
苦労して獲得した「形而上学」
2 か月後にすぐに廃棄されます
大規模なモデルの実行が速くなればなるほど、下流でコードを作成する人々にとっては恥ずかしいことになります。
7 月末に数回徹夜をして、アプリケーションを Opus 5 に移行したところです。すべてのパラメーターがシルクのようにスムーズに調整されました。 2 か月後、Opus 5.5 が登場し、あなたは喜んでインターフェースを変更しました - クリックすると、いくつかのリクエストがエラーを直接報告しました。
これら 2 社の最近の公式プロンプト ワード ガイドに目を通すと、同じ事実を伝えていることがわかります。前世代モデル用に作成した先祖代々のプロンプトの多くは紙くずになりました。
最初に引き算を行うことです。
OpenAI は、過去に詳細すぎたプロセス指示が今後は障害になると Astra ガイドで明確に述べています。 「コードを変更する前にドキュメントをよく読む」や「テストを実行することを忘れない」などの文言はすべて削除できます。
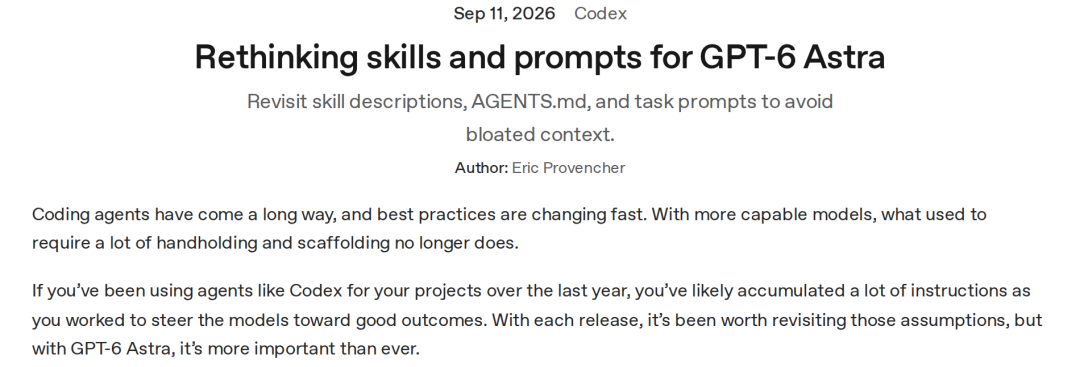
Anthropic のガイドもこれを意味します。
これまでは、プロンプト ワードに「完了したら確認してください」という文を追加する必要があることがよくありましたが、Opus 5 ではすでに単独で確認できます。この文章を削除しないとオーバーチェックになります。
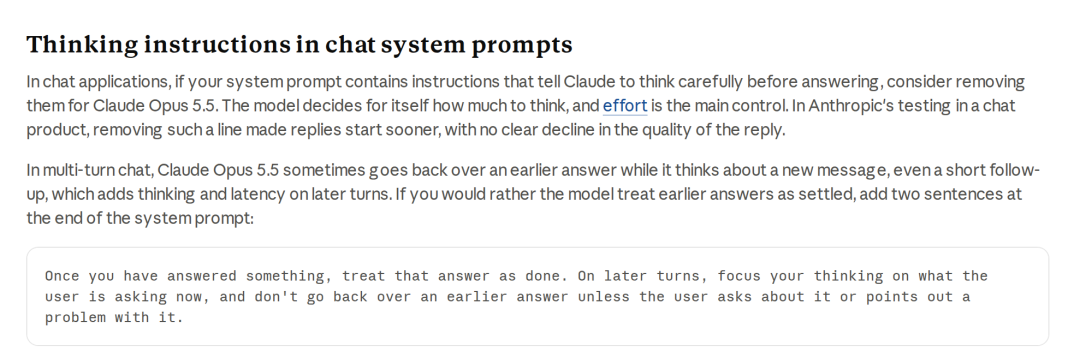
Opus 5.5 では、チャット シーンの「回答する前によく考えてください」という PUA フレーズを削除することが推奨されます。削除後は返信が早くなり、品質も大幅に低下していません。
世代ごとに新しい気質があるため、古いものを削除した後は、新しいものを追加する必要があります。
Opus 5.5 は常に、複数ラウンドの対話中にすでに回答された質問に戻って考えることを好みますが、これはコンピューティング パワーの無駄です。公式パッチは「答えられたものは過去のものです。」
パラメータやデフォルト値もひっそりと変更されています。
Opus 5.5 では、思考モードをオフにするとエラー 400 が直接報告されます。努力値パラメータを書き込まないと、デフォルトの装備が高から中へと減少し、それに応じてコストと効果がシャッフルされます。
これに関して、公式の提案は、エフォート テストを再実行し、Opus 5 から古い設定を直接転送しないことです。
一連のプロンプト ワードと一連のパラメータを組み合わせて、世代ごとに皮膚の層を剥がす必要があります。調整が行われていない場合、請求額が大幅に変わる可能性があります。
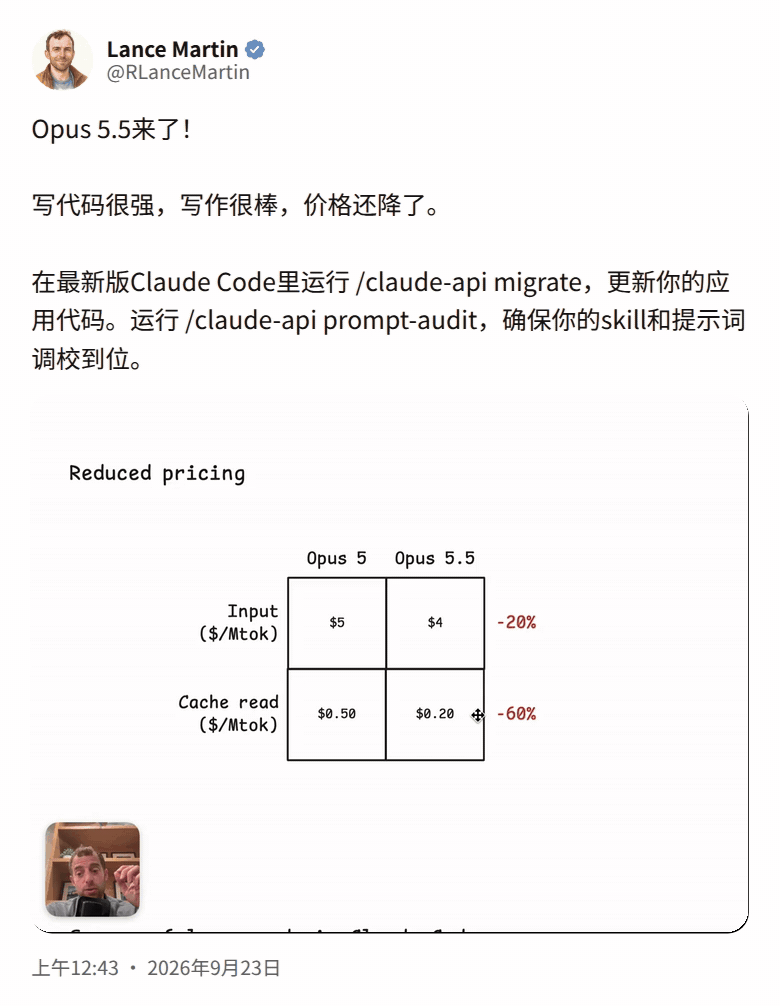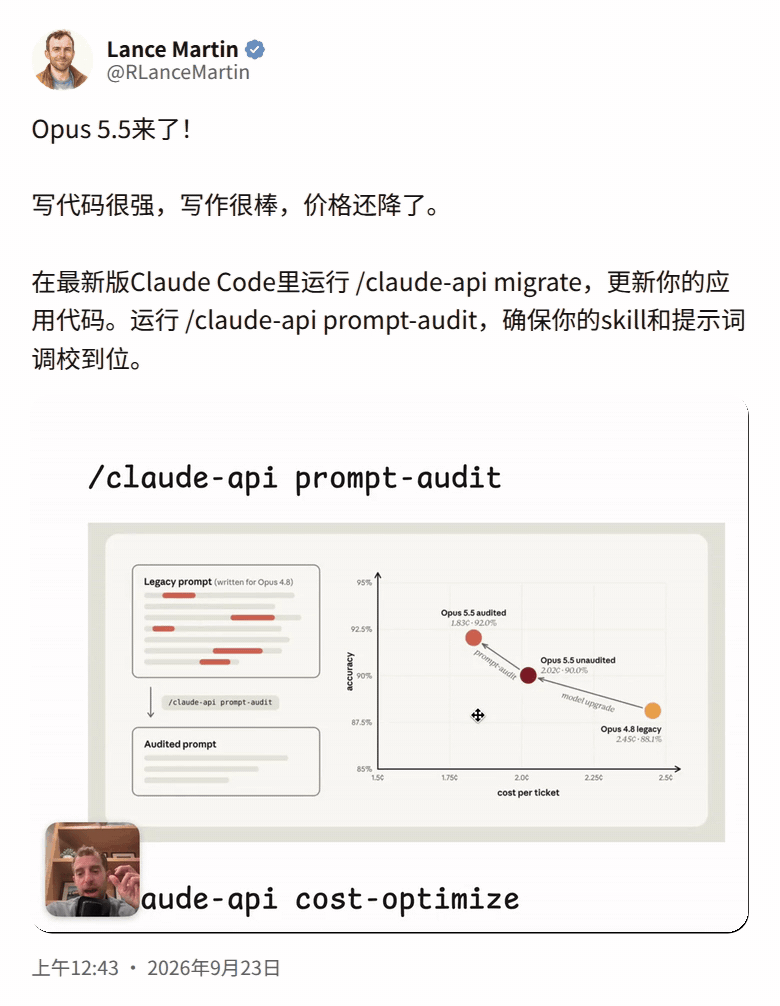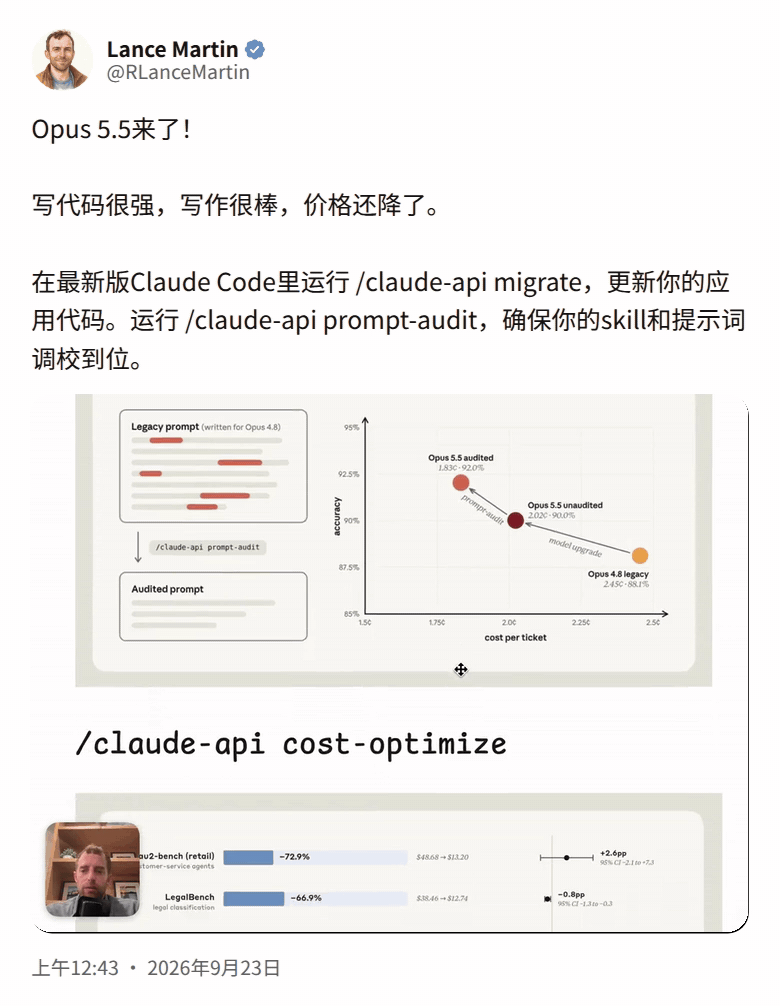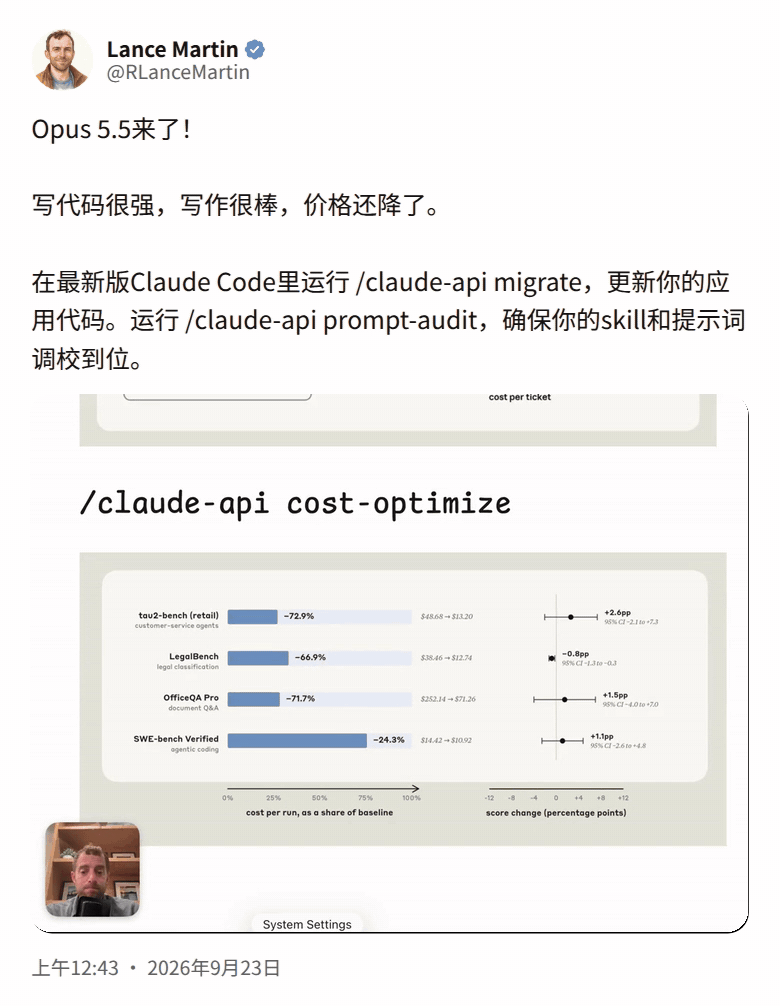
Anthropic の Lance Martin 氏は、Opus 4.8 用に書かれた古いプロンプトのコストは作業指示ごとに 2.45 セントかかり、それを Opus 5.5 に直接置き換えると 2.02 セントかかることをビデオで実証しました。公式ツールを使用して再度洗浄したところ、精度は 92.0% に向上し、コストは 1.83 セントに削減されました。
これらに加えて、モデル自体の寿命も短くなります。
OpenAI は今年、40 を超えるモデルと機能を含む 9 件の非推奨の発表を発表しました。
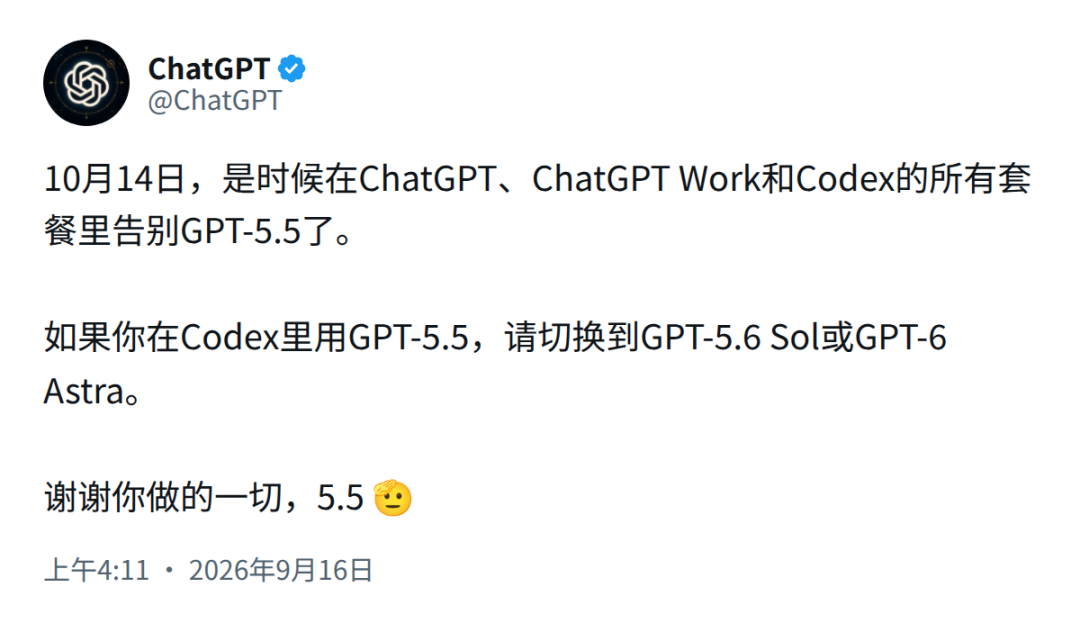
その中で、4 月 23 日にリリースされたばかりの GPT-5.5 は、10 月 14 日に ChatGPT および Codex から削除される予定で、存続期間は半年も経っていません。
OpenAI 独自の Evals 評価プラットフォームも 11 月末に終了します。
リストを見直しますか?新しい一連のテスト問題は半年で徹底的に解かれました
人々がついていけなくても問題ありません。今では「試験用紙」ですら十分ではありません。
今年 3 月、AI に特化し、質問を暗記せずに IQ をテストできると主張する ARC-AGI-3 が開始されました。当時1位だったGemini 3.1 Proは0.37%しか獲得できなかったが、人間は100%を獲得した。
9 月 3 日、GPT-6 Astra が試験室に入り、標準テストで 62.7% の得点を獲得し、特定のフレームワークを使用すると直接 99.9% に達しました。レベルの 96% で、人間よりも少ない歩数で進みました。
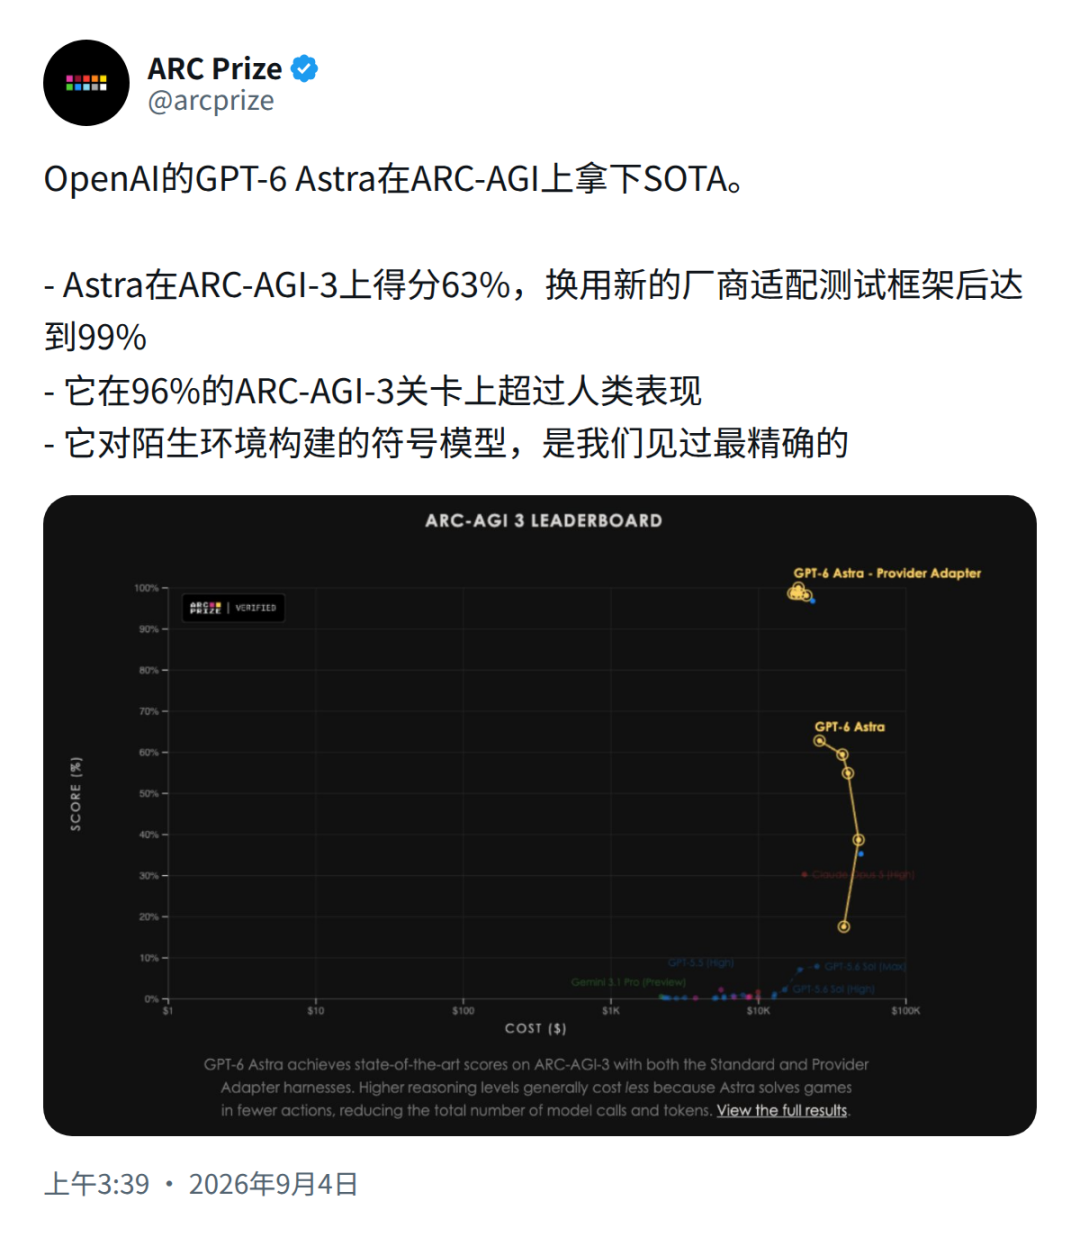
新しい一連のテスト問題が半年で細分化され、ARC 担当者は次世代の評価を作成する方法を検討し始めました。
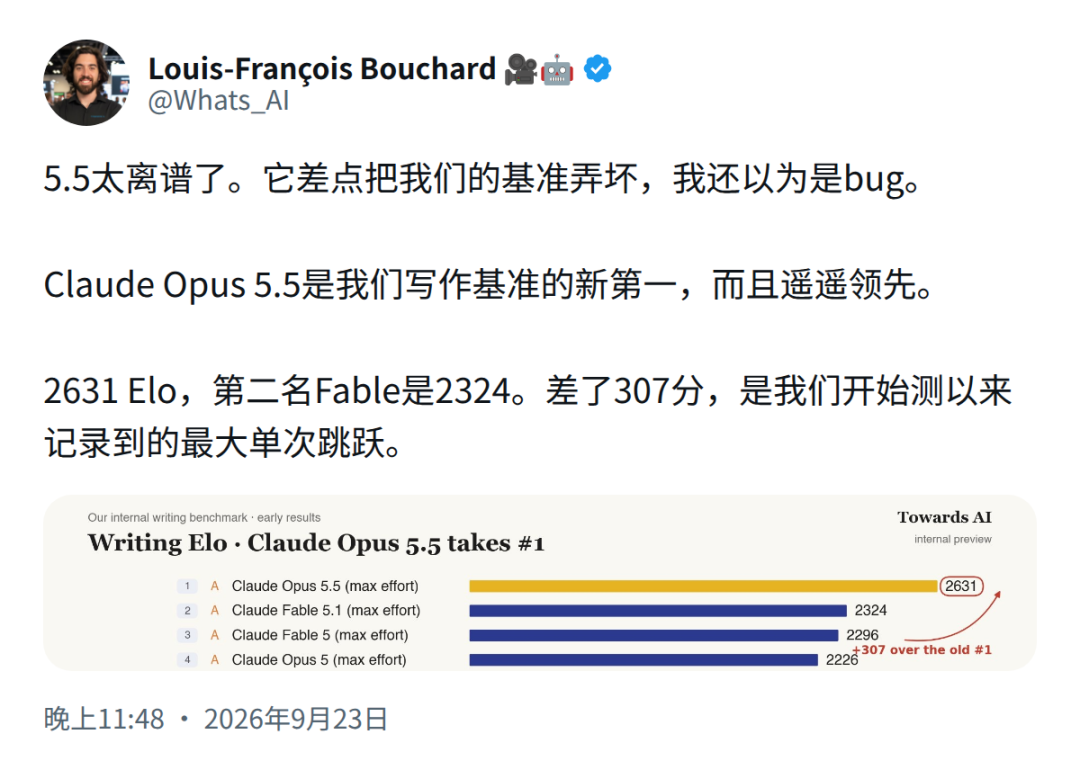
コーディング リスト (Next.js) では、Sol、Opus 5.5、および Fable 5.1 がすべて 97% のスコアを獲得し、同率 1 位でした。執筆リストでは、『Opus 5.5 Fault』が 2 位を 307 ポイントリードしています。
このスコアは、リスト史上最大の単一ジャンプです。このブロガーは、これを読んだ後、これはとんでもないことだと言い、自分のベンチマークにバグがあるのではないかと思うところでした。
新しいモデルが登場するたびに、開発者はシーシュポスのようにテスト プロセスを最初からやり直す必要があります。
現在のペースによると、来年本当に「1 日 1 回更新」になると、今日調整したプロンプト ワードとエージェント リンクは 1 週間も続かない可能性があります。
モデルの置き換えの速度が、人間がモデルに適応する速度を初めて完全に超えました。
今日最も遅いランナーは、実際には AI を使用しているランナーです。
コメント