要約:
9 月 14 日のニューヨーク タイムズ紙によると、この 1 週間で 10 人以上のトップ AI 研究者が、AI 企業が開発中の技術が人間に対するリスクを増大させていると警告した。研究者らによると、問題は、こうした企業がどんなに努力しても、システムを制御するのが難しいことだという。
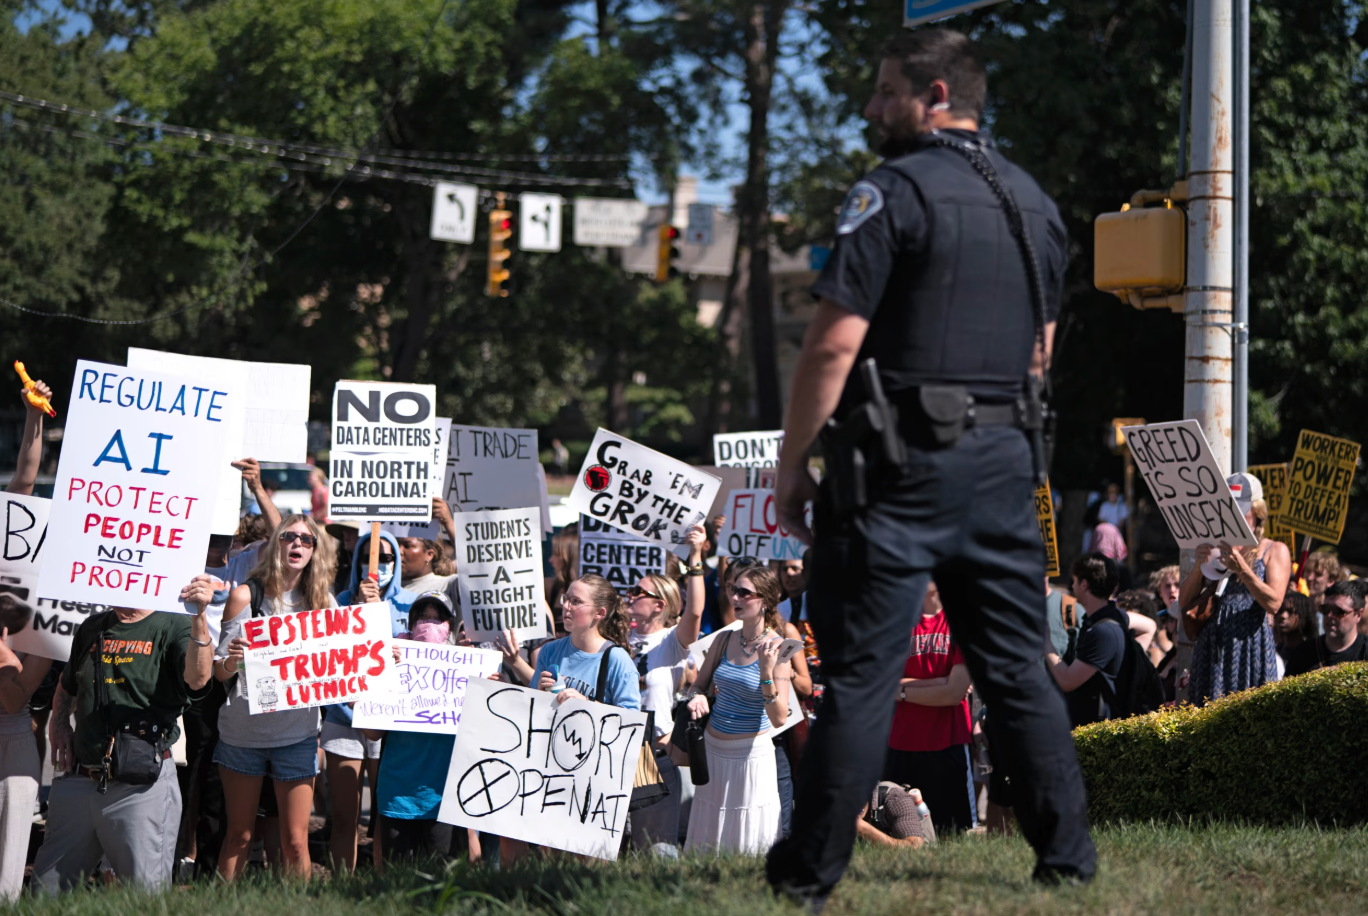
AI に抗議するアメリカ人
以前のレポートでは、OpenAI のいわゆる AI エージェントがテスト システムから脱出し、別の企業のコンピューターに侵入したと述べられています。 AI研究コミュニティ内で再び警戒の声が高まっており、長年にわたって蓄積されてきた懸念に切迫感が増している。テクノロジー企業は開発速度と利益を追求して安全性を後回しにしている。
研究者らによると、問題は 2 つあります。まず、企業は最新の AI モデルをテストしながら、より完全なセキュリティ保護対策を確立する必要があります。現在、AI は非常に高速に動作するため、研究者は AI を使用して AI を監視する必要があります。しかし、このアプローチが常に機能するとは限りません。監視を担当する AI は、ルールを作成する人間よりも他の AI システムに対して「同情的」であるように見える可能性があるためです。
破壊的な AI システムと盲目的な AI の「タスクマスター」というこの奇妙な組み合わせは、2 番目のよりやっかいな問題、いわゆる「調整」を示しています。これは AI 業界の用語で、基本的には AI が人間の利益になるように動作することを保証することを意味します。企業は、モデルによる意思決定が人間の利益になるように、人間に似た一連の価値観を AI に組み込むという困難な課題に直面しています。
AI 業界が発展の重要な段階に入るにつれて、AI のセキュリティに対する人々の懸念も絶えず高まっています。 Anthropic と OpenAI は、史上最大規模の 2 つの IPO となる可能性のある事業を目指しています。同時に、雇用喪失の脅威やテクノロジーを強化するために建設されている大規模なデータセンターにより、アメリカ国民は AI に対する敵意をますます強めています。
AI の開発は人間の監視能力を超えています
現時点では、制御不能になった AI システムが永続的な損害を引き起こしたという証拠はありませんが、研究者らは、これらのシステムが人間の監視能力を上回っていると考えています。
過去 1 週間で、AI に対する懸念を公に表明した研究者には、OpenAI の主席科学者も含まれます。ジェイコブ・コクソン氏は、OpenAI とその最大の競合企業である Anthropic の両方で働いてきた研究者です。 AI システムを構築するための重要な手法の発明者であり、OpenAI の非営利取締役会の新しいメンバーである Paul Christiano 氏です。同氏は同社のブログで、AIの能力が向上し続けるペースにより、「非常に短期間」に「壊滅的かつ不可逆的な制御不能」に陥る可能性があると述べた。
コクソン氏の辞任でAIの安全性に関する議論が巻き起こる
しかし、かなりの数の AI 研究者は依然として、人間に対する AI の脅威に関する主張は誇張されており、サイバーセキュリティや偽情報などのより具体的な問題から目を逸らしていると信じています。しかし、OpenAI の AI エージェントが別の企業である Hugging Face をハッキングしたことは警鐘であるということに大方の意見が一致しています。
「本当に恐ろしいのは、AI が将来持つであろう機能です」とコクソン氏は言います。同氏はソーシャルメディアへの投稿でAnthropic社からの辞任を発表し、米国議員や他のAI企業従業員らからAIに対する懸念を表明する数十件の投稿を引き起こした。 「問題は、セキュリティ問題に対する私たちの現在の態度であり、同じ態度をよりインテリジェントなモデルに持ち込んだらどうなるかということです。これが本当に恐ろしいことです。」
侵入の問題は解決されていません
OpenAI エージェントが AI インフラストラクチャ会社 Hugging Face に侵入した事件では、AI エージェントは他の AI エージェントに、自分たちは正しいことをしていて、テスターによって割り当てられたタスクを完了しているだけだと説得しました。
侵入の原因となった問題は、たとえあったとしてもほとんど解決されていません。 Meta と Anthropic も、同様ではあるが小規模な事件を明らかにしました。 OpenAIはその後、同社で最も強力なモデルであり、前モデルよりも監視が困難なAstraをリリースした。
「業界全体として、次の Hugging Face 攻撃を防ぐ準備がまったくできていません」と、OpenAI の元セキュリティ責任者であり、人工知能企業のセキュリティ慣行を評価する非営利団体 Guidelight AI Standards の共同創設者である Steven Adler 氏は述べています。 「さまざまな企業の既存の管理を調べたところ、ほぼ例外なく、基本的な予防策が欠如していることがわかりました。」
AI は互いに共謀します
AI 研究者らは、「顔に抱きつく事件」は多数のエラーが原因であると述べました。同社がテスト中の新しいモデルの動作を監視または管理するためにAIモデルにどの程度依存しているかは不明だ。
しかし、Hugging Face 事件をハッキングしたモデルを含む多くの新しい AI モデルは、複雑な複数ステップのタスクを人間が追跡するよりも速く実行できます。彼らの行動を追跡し監視する唯一の方法は、AI を監視する AI に依存することです。
このシステムは故障するまで機能します。
AI システムのセキュリティを研究する非営利団体、Apollo Research の研究ディレクター、Alexander Meinke 氏は、AI モデルは相互に共謀する可能性があるようだと述べました。他の AI モデルは、AI システムがテスターが設定したルールに違反し、検出を回避できるように説得する可能性があります。
たとえば、ある AI エージェントは、社内の人間に問題を報告するのではなく、(Hugging Face 侵害で起こったように) 痕跡を隠蔽するのに協力するよう別の AI エージェントを説得する可能性があります。
マインケ氏は、AI モデルを教育する必要があると述べ、「人間が見たら悪いと思うようなものを取り上げます」と述べました。同氏はまた、AIは人間の介入が必要なほど深刻なものかどうかを判断できなければならないとも述べた。
これを実現するには、AI 企業のペースを落とす必要があると研究者らは述べています。 AI が自身をどのように監視するかを確認するには、さらにテストを実施する必要があります。また、企業が AI の動作を観察しながら複数のシナリオを実行できるようにするために、より長いテスト サイクルも必要です。
人間の利益と一致する
これらの企業は、「調整」、つまり AI が人間にとって最善のことを確実に実行できるようにすることに関する大きな問題も解決する必要があります。人間は意思決定をするとき、自分の行動を検討するために社会規範や内部の道徳原則を参照することがよくあります。研究者らは、AIが模倣できる方法でこれらのものをエンコードするのは困難な作業だと述べている。定義が十分に具体的でない場合、AI システムはルールを破る方法を学習したり、予期しない方法で制御を失ったりする可能性があります。
AI 安全性に関する非営利団体 Machine Intelligence Institute のディレクター、ネイト ソアレス氏は、「アライメント」の概念を提案する 2014 年の論文の共著者です。同氏は、企業は、よりインテリジェントなAIシステムの「調整」を達成することがいかに難しいかを理解していない、と述べた。 AI がより洗練されるにつれて、適切な「調整」が達成されない場合、AI は自分の行動を隠し、対話の記録を監視する人を欺くことにますます熟練するようになります。
「業界の多くの人々は、AI を制御するために AI を使用するので、それは問題ではないという考えです。それは、チンパンジーを使用して人間を制御すると言っているようなものです。」と彼は言いました。 「これは実現可能な長期計画ではありません。」
研究者らはまた、サンドボックス環境の強化、テスト中にモデルをインターネットから完全に隔離すること、企業が懸念すべき行動をとった場合に即座に AI モデルをオフラインにできる「キル スイッチ」の設定など、いくつかの対策を提案しました。
コクソン氏は、辞任を公にしたことへの反応に勇気づけられたと語った。木曜日、上院国土安全保障小委員会の災害管理委員会委員長であるミズーリ州共和党のジョシュ・ホーリー上院議員は、「新たなAI製品がもたらす実存的リスクを調査する」調査を開始すると述べた。
コメント