
要約:
Anthropic が IPO 目論見書を正式に提出したのと同じ日に、OpenAI は新しいモデル GPT-6.1 Terra をリリースしました。これは、Terra シリーズの 3 か月以上ぶりのアップデートであり、9 月 29 日の GPT-6.1 Sol のリリースから 27 日が経過しました。OpenAI は、公式プロモーションで「高速かつ強力なコンピュータ操作機能を低価格で提供する」と強調しています。
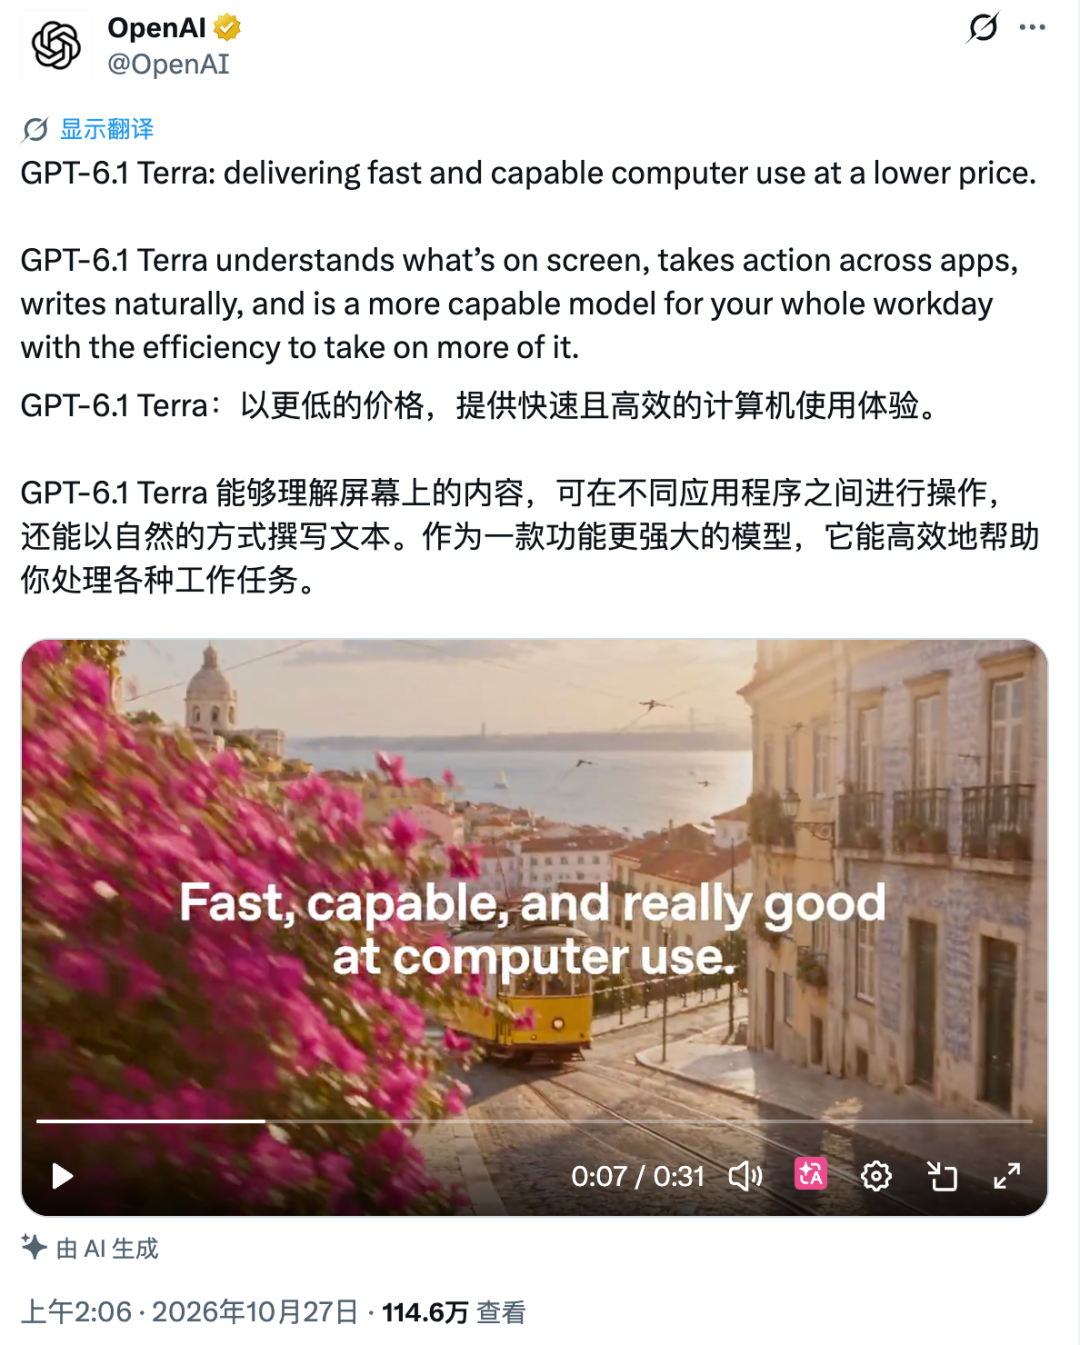
しかし、ネチズンはそれを買わないようです。
「そうですね、Opus 5.5 よりも優れたモデルが必要です。それが速いか安いかは誰も気にしません。」
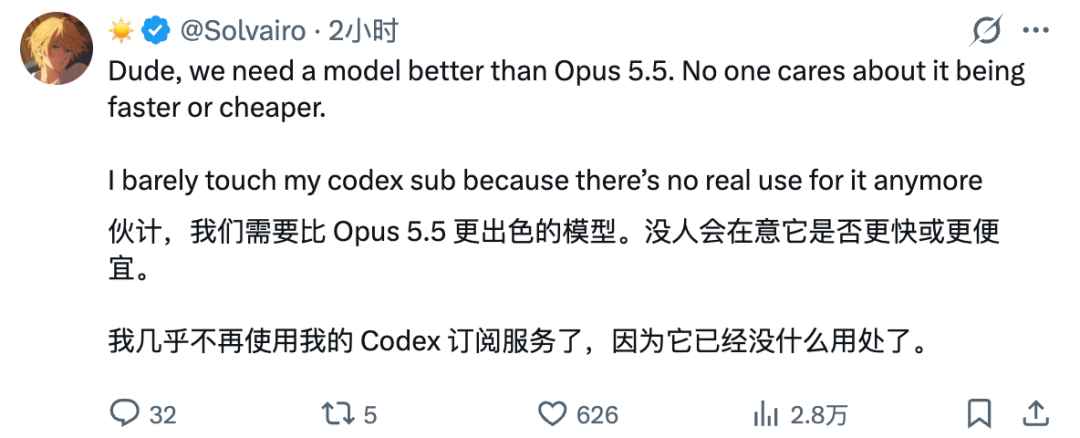
このネチズンは、Codex サブスクリプション サービスは実際には役に立たないため、もうほとんど使用していない、と不謹慎にも言いました。
過去の期間において、Anthropic は Claude Opus 5.5 によってプログラミングやその他の分野で大きな注目を集めてきました。多くのユーザーは、OpenAIが直接対決に耐えられる強力なモデルを開発することを期待していましたが、彼らが待っていたのは費用対効果を重視したミッドレンジモデルでした。
私が言えるのは、がっかりしないのは難しいということだけです。
「中」
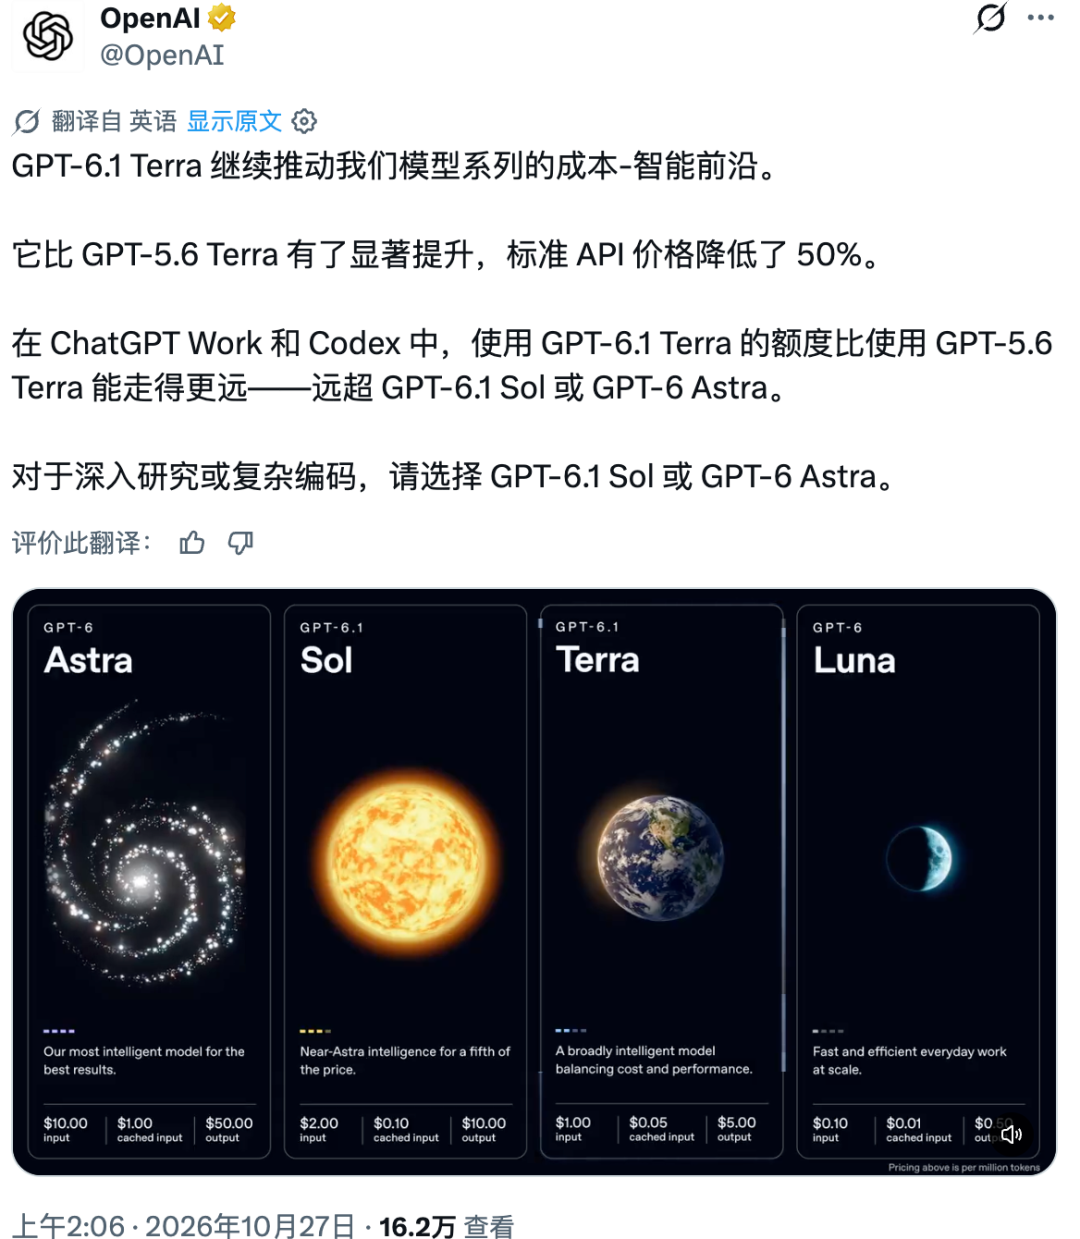
GPT-6.1 Terra の API 価格は、100 万入力トークンあたり 1 米ドル、キャッシュされた入力トークンは 0.05 米ドル、出力トークンは 5 米ドルで、前世代の入力価格と出力価格よりそれぞれ 50% と約 58% 低く、GPT-6.1 Sol のわずか半分です。
OpenAI が公開したデータによると、Terra はプログラミング、視覚的理解、コンピューター操作の点で前世代と比較して大幅に向上しました。
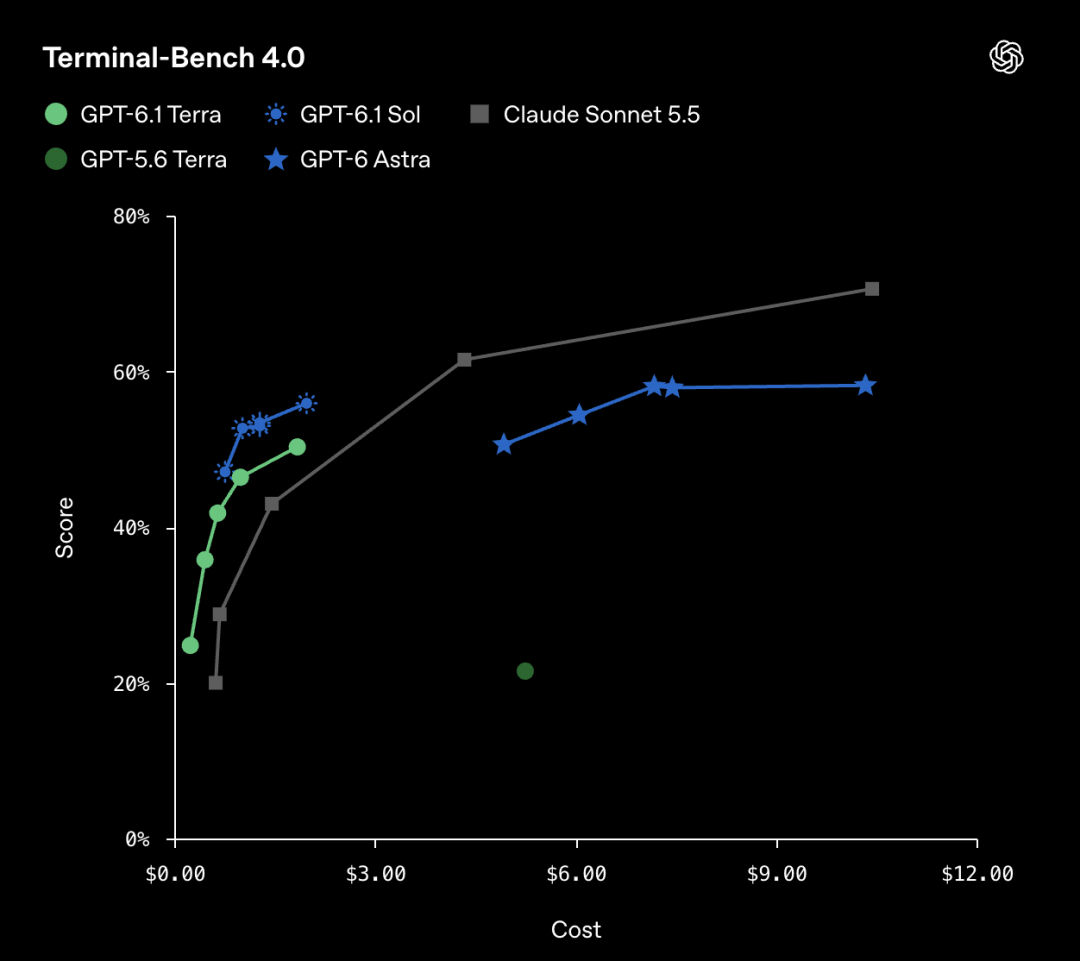
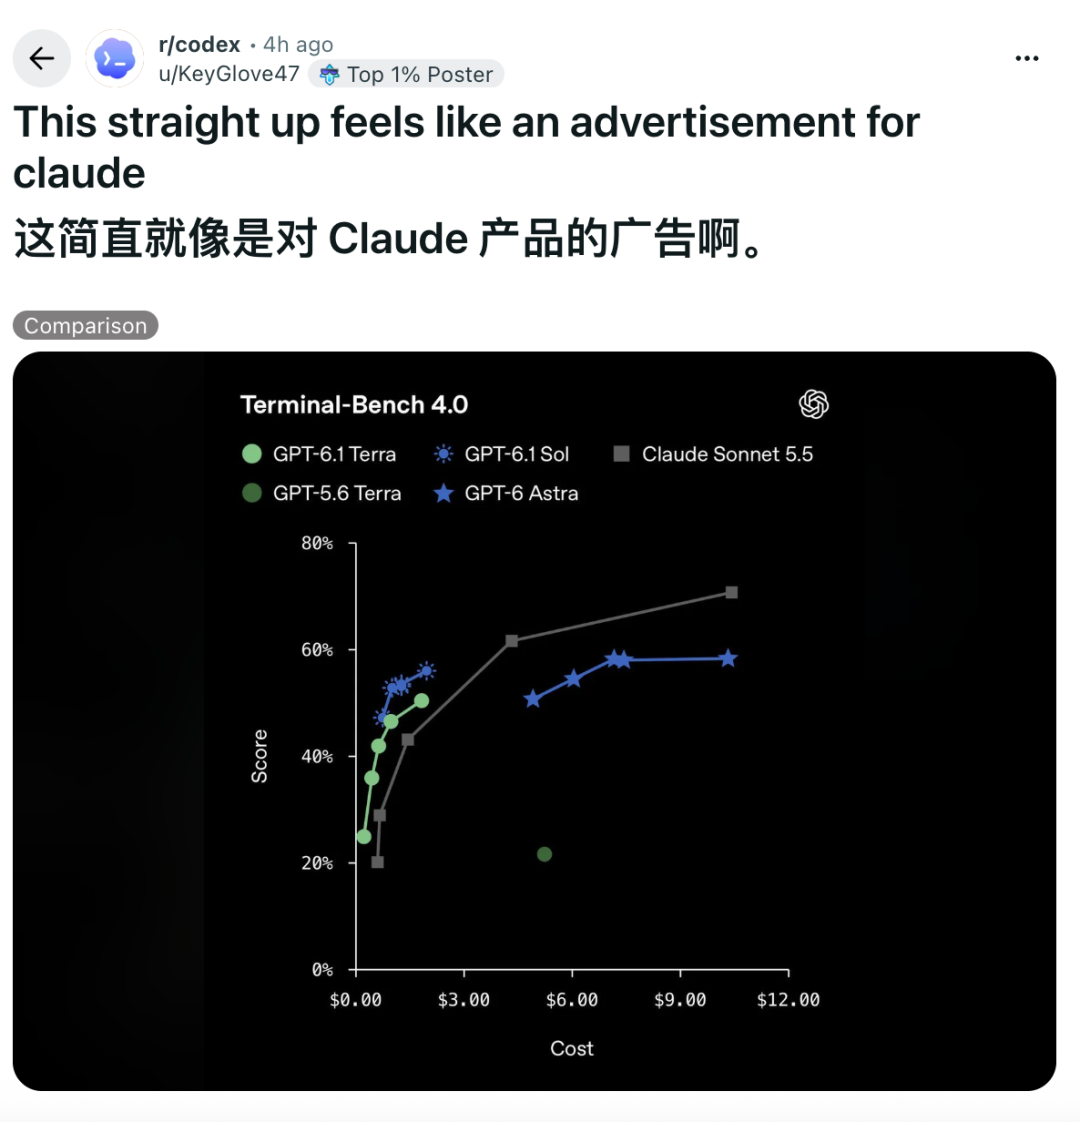
AI プログラミング エージェントの能力を測定する Terminal-Bench 4.0 テストでは、Terra のタスク完了率は前世代の 21.5% から 50.3% に増加しました。
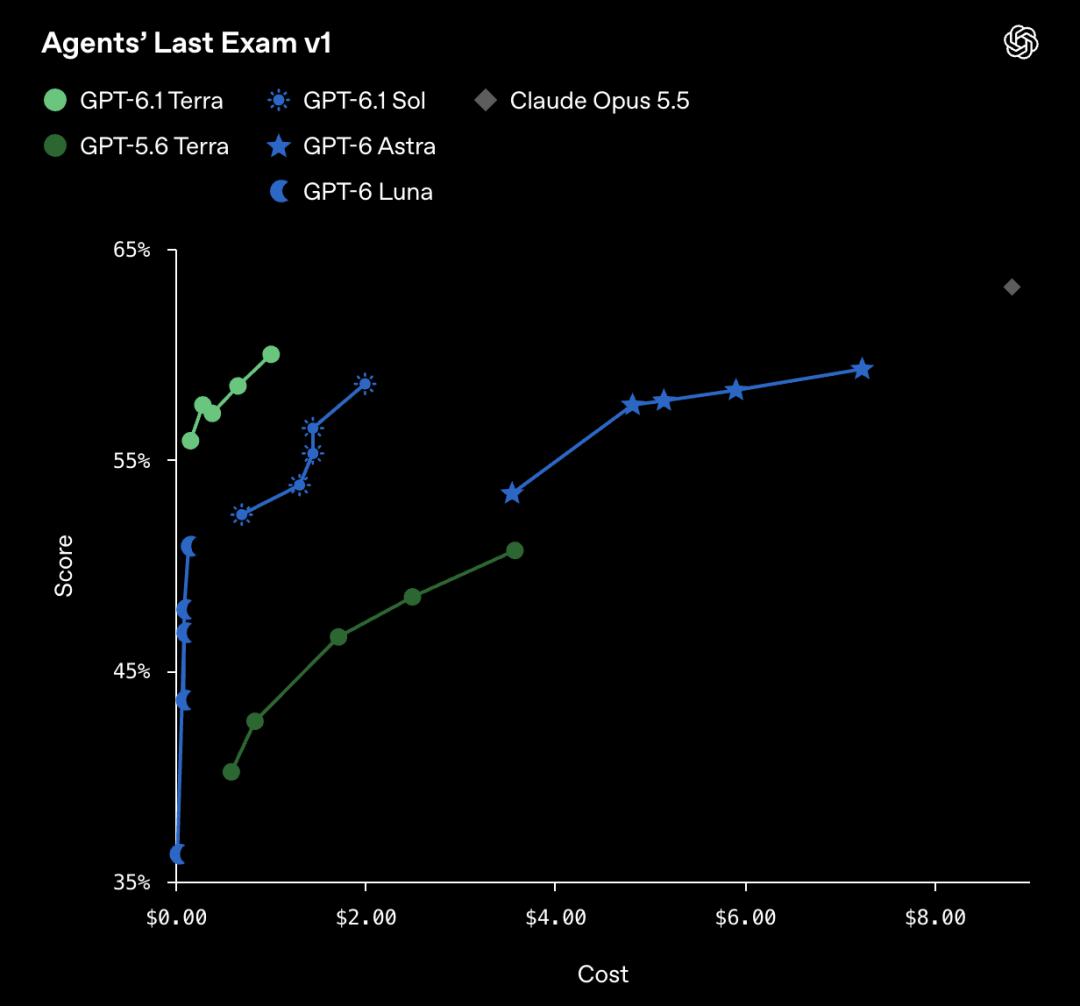
エージェントの最終試験テストで、Terra は 60.0% のスコアを達成し、Claude Opus 5.5 の 63.2% に近づきました。
OpenAI は、このコンピューター動作テストの最高の推論レベルで、Terra が Opus 5.5 の約 9 分の 1 のタスク コストでほぼ近い結果を達成できたことを特に強調しました。
しかし、サードパーティのレビューでは、6.1 Terra のパフォーマンスは目立ったものではありません。
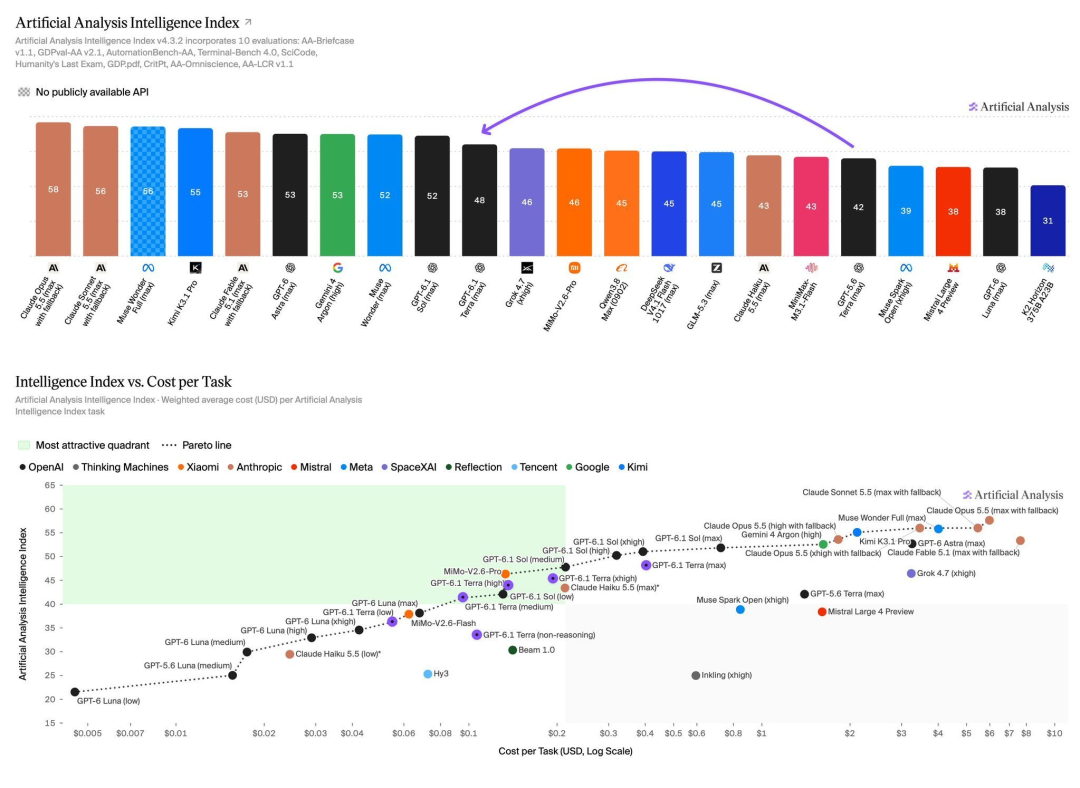
独立した AI 評価機関である Artificial Analysis によるテストによると、最高の推論ギアでの Terra の知能指数は 48 ポイントで、前世代より 6 ポイント高くなっていますが、それでも GPT-6.1 Sol の 52 ポイントよりは低く、Claude Opus 5.5 の 58 ポイントほどではありません。
相対的に言えば、コスト効率の向上がより明らかです。
Artificial Analysis による包括的なインテリジェンス レビューの結果、Terra で 1 つのタスクを完了するための平均コストが 1.40 ドルから 0.40 ドルに低下し、70% 以上減少したことがわかりました。
率直に言って、6.1 Terra はおそらく「当たり外れ」のあるモデルです。価格は高くもなく安くもなく、性能も悪くはないが悪くもない。前世代と比較すると確かに進化しています。しかし、OpenAI 自身の Sol を超えることはなく、ましてや Opus 5.5 に匹敵するものではありません。
これは、低コストの通話モデルを必要とする開発者にとって朗報かもしれません。
しかし、OpenAI が次に強力なモデルを考案するのを待っているユーザーにとっては、評価が 1 つしか得られないのではないかと思います。「それだけですか?」
現在、Terra は API を通じてオープンされており、Plus、Pro、Enterprise、Edu ユーザーは ChatGPT Work および Codex でも使用できます。ただし、当面は通常のチャット会話では呼び出すことができません。
ランニングスコアを超えて
GPT-6.1 Terra は OpenAI の 28 日間の継続アップデート プランにも含まれており、この期間中にリリースされる最初の新モデルになります。
Tibo 氏によると、これは、記述、モデルの性格、ユーザー ニーズの詳細な理解において大幅な進歩を遂げた OpenAI の最初のモデルです。
同氏はまた、新しいモデルはあらゆる面、特にコンピューターの操作において優れたパフォーマンスを備えていると強調しました。 API およびサブスクリプション サービスでは、GPT-6.1 Sol と比較して 2 倍の使用量を提供できます。
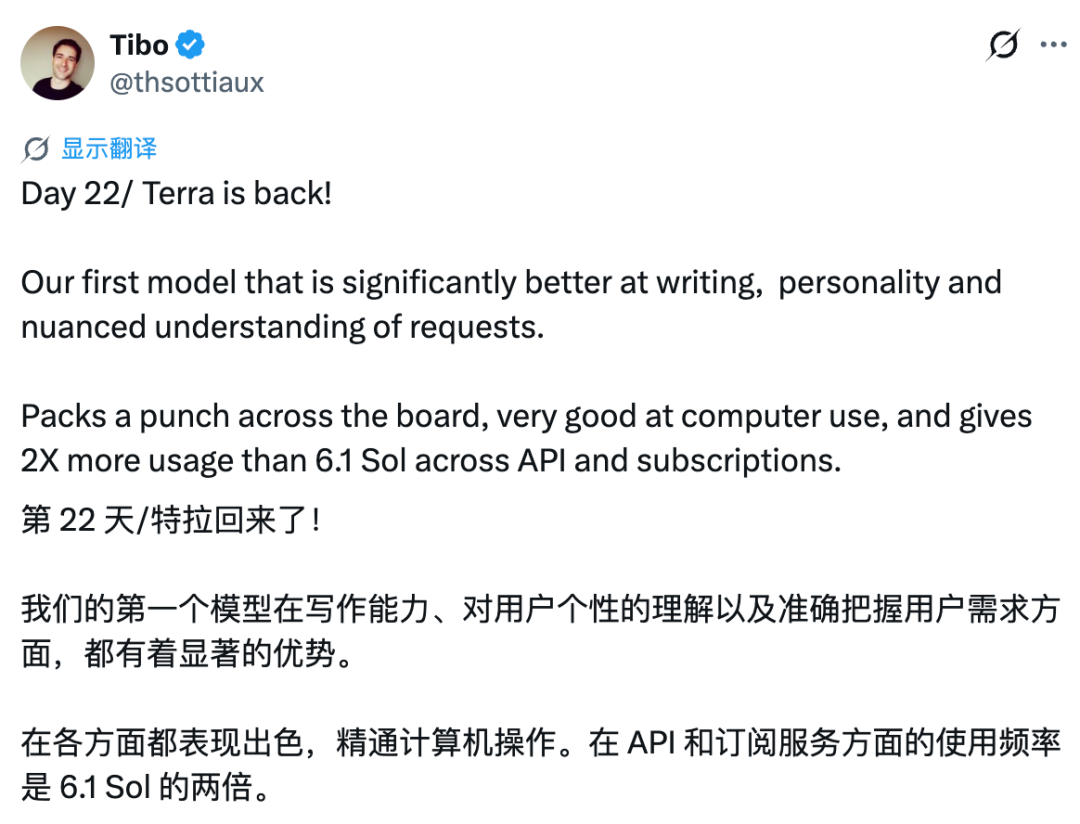
しかし、ティボが文章、性格、繊細な理解を特に重視していることを示す十分な公的証拠は現在不足しています。
OpenAI の公式リリースでは、Terra がより明瞭でより自然なテキストを生成できると主張していますが、上記 3 つの能力に関する特別な比較テストは提供されておらず、その大幅な進歩を証明するのに十分な評価結果も示されていません。
本当に文章を書くのが上手になり、ユーザーをよりよく理解できるかどうかは、残念ながら実際に使用した後のフィードバックを待つ必要があると思います。
コンピュータ操作の改善は比較的直感的です。プロモーション ビデオでは、OpenAI が写真に基づいて 3D モデルを作成する Terra の機能をデモンストレーションしました。
しかし、プロモーションビデオは所詮プロモーションビデオです。
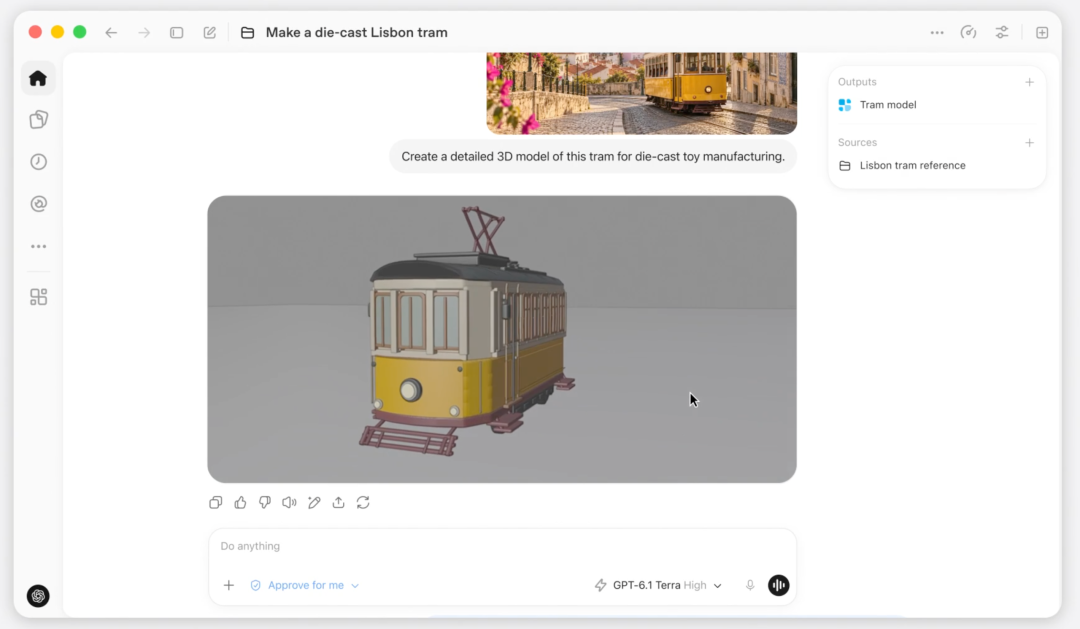
OpenAI は公式リリースの中で、Terra が参加したベンチマーク テストには、建築図面に基づいた 3D モデルの作成、フレームごとのアニメーションのチェック、タイムコードの整理などのタスクが含まれていることにも言及しました。公式の製品ポジショニングによれば、フォームに記入したり、製品の写真をカタログのエントリと照合したりするなどの日常業務にも適しています。
ウルトラマンは X でこう言いました。「GPT-6.1 Terra が登場しました! GPT-6.1 Terra は多くのことに優れていますが、私たちは特にこの新しい時代のコンピューター操作を楽しみにしています。」
OpenAI は、タスクの実行に加えて、モデルの信頼性の向上も強調しました。
公式に設計された高難易度の事実テストでは、Terra の事実誤認率は、低推論レベルで前世代の 53.6% から 16.7% に低下しました。最高の推論レベルでは、誤り率はさらに 4.3% に低下しました。
もちろん、これらの数値は OpenAI の内部テストから得られたものです。
ネチズン: 理解できません
OpenAI の公式の盛り上がりに比べると、ネチズンの態度はそれほど礼儀正しくありません。
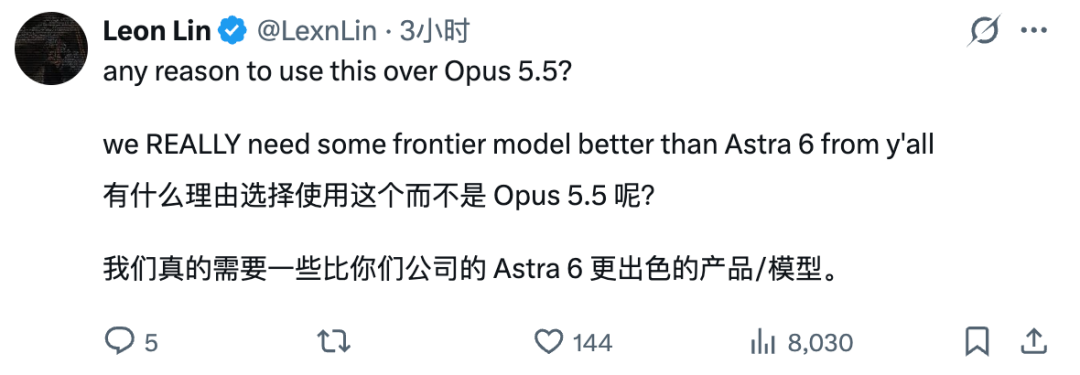
「Opus 5.5 ではなくこれを選ぶ理由はありますか?」
一部のネチズンは OpenAI に直接疑問を抱き、本当に必要なのは GPT-6 Astra よりも強力な最先端のモデルであると述べました。
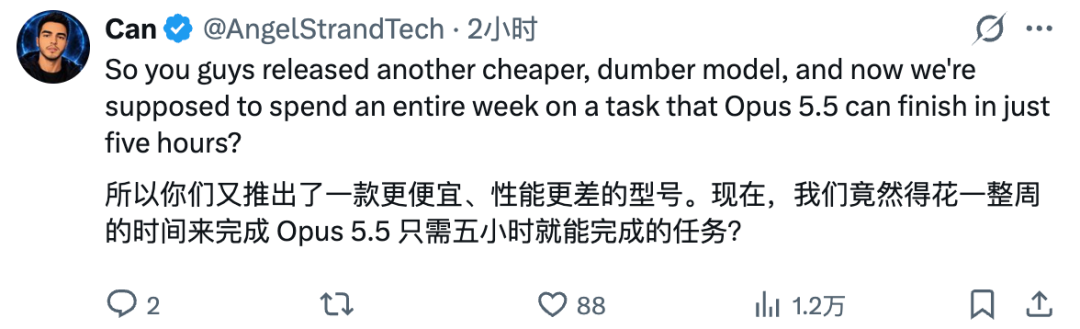
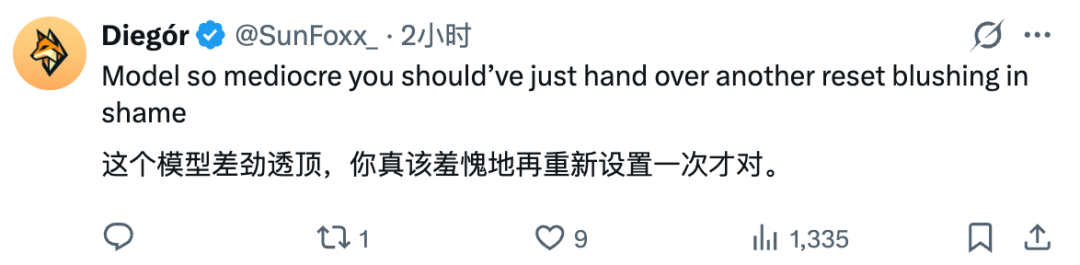
一部のネチズンは、なぜ公式がより多くのベンチマークを提供しなかったのか疑問を呈しました。以前は、テーブルを廃棄するだけでした。
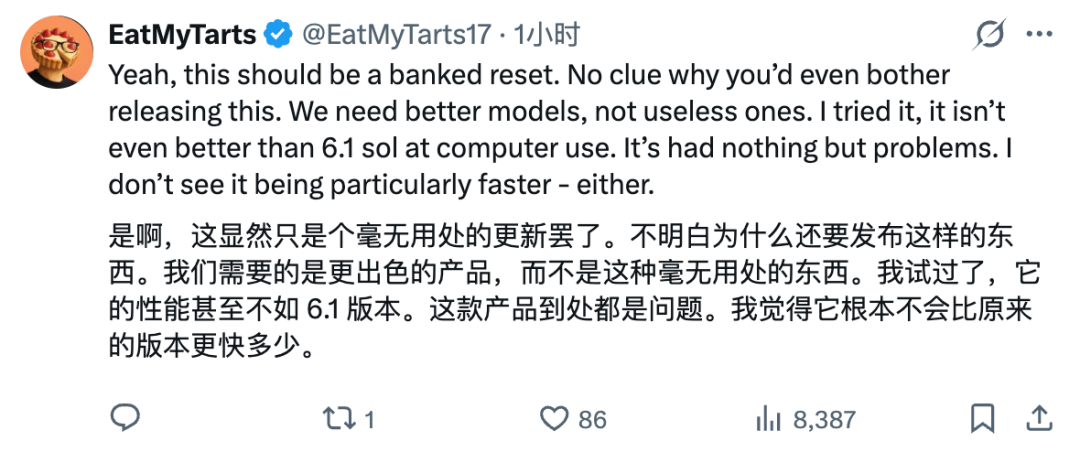
さらに、一部のネチズンは、新しいモデルを体験したところ、コンピュータの操作能力は 6.1 Sol にも及ばず、速度も宣伝ほど速くなかったと述べています。
「私たちに必要なのは、この役に立たないものではなく、より良い製品です。」
同様の不満は Reddit コミュニティにも現れました。
r/codex では、ネチズンが直接投稿し、このリリースを「ほぼクロードの宣伝」と表現しました。
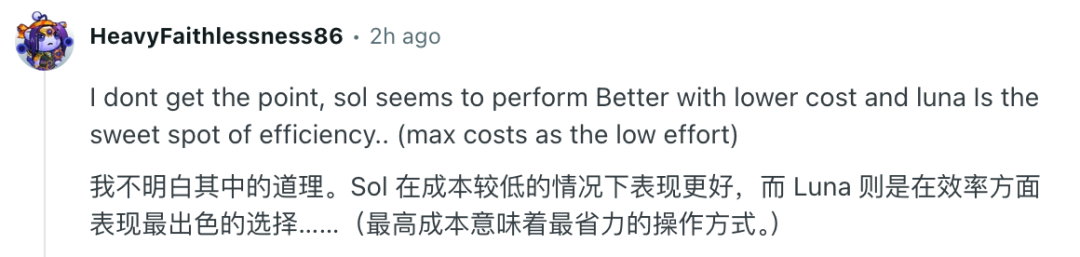
Terra の不自然さはその配置にあると考える人もいます。あるネットユーザーは、Terra の API 価格が Luna の 10 倍であると指摘しました。
最低コストを追求する場合は、Luna を使用できます。より強力なモデルが必要な場合は、Sol を選択する方が合理的だと思われます。
OpenAI の命名方法さえ批判されています。各モデルのリリース時期は均一ではなく、一部のタスクでは異なるモデルのパフォーマンスが重複するため、一部のユーザーは、Terra、Sol、Astra のどれを選択するかについて混乱しています。
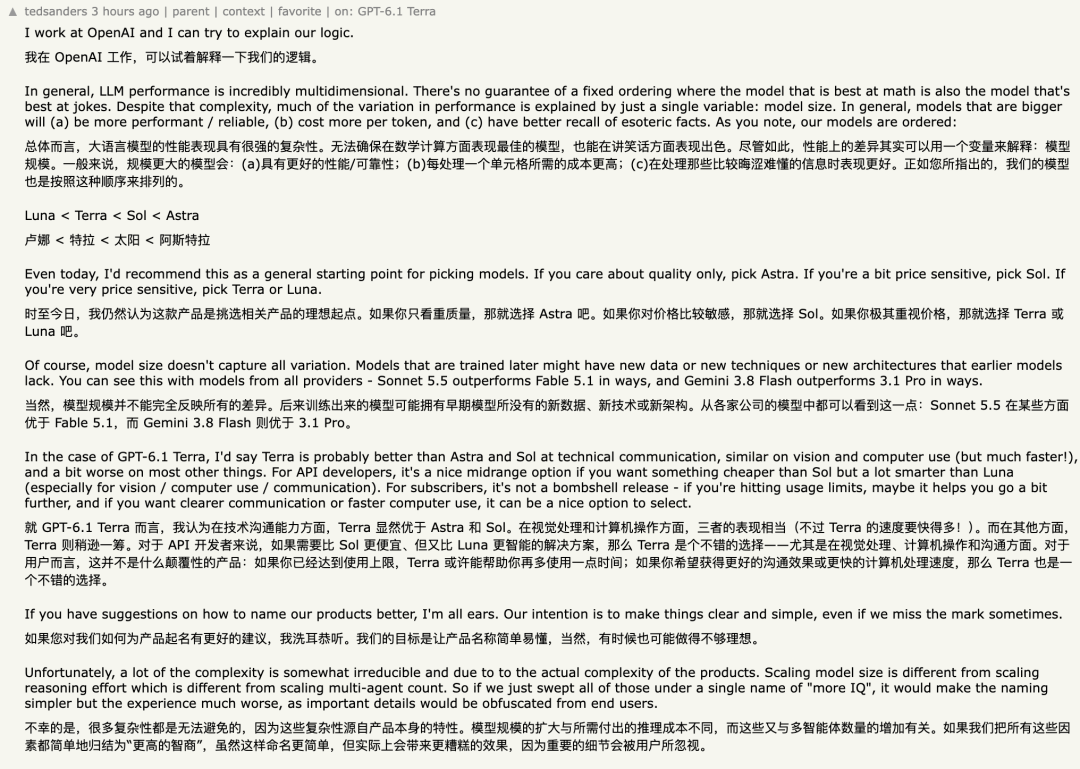
こうした疑問に直面して、OpenAI 研究者のテッド サンダース氏も Hacker News で解説を行っています。同氏は、Terraは技術的なコミュニケーションにおいてはSolやAstraよりも優れている可能性があり、視覚的な理解やコンピュータ操作においては同様で、より高速であるが、他のほとんどのタスクではわずかに劣る可能性があると述べた。
購読者に対しては、「これは大きなリリースではありません」とも認めました。
もちろん、コミュニティには、Terra のコスト効率を肯定し、フラッグシップ モデル レベルに近いタスクをはるかに低いコストで完了できること自体に価値があると考えるユーザーもいます。
ただ、この「非の打ちどころのない」Terra と比較して、多くの人がすでに次の Astra... とライバルの Fable 5.5 を待っているということです。
コメント