
要約:
今日はとても賑やかな日です。 Anthropic は向こうで IPO を申請し、OpenAI は最新モデル GPT-6.1 Terra をリリースしました。その位置付けは、詳細な視覚的推論、正確なコンピュータ操作能力と、より鮮明で自然な書き込みパフォーマンスを組み合わせた、「高速かつ強力なコンピュータ操作機能を低価格で提供する」ことです。
Sam Altman 氏は、「GPT-6.1 Terra はコンピューター操作の新時代を開くでしょう。」と興奮気味に語りました。
GPT-5.6 Terra と比較して、GPT-6.1 Terra の機能は大幅に向上しています。特に、提案書の作成や技術図面の解釈からフォームの記入やビデオの編集に至るまで、日常業務におけるコミュニケーションやコンピュータ操作のタスクを処理することに優れています。
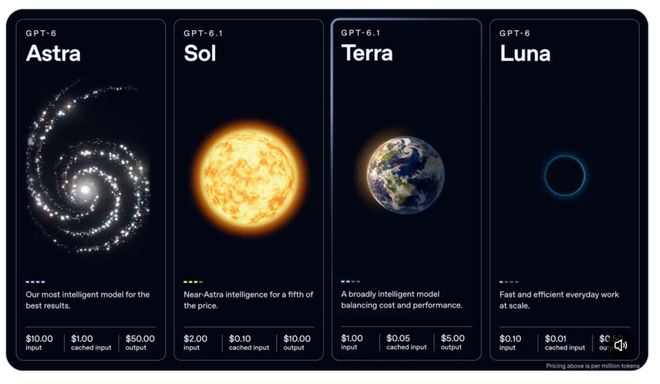
Terra は、モデルライン全体でスマートなパフォーマンスとコストのバランスを拡大し続け、速度、パワー、価格のより優れた組み合わせをユーザーに提供します。標準 API 価格は次のとおりです。
入力トークン: 100 万あたり 1 米ドル
キャッシュされた入力トークン: 100 万あたり 0.05 ドル
出力トークン: 100 万あたり 5 ドル
標準 API の価格は、GPT-5.6 Terra および GPT-6.1 Sol より 50% 低くなっています。これにより、開発者は、受信した請求書の読み取りや関連情報の会計ソフトウェアへの入力など、大規模なタスクを低コストで自動化できます。
本日より、すべての Plus、Pro、Enterprise、および Edu ユーザーは、ChatGPT Work および Codex で GPT-6.1 Terra を利用できるようになります。開発者は OpenAI API を通じてモデルを呼び出すこともできます。モデル ID は gpt-6.1-terra です。
さらに、ChatGPT Work および Codex で GPT-6.1 Terra を使用すると、プランの割り当てがより大きな役割を果たすこともあります。同じ使用量であれば、GPT-5.6 Terra よりも多くのタスクを完了できます。 GPT-6.1 Sol や GPT-6 Astra と比較して、完了できるタスクの数ははるかに多くなります。
視覚的な理解から実際の操作へ
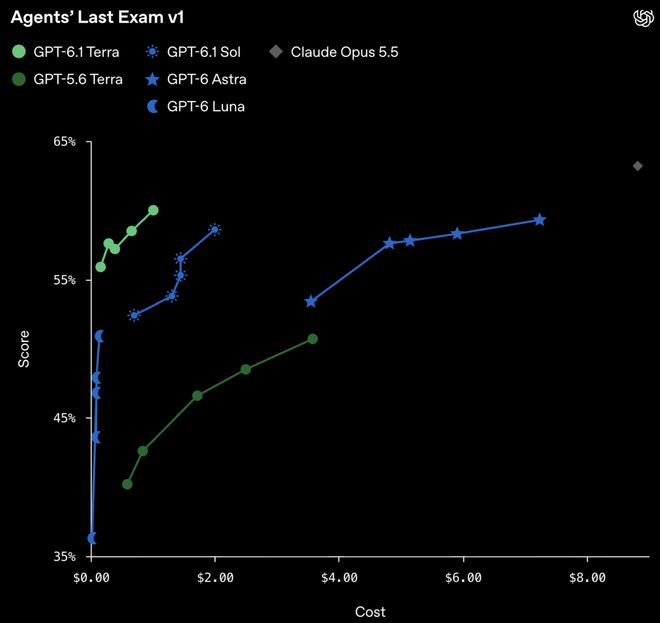
OpenAI は、エージェントの最終試験ベンチマークを使用して GPT-6.1 Terra のコンピューター機能を評価します。このベンチマークは、建築図面から 3D モデルを作成したり、アニメーション映像をショットごとにレビューして修復チーム向けにタイムコード付きの記録を作成したりするなど、特殊なタスクをカバーします。
中程度の推論強度では、GPT-6.1 Terra のスコアは GPT-5.6 Terra よりも 15 パーセント高く、コストは約 3 分の 1 です。 GPT-6 Astra と比較しても、そのパフォーマンスは同等ですが、トークンあたりの価格は後者のわずか 10 分の 1 です。
最高の推論強度では、Terra のトークン使用効率は Claude Opus 5.5 の 3 倍以上で、各トークンの価格は後者のわずか 4 分の 1 です。したがって、同じ作業を完了するのにかかるコストは約 9 分の 1 に削減できます。
Terra はさらに高速に動作し、GPT-6 Astra および GPT-6.1 Sol よりも 3 倍以上速くタスクを完了します。
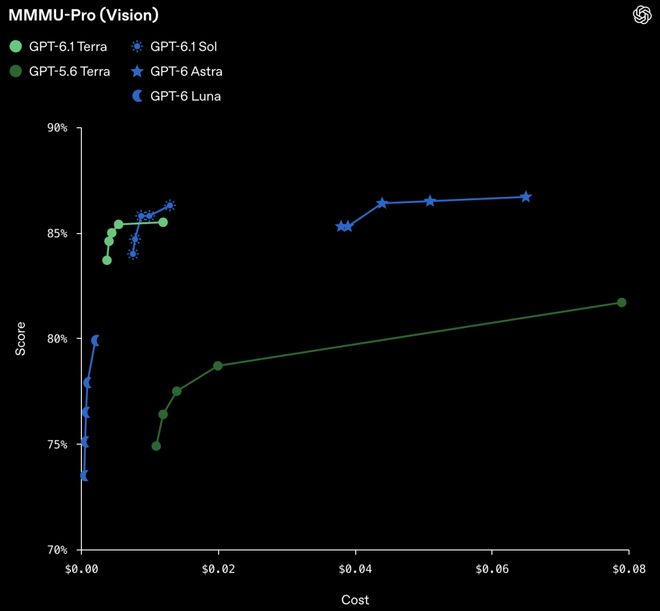
視覚推論ベンチマーク MMMU-Pro では、GPT-6.1 Terra はすべての推論強度設定で GPT-5.6 Terra を上回っています。 OpenAI の最も高性能な最先端モデルである GPT-6 Astra および GPT-6.1 Sol に近いスコアを実現しながら、コストははるかに低くなります。
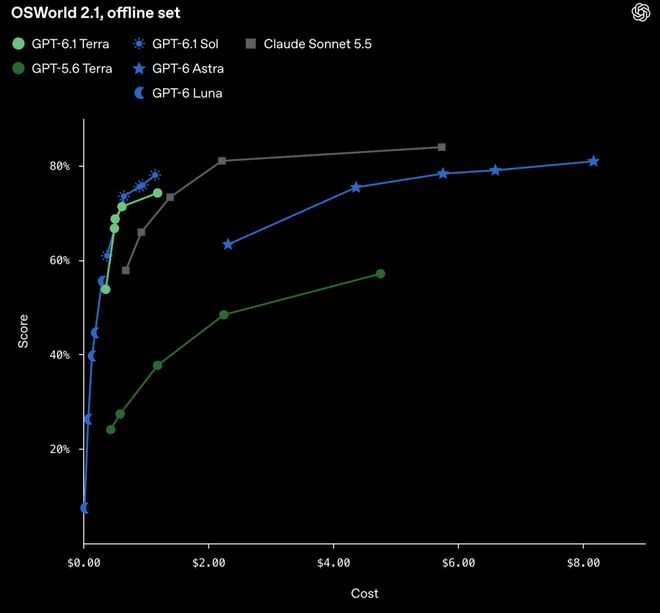
OSWorld 2.1 は、AI エージェントがデスクトップ アプリケーションを操作して、技術図面から 3D モデルを作成するなどの複数ステップのタスクを完了できるかどうかをテストするために使用されます。中程度の推論強度では、GPT-6.1 Terra はタスクあたりのコストがはるかに低く、すでに GPT-5.6 Terra の最高のパフォーマンスを上回っています。
事実の正確さとプログラミング能力の大幅な向上
今年、OpenAI はモデル内の幻覚や事実誤認を減らすことに多大な努力を払ってきました。
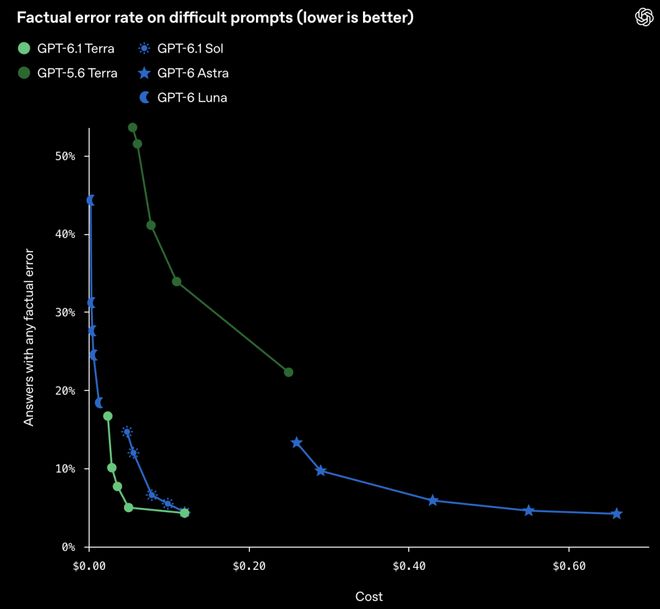
社内で設計された、エラーが発生しやすいプロンプト ワード ベンチマークでは、GPT-6.1 Terra のエラー率は、低い推論強度で GPT-5.6 Terra の 53.6% から 16.7% に 37 パーセント近く低下しました。
最高の推論強度では、エラー率も 18 パーセント ポイント低下して 4.3% となり、GPT-6 Astra および GPT-6.1 Sol のエラー率に非常に近づきました。
GPT-6.1 Terra のソフトウェア エンジニアリング機能も、GPT-5.6 Terra と比べて大幅に向上しています。
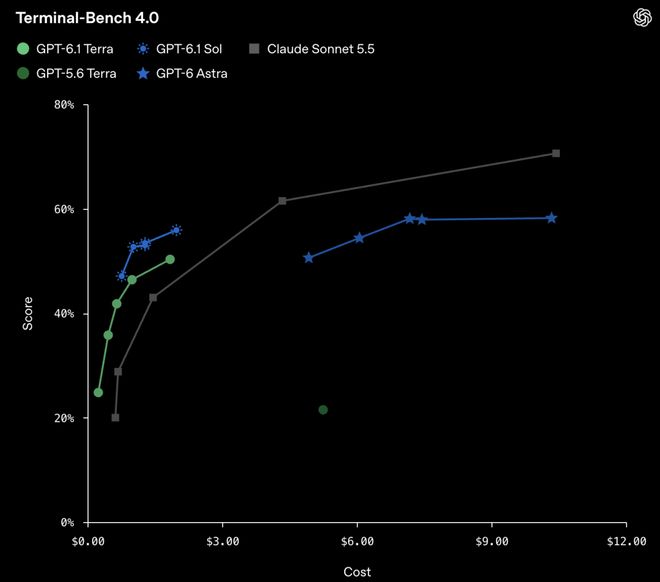
ターミナルベンチ 4.0 は、ページの読み込み時にレイアウトが変わる Web ページを修正するなど、コマンド ラインを介して問題を解決するプログラミング エージェントの能力をテストするために使用されます。最高の推論強度では、GPT-6.1 Terra はタスクの 50.3% を解決できます。これは、GPT-5.6 Terra の公開スコア 21.5% の 2 倍以上です。最も複雑なプログラミング タスクの場合は、GPT-6.1 Sol および GPT-6 Astra がより良い選択肢となります。
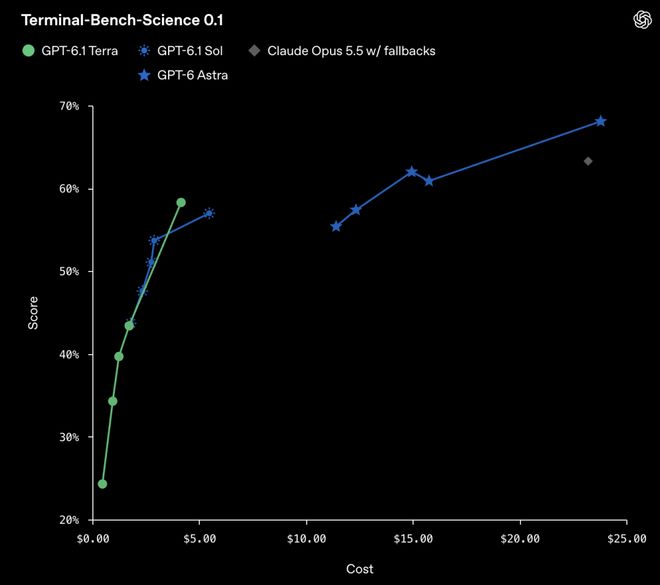
ターミナル ベンチ サイエンス 0.1 は、タイムラプス ビデオでの細胞分裂の追跡など、コードを作成して実行することによってエージェントが科学研究タスクを完了できるかどうかをテストするために使用されます。
最高の推論強度では、GPT-6.1 Terra は GPT-6.1 Sol よりも優れたパフォーマンスを発揮し、コストも低くなります。オーパス 5.5 の 5 パーセント ポイント以内のスコアで、推定コストは 5 分の 1 未満です。
セキュリティと調整
強力な AI をより効率的かつ使いやすくすると同時に、セキュリティ保護メカニズムのトレーニング、テスト、改善も継続的に行っています。
OpenAI の準備フレームワークによると、GPT-6.1 Terra は、GPT-6 Astra 用に開発されたセキュリティ保護対策を維持しながら、ネットワーク セキュリティの分野で「クリティカル」レベルの機能しきい値に達しています。
GPT-6.1 Terra は、GPT-6 シリーズのアライメントの改善も継承しています。レビューによると、GPT-5.6 Terra と比較して、GPT-6.1 Terra は操作をユーザーが指定した範囲に制限し、ユーザー自身の機能の制限と考えられる障害について正直に通知する可能性が高くなります。
プロンプト ワード インジェクション テストでは、GPT-6.1 Terra は、悪意のある指示によってモデルをユーザーの本来のタスクから逸らそうとする攻撃に対しても強い耐性を示しました。
モデルの詳細については、モデル カードを参照してください。
モデル カードのアドレス: https://deploymentsafety.openai.com/gpt-6-1-terra/gpt-6-1-terra.pdf
ブログのアドレス: https://openai.com/index/introducing-gpt-6-1-terra
コメント