要約:
最近、生成型人工知能トレーニング データの合法性をめぐる論争が再び激化しています。ニューヨーク・タイムズ紙の著作権訴訟で公開された法廷文書には、マイクロソフト社の上級研究ディレクターがかつて社内での議論の中で、現在の大規模言語モデルのトレーニング方法は「人類史上最大の労働窃盗」である可能性があると述べていたことが示されている。関連する声明は業界で広く注目を集めています。
今回暴露された発言は、マイクロソフトの応用科学担当ディレクター、ブレント ヘクト氏によるものです。最新の公開法的文書によると、Microsoft、OpenAI、その他の人工知能企業がモデルをトレーニングするために大規模なインターネット コンテンツを使用していることについて議論した際、ヘクト氏はかつてこのプロセスを「前例のない規模の驚くべき窃盗」と呼び、さらにこれは「人類史上最大の労働窃盗」である可能性があると述べた。
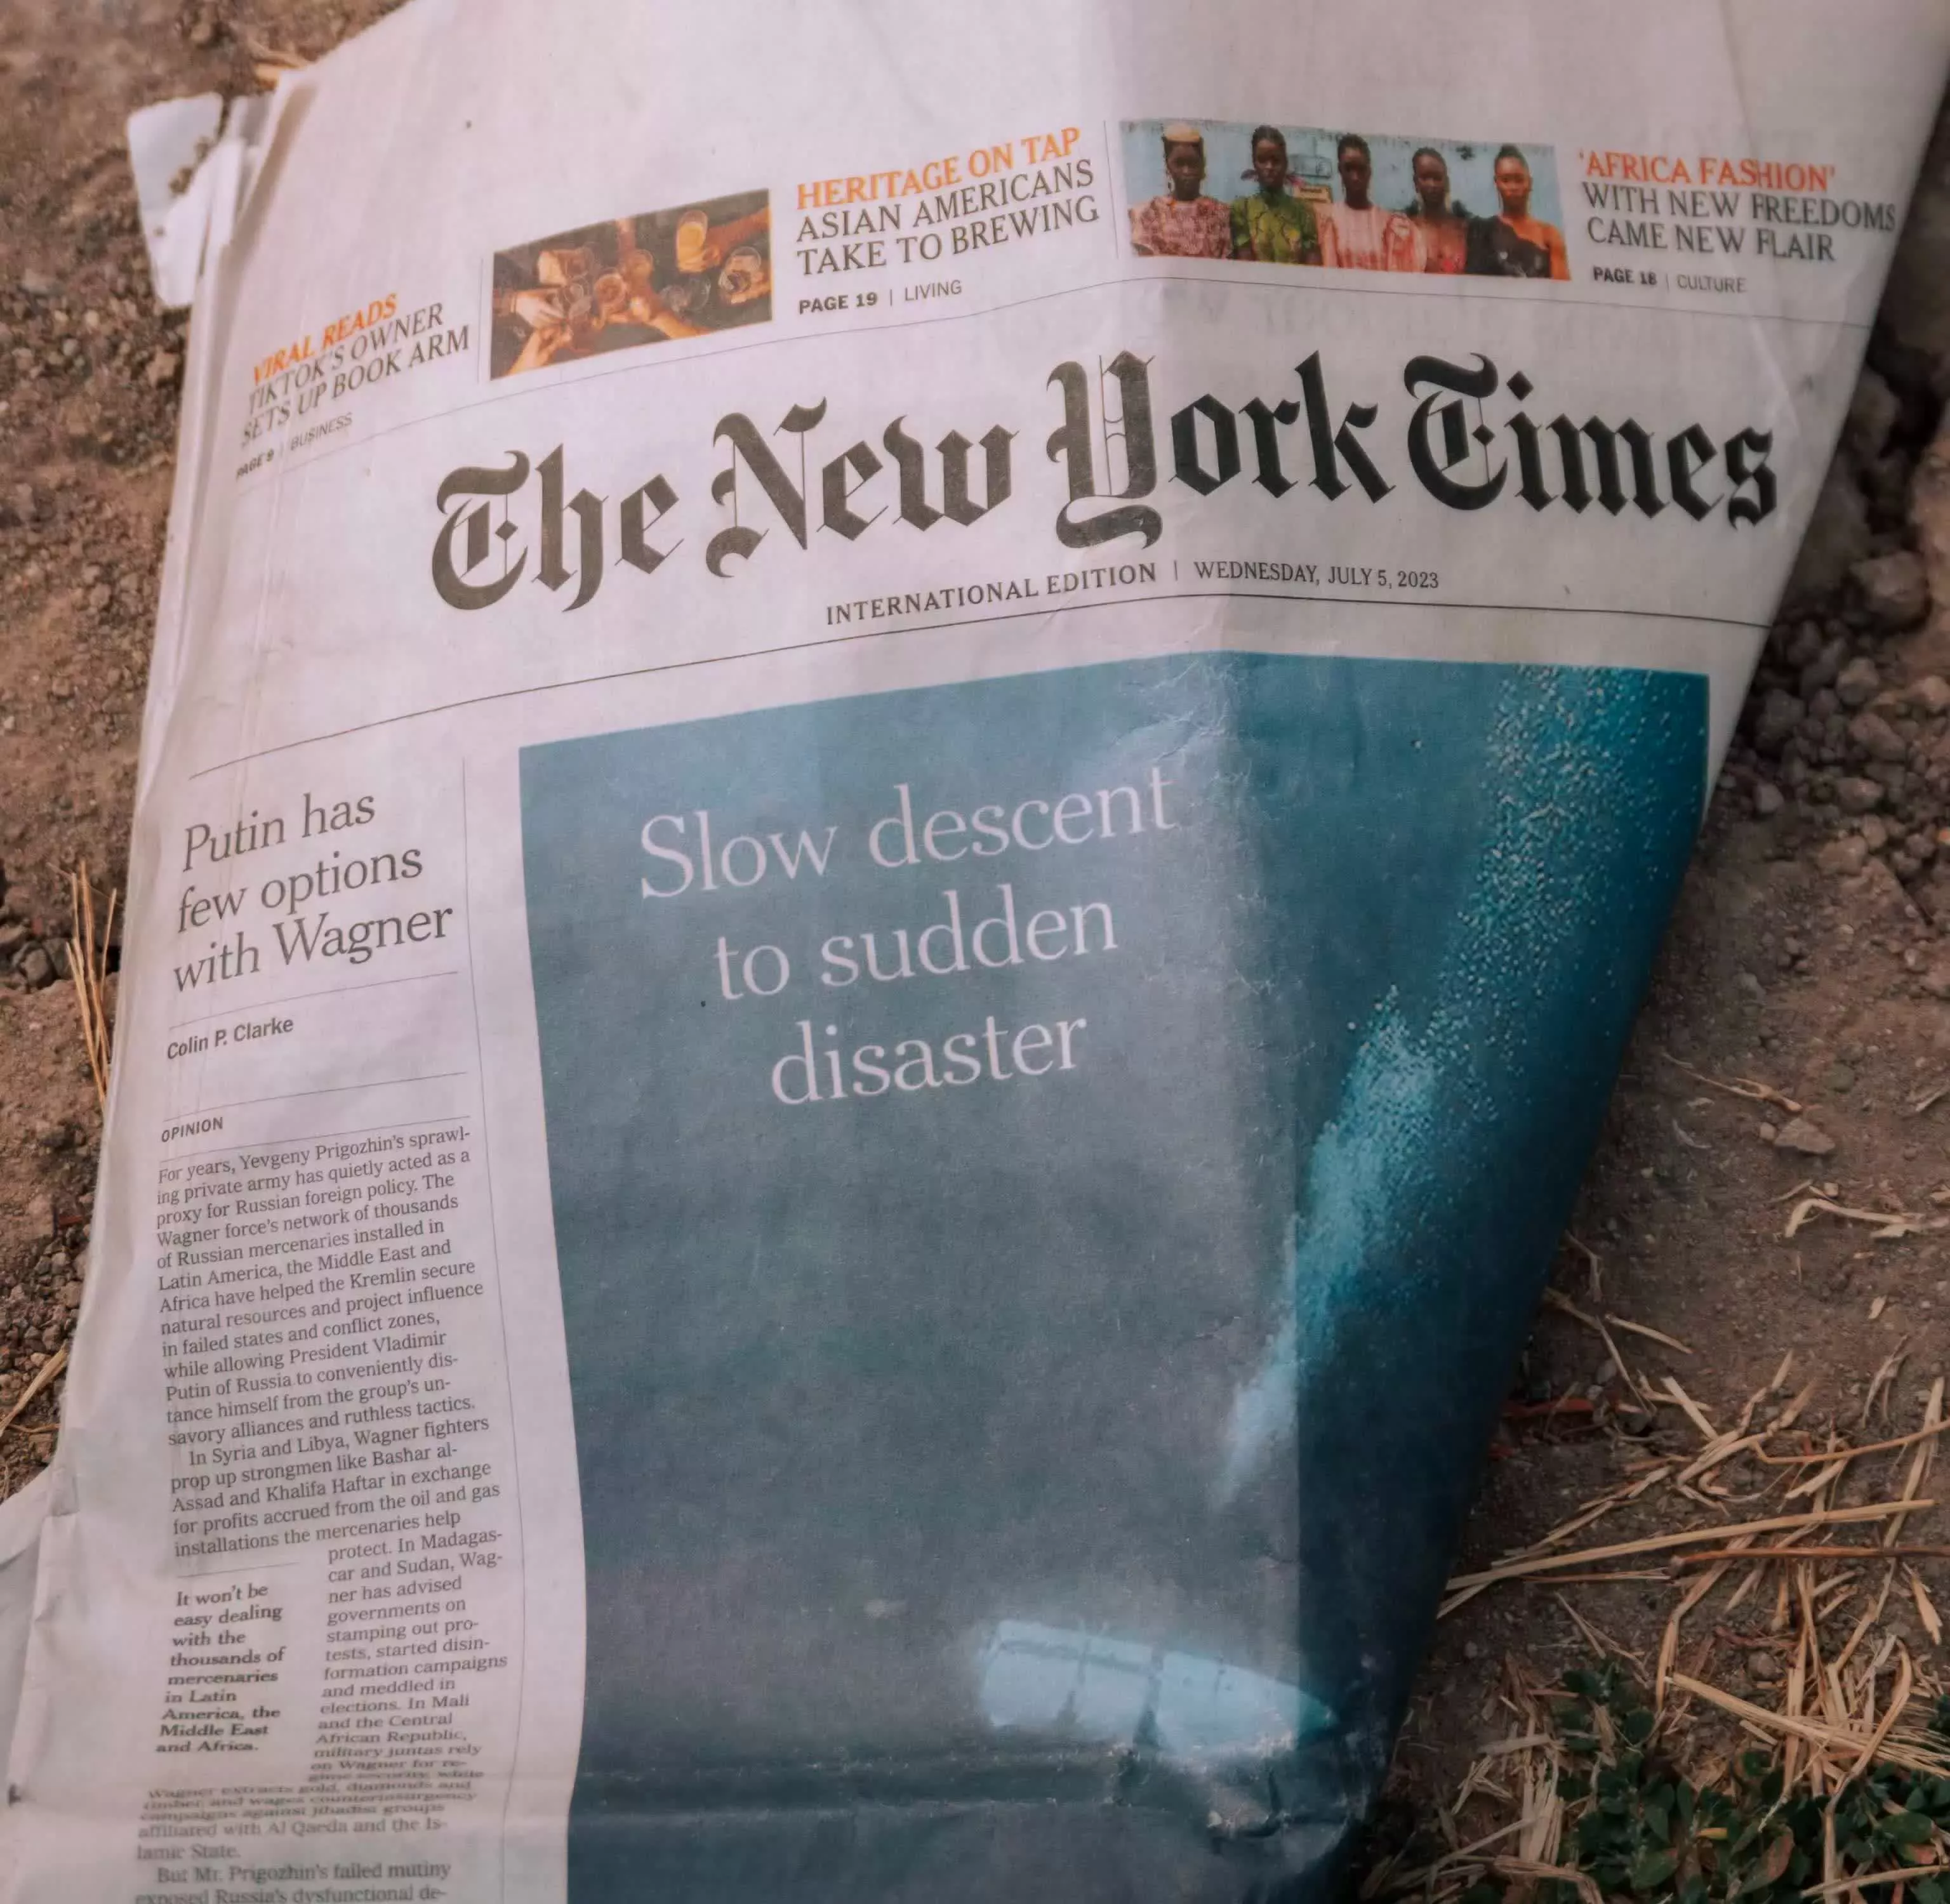
このコンテンツは、ニューヨーク タイムズおよびその他のニュース出版物が Microsoft および OpenAI に対して起こした著作権訴訟に記載されています。原告らは、両社がニュース報道やその他の著作権で保護されたコンテンツを使用して、許可なく人工知能モデルをトレーニングし、それを商用製品の開発に使用したと考えている。
Microsoft と OpenAI は、常に「フェアユース」の立場を堅持してきました。両社は、モデルのトレーニングプロセスは学生が知識を学ぶために本を読むのと似ており、フェアユースの範囲内にあると考えている。彼らはまた、AIによって生成されたコンテンツは元の素材を十分に変換しており、直接コピーには当たらないと主張している。
しかし、新たに開封された文書内の一部の内部通信記録は、この公的立場とは明らかに対照的であるように見えます。
文書によると、ヘクト氏はかつて、訴訟で勝訴するためには、関係企業は「フェアユースの概念を完全に嘲笑する」必要があるかもしれないと考えていたことが示されている。この声明は原告によって重要な証拠とみなされており、人工知能企業が長年固執してきた著作権防御の論理に疑問を呈するために使用されています。
同時に、この文書では OpenAI の内部での議論の一部も公開されました。記録の 1 つは、OpenAI の共同創設者であるグレッグ ブロックマンが、このモデルがニューヨーク タイムズのコンテンツに公開されたとき、ChatGPT は実際に関連記事内の文章を予測して継続することができたと認めたことを示しています。このタイプのコンテンツは、学習した情報を単に抽象化するのではなく、モデルが元の作品を再現する能力があることを証明するために原告によって使用されています。
訴訟文書では、人工知能産業の長期的な発展に対するヘクト氏の懸念が著作権問題自体に限定されていないことも明らかになりました。彼はかつて別の社内プレゼンテーション文書でいわゆる「終末ループ」概念を提案したことがある。
この論理に従って、人工知能応答エンジンはユーザーがニュース Web サイトにアクセスする必要性を徐々に減らし、その結果、メディア トラフィックとビジネス収益が減少します。ますます多くのコンテンツ制作組織が存続可能性を失うにつれて、人工知能システムが将来学習するための高品質の情報源も減少し、最終的にはモデルとインターネット エコシステム全体に悪影響を与えることになります。
同氏は内部文書で、製品が主要サプライヤーの経済的基盤を脅かすことは極めてまれだが、人工知能業界は現在このような状況にあると指摘した。報道機関とコンテンツ作成者は AI モデルの重要な情報源であるため、これらのグループが影響を受けると、コンテンツ サプライ チェーン全体が危険にさらされます。
原告はまた、マイクロソフトの内部データを引用し、Copilot などの AI 応答システムが一部のニュース Web サイトのトラフィックに重大な影響を与えていると主張しました。場合によっては、クリックしてニューヨーク タイムズのページにアクセスしたユーザーの割合が、従来の検索結果と比較して 90% 以上減少したこともあります。
実際、トレーニング データのソースをめぐる紛争は、現在の人工知能業界における最も重要な法的課題の 1 つとなっています。
OpenAI は以前、著作権で保護されたコンテンツに一切接触せずに高度な人工知能システムをトレーニングすることはほぼ不可能であると公に述べました。元メタ幹部のニック・クレッグ氏も同様の発言をしており、従来の著作権規則が厳格に守られれば、現在の多くのAIシステムは開発を維持することが困難になると考えている。
同時に、マイクロソフト、メタ、その他のテクノロジー企業を含む多くの企業は、トレーニング データのソースに関する問題により、引き続き外部からの批判にさらされています。一部の企業は、モデルのトレーニングにユーザー コンテンツ、コード ライブラリ、記事、画像、その他のオンライン リソースを使用し、多くの場合、関連する作成者からの明示的な許可や報酬なしに告発されています。
ニューヨーク・タイムズ紙の訴訟が続くにつれ、ますます多くの内部文書が公開されています。業界関係者らは、これらの資料はマイクロソフトとOpenAIが直面している著作権訴訟の結果に関係するだけでなく、人工知能のトレーニング、知的財産保護、コンテンツ制作者の権利と利益の分配に関する将来の世界的な規制の方向性に影響を与える可能性があると考えている。
現在、関連する訴訟はまだ審査中です。最終的な判決に関係なく、人工知能トレーニングの合法性を巡るこの法的紛争は、AI業界の将来の発展ルールを決定する上で重要なマイルストーンとなりつつある。
コメント