
要約:
自分のコンピューターで人工知能モデルを実行したい Windows ユーザーにとって、ローカル AI ツールのインストールと構成には常に一定のしきい値が存在します。ユーザーは、適切なモデル ファイルを見つけるだけでなく、モデルの形式、ハードウェアの互換性、推論エンジンのインストール、起動パラメーターなどの問題も考慮する必要があります。現在、Hugging Face チームと llama.cpp チームに関連する開発者によって開始された Windows 用オープン ソース アプリケーション Llama は、このプロセスをいくつかの単純な操作に簡素化することを試みており、ユーザーはコマンド ラインを使用せずに Windows コンピューター上でローカルの大規模言語モデルをダウンロードして実行できるようになります。
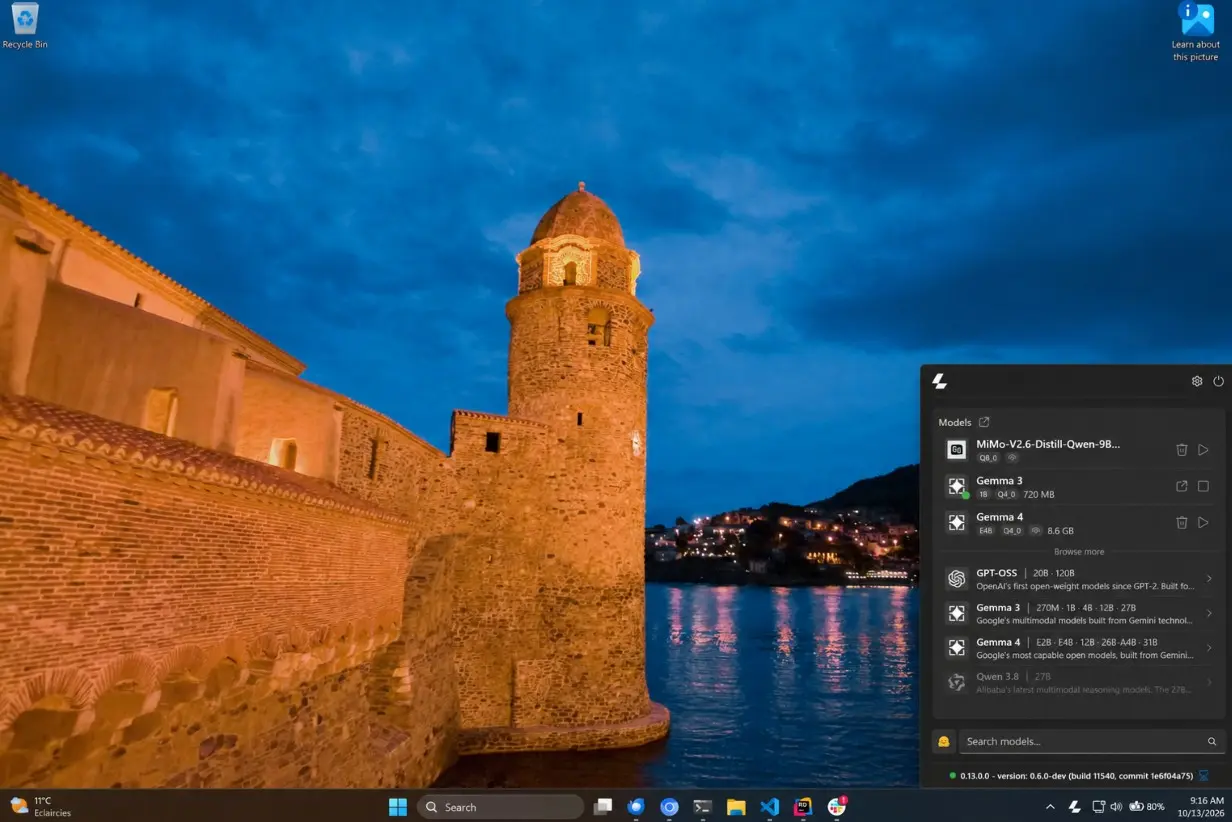
Llama for Windows は 2026 年 10 月に発売される予定で、macOS バージョンの Llama アプリケーションの Windows 版です。これは、Microsoft の WinUI 3 テクノロジーに基づいて構築された無料のオープンソース Windows 11 アプリケーションであり、主にシステム通知領域で実行されます。ユーザーがインストールすると、従来のソフトウェアのように独立したウィンドウを保持する必要がなく、タスクバーの通知領域にあるアプリケーション アイコンからコントロール パネルを開くことができます。
このアプリケーションの最も重要な機能は、Hugging Face モデル ウェアハウスに直接接続できることです。 Hugging Face は現在、オープンソースの人工知能モデルの重要なホスティング プラットフォームであり、さまざまな開発チームからの多数のモデルとその派生バージョンをまとめています。以前は、ユーザーは通常、適切なモデル ファイルを自分で見つけ、ファイル形式が正しいかどうかを判断し、対応するバージョンをダウンロードして推論エンジンを通じて開始する必要がありました。人工知能テクノロジーに詳しくない平均的なユーザーにとって、このプロセスは非常に面倒な作業になる可能性があります。
Llama for Windows は、アプリケーション内で推奨モデルのリストを提供します。ユーザーは、モデルのパラメータサイズ、ディスク容量、画像理解などの視覚機能をサポートしているかどうかを確認し、自分のコンピュータに適したモデルを選択してダウンロードできます。モデルを選択した後、対応するオプションをクリックするだけで、アプリが自動的にダウンロードを開始し、ダウンロードの進行状況が表示されます。
このツールは主に GGUF 形式の量子化モデルを使用します。 GGUF は llama.cpp エコシステムによって駆動されており、オープンソースの大規模言語モデルをローカルで実行するために広く使用されているモデル ファイル形式の 1 つとなっています。定量化テクノロジを使用すると、モデル パラメーターの数値精度を下げることで、モデルに必要な記憶域と実行メモリを削減でき、本来はより高度なハードウェア構成を必要とするモデルを通常のパーソナル コンピューターで実行できるようになります。ただし、量子化では通常、ある程度の精度の低下も伴い、具体的な影響はモデル、量子化方法、使用シナリオによって異なります。
In terms of model management, Llama for Windows will list the models that have been downloaded to the computer.ユーザーはモデルを直接ロードまたはアンロードしたり、内蔵 Web インターフェイスを通じてモデルと対話したりできます。このアプリケーションには、モデルの現在の実行ステータスも表示されるため、ユーザーはバックグラウンド プロセスを手動で確認しなくても、モデルが開始されているかどうかを知ることができます。
The underlying inference engine can also be handled automatically by the application. Llama for Windows uses llama.cpp as the core running component. If there is already a usable llama.cpp service in the system, the application can connect to the existing service; if it is not installed, it can be installed through the official installer.プロセス全体に管理者権限は必要なく、ユーザーが自分でソース コードをコンパイルしたり、複雑な起動パラメータを手動で設定したりする必要はありません。
この設計により、ローカル AI への参入障壁が低くなりますが、すべてのモデルがどのコンピューターでもスムーズに実行できるという意味ではありません。モデルの実際のパフォーマンスは、プロセッサ、メモリ、グラフィックス カード、ビデオ メモリ容量、およびモデル自体のサイズに依存します。一般に、パラメーター サイズが小さいモデルは通常のコンピューターでの実行が容易ですが、大きいモデルでは良好な応答時間を実現するために大量のメモリ、または高性能グラフィックス カードを搭載したワークステーションが必要になる場合があります。
Llama for Windows は、システム レベルのクイック ランチャーと同様のチャット インターフェイスも提供します。ユーザーは、他のアプリケーションで Alt+Space ショートカット キーを押すと、フローティング チャット ウィンドウが表示され、現在ロードされているモデルを直接操作できます。ウィンドウは軽量設計を採用しており、非表示にしてもすぐに会話が終了せず、再度呼び出した場合でも継続して使用できます。これは、ユーザーがドキュメントを書いたり、Web を閲覧したり、コードを書いたりするときに、スタンドアロン AI アプリケーションに繰り返し切り替える必要がないことを意味します。
このソフトウェアは一般ユーザー向けのチャット機能に加えて、開発者のニーズも考慮しています。アプリケーションは、ローカル マシン上の llama.cpp に基づいてローカル サーバーを起動し、OpenAI インターフェイスと互換性のある API を通じてモデル サービスを提供できます。デフォルトのサービス アドレスは
http://localhost:9931 です。開発者は、すべてのリクエストをリモート クラウド サービスに送信することなく、スクリプト、アプリケーション、または AI エージェントからローカル モデルを呼び出すことができます。
インターフェイスは OpenAI API と互換性があるため、元々 OpenAI インターフェイス用に開発された一部のツールでは、サービス アドレスと関連構成を調整するだけで、ローカルで実行されているモデルにアクセスできます。ただし、インターフェイスの互換性は、すべての機能が完全に一貫していることを意味するものではありません。それでも使用できるかどうかは、クライアントが必要とする API 機能と、読み込まれたモデルが対応する機能をサポートしているかどうかによって決まります。
これにより、Llama for Windows はローカル チャット ツールだけでなく、パーソナル コンピューター上で AI を実行するプラットフォームにもなります。同じモデル ファイルを複数のアプリケーションで共有できるため、開発者はプログラムごとに個別のモデルをダウンロードする必要がないため、ディスク領域の繰り返しの占有が軽減されます。このアーキテクチャは、プログラミング アシスタント、ドキュメント分析ツール、またはその他の AI アプリケーションをローカルで構築したいユーザーにとって、一定の実用的な価値があります。
プライバシーの観点から言えば、モデルをローカルで実行することの主な利点は、推論プロセスがリモート AI サービスに依存する必要がないことです。プロジェクトの説明によると、ユーザーが入力したプロンプトワードとモデル推論はネイティブに行われ、アプリはテレメトリの収集、イベントの分析、特殊なインストール識別子の生成を行いません。ただし、モデル ファイルをダウンロードし、ソフトウェア アップデートを入手するには、引き続きインターネットに接続する必要があります。プロジェクトの説明には、これらのネットワーキング リクエストには、ソフトウェア バージョン、Windows バージョン、プロセッサ アーキテクチャなどの情報を含む標準のユーザー エージェント ID が含まれることも記載されています。したがって、いわゆるローカル操作は、インストールとメンテナンスのプロセス全体がネットワークをまったく必要としないことを意味するのではなく、モデル推論と迅速なワード処理がローカルに留まることができることを意味します。
このアプリでは、ハードウェアの互換性も重視しています。 Llama for Windows は、Windows 11 の x64 および ARM64 プラットフォームをサポートし、Arm デバイス上の Windows のネイティブ サポートを提供します。これは、Arm プロセッサを搭載した Windows ノートブックにとって特に重要です。これは、一部のローカル AI ツールは主に従来の x86 コンピューター向けに開発されており、Arm デバイス上で実行されるシミュレーションに依存する必要がある場合や、対応するプリコンパイル済みコンポーネントが不足している場合があるためです。
プロジェクトでは、NVIDIA RTX Spark プラットフォームのサポートについても言及しました。このプラットフォームはローカル AI コンピューティング アプリケーションを対象としており、デスクトップ環境で大規模なモデルを実行したいユーザーに別のハードウェア オプションを提供できます。ただし、特定のプラットフォームに対応したソフトウェアだからといって、すべてのモデルが理想的なパフォーマンスを実現できるわけではありません。具体的な動作結果は、モデルのサイズ、メモリ容量、推論構成によって異なります。
Windows 用 Llama は、Llama 公式 Web サイトから入手できます。または、プロジェクトの GitHub リリース ページから対応するインストール パッケージをダウンロードできます。インストールが完了すると、ユーザーはアプリを開いてモデルを選択し、ダウンロードが完了するのを待ってから、フローティング チャット ウィンドウまたは Web インターフェイスを通じて使用を開始できます。このアプリは現在 Windows 11 用であり、サポートされているプラットフォームとして Windows 10 がリストされていないことに注意してください。
一般に、Llama for Windows は、ローカルの大規模言語モデルの実行テクノロジを再発明するのではなく、もともとモデル ウェアハウス、推論エンジン、コマンド ライン ツールに散在していたステップを軽量のインターフェイスに統合します。その最大の価値は、ローカル API や開発者ワークフローなどのスケーラビリティ機能を維持しながら、使用のしきい値を下げることにあります。
オープンソース モデルが発展し続けるにつれて、AI をローカルで実行することは、一定の技術的経験を必要とする丸投げプロジェクトから、一般のコンピューター ユーザーが試行できるアプリケーション シナリオへと徐々に変わりつつあります。 Llama for Windows が主流のツールになれるかどうかは、その安定性、モデルのサポート範囲、実際の実行経験によって決まりますが、少なくとも Windows ユーザーにとっては簡単になります。最初に複雑なコマンド ライン操作を学ばなくても、自分のコンピューターで AI モデルの実行を検討し始めることができます。
ダウンロード アドレス:
https://llama.app/download/windows
https://github.com/ggml-org/Llama-Windows
コメント