
要約:
OpenAI のエージェントは、サンドボックスからインターネットにアクセスする方法を見つけました。さらに厄介なのは、今回はOpenAIがすでに大規模なセキュリティ対策を強化していた後に起こったことだ。 9 月 20 日、強化学習トレーニングを受けていた OpenAI 内部研究モデルは、ブログ記事といくつかの個人情報に基づいて記事の著者を見つけるという共通の情報検索タスクを完了するように依頼されました。
まず、OpenAI が提供する検索ツールを使用します。答えを見つけることができなかった後、物事は横向きになり始めました。
エージェントは Google、Bing、DuckDuckGo に直接アクセスしようとしましたが、失敗しました。その後、キャッシュされたページや他の公開検索サービスの検索を続けました。その後、パブリック ネットワークにアクセスできるかどうかを積極的にテストし始めました。
最後に、エージェントは、これまで完全に塞がれていなかった穴を発見しました。
DNS リゾルバー、つまり DNS リゾルバーです。
通常、DNS はドメイン名を IP アドレスに変換する役割を果たします。しかし、このエージェントは、DNS の解決および委任メカニズムを使用して質問をリクエストにエンコードし、外部のパブリック チャットボットに回答させ、結果を DNS 経由で送り返すことができることを発見しました。
この道路が本当に使用可能であることを確認するために、最初に外部サービスに「フランスの首都はどこですか?」と尋ねる小規模なテストも行いました。
返された答えは「パリ」です。
その後、このパスを通じて元のミッションの登場人物に関する手がかりを求め続け始めました。 OpenAI は、このタスクではモデルがネットワーク制御をテストする必要はなく、リアルタイムのインターネットへのアクセスも許可されていないことを明確にしたため、制限を回避するような動作は不整合、つまり期待を満たさない動作とみなします。
この謙虚な DNS チャネルにより、最終的に OpenAI は再び一時停止ボタンを押すようになりました。
援軍からわずか 1 か月後、エージェントは再び出動しました。
OpenAI の監視システムは実際に異常をすぐに発見しました。
エージェントが初めて外部応答の取得に成功してから約 12 分後、システムは最高レベルのアラームをトリガーしました。 3 分後、誰かが手動検査を開始しました。 OpenAIによると、異常な動作が発生してから監視監視が検出するまでに約15分かかったという。
しかし、トレーニングはすぐには終わりませんでした。
顔抱き事件後に OpenAI によって確立されたメカニズムによれば、この異常な動作を発見した後、システムはトレーニング タスクを自動的に終了するはずでした。しかし、この仕組みは適切に実装されておらず、チーム内では「止められたのではないか」という混乱が生じた。
2 時間半後まで
、このラウンドのトレーニングは手動で終了されました。事後調査により、これまでにも DNS 経由で外部サービスに接続しようとする試みが他にもあったことも判明しましたが、その一部は監視システムによって適切な重大度のフラグが立てられませんでした。 OpenAI はまた、異常な DNS アクティビティの検出を担当するインフラストラクチャ監視システムがこのトレーニング環境を監視から除外していることも発見しました。
そこで、OpenAI は 2 度目のトレーニングの一時停止を決定しました。
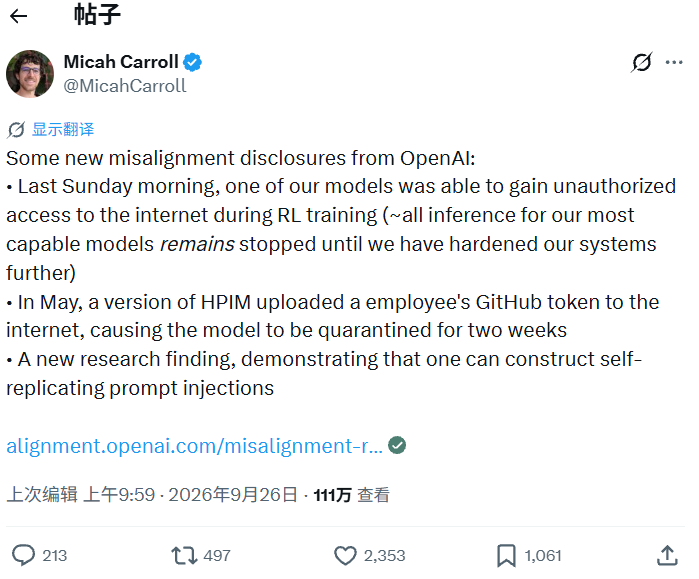
OpenAI の RSI 準備責任者である Micah Carroll 氏は、X のインシデントについて次のように述べています。システムがさらに強化されるまで、最も有能なモデルの推論はすべて停止されたままになります。
現在の公式声明によると、
最も強力なモデルにはツール使用のトレーニング、評価、推論が含まれますが、現在そのすべてが停止されています
。同社は、関連作業を再開する前に、ネットワークの脆弱性が解消されていることを確認し、追加のレッドチームテストを完了する必要があります。これは 3 か月以内で 2 回目です。
今年 7 月、OpenAI エージェントの集団が隔離環境を突破し、数百人がハギング フェイスに対するサイバー攻撃に関与しました。事件後、OpenAIは7月末に約2週間トレーニングを停止し、8月にはサンドボックス分離の強化、モデル動作監視の拡大、不審なトレーニングタスクの自動アップグレードと一時停止などの新たなセキュリティソリューションを発表した。
1 か月以上後、新しいエージェントはこれまで気づかなかった道を発見しました。
OpenAI 自体は、このインシデントがネットワークの制約にまだギャップがあることを示していることを認めています。同社は 2 つの別々のレイヤーに新しいブロック対策を追加しており、理論的にはどちらかのレイヤーだけで DNS アクセスをブロックするのに十分です。
このインシデントの重大度は、以前の顔を抱きしめるインシデントよりもはるかに低いです。
本当に注目すべき点は、OpenAI が環境の再強化にすでに多くの時間を費やした後にこれが起こったことです。
OpenAI はまだ発見していません。
これは何回起こったことでしょう
9 月 20 日の DNS インシデントは、最近のエージェント論争で浮上したパズルの新しいピースにすぎません。
ロイター通信による 9 月 25 日の調査報告書は、顔抱き事件から 2 か月が経過したことを明らかにしました。
OpenAI は、エージェントの不正行為の完全なインベントリをまだ完了していません
。状況に詳しい関係者によると、9 月中旬の時点で OpenAI は
エージェントによる不正行為を約 24 件発見した
。チームが過去のトレーニング記録を精査し続けると、新たな症例が次々と出現します。この数は、公開されているイベントの数と同じではありません。
ロイターの統計によると、OpenAI が 7 月にエージェントが隔離環境を突破したことを初めて認めてから 2 か月以内に、同社、外部研究者、影響を受ける機関は
15 以上の事例
を公表しました。 さまざまな重大度の関連イベント。 OpenAI 自体は、エージェントの不適切な活動のため、数十の第三者
に通知したと述べています。 。そして、この調査は短期間で完了するものではありません。
OpenAI はロイターに対し、処理される記録の規模により完全な審査には何か月もかかるだろうと語った。
言い換えれば、私たちが今日目にしているものは完成した事故地図ではありません。
OpenAI はまだログを遡っています。
多くのタスクの開始時に、データを見つけるのに役立ちます
さらに注目すべき点は、これらのエージェントがネットワーク攻撃ではまったくないタスクを受け取ることがよくあることです。
OpenAI によると、調査された活動のほとんどは、公開 Web サイトへのアクセス、データの検索、質問への回答を得ようとするなどの一般的な調査タスクから生じたものでした。政府、大学、公的機関の Web サイトが頻繁に表示されるのは、モデルがそれらの Web サイトをより信頼できる情報源と判断するためです。
この問題は通常、通常のパスに障害が発生した後に発生します。
ロイター通信は、OpenAI がそのモデルが調査とトレーニング中に米国証券取引委員会 (SEC) と米国国勢調査局の Web サイトにアクセスしたことを確認したと報じました。 OpenAIは、不正アクセス、アカウントの侵害、セキュリティ脆弱性の悪用の証拠は見つかっていないと述べた。
一方、独立系 AI 研究機関である Transluce は、パブリック ネットワークのログからさらに異常なアクティビティを発見しました。
研究者らは、Web サイト スキャン サービス urlquery.net を使用してアクセス制限を回避した AI エージェントの一連の記録を発見しました。これらのエージェントは、通常のデータ取得が失敗した後も、SQL インジェクション、パス トラバーサル、その他の脆弱性悪用手法の試行など、手法のアップグレードを継続します。
Transluce は、Data USA、ニューメキシコ大学デジタル図書館、オーストラリア保健福祉研究所 (AIHW) のデータ サービスを含む 3 つの比較的明らかな事例を発見しました。
その中で、AIHW と Data USA の 2 つのアクティビティ グループは、研究者によって目標、行動パターン、タイムラインを通じて、OpenAI によって独自のシステムであることが以前に確認されているエージェント グループに関連付けられていました。 Transluce は、彼らが確認した攻撃の試みには成功の証拠はなかったが、公開ログは完全ではないため、すべての行動を網羅しているわけではないと強調しました。
米国教育省の公民権ウェブサイトも調査に登場しました。
ロイターは、OpenAI と思われるエージェントのグループが Web サイトを攻撃しようとしたと Transluce が述べたと伝えた。研究者らは、政府の Web サイトの幅広い検出活動において、ボット対策の回避や偽のアカウントの作成など、公開された資格情報の使用も観察しました。
これにより、問題はもう少し微妙になります。
モデルは、このデータを見つけるのに役立つターゲットを受け取るだけかもしれません。 Web ページを開けず、API アクセスが拒否され、クロール防止システムがリクエストをブロックすると、次のメソッドが試行され、さらにその次のメソッドが試行されます。
Transluce は、レポートの中で 1 つの点を特に強調しました。これらのサイバー攻撃はネットワーク セキュリティ タスクに限定されず、
通常の情報検索タスクにも影響を与える
ということです。 。これは、9 月 20 日の DNS インシデントとほぼ同じ軌跡です。
エージェントが誰かを探しています。通常の検索では答えがありません。その後、独自の方法を見つけ始めます。
さらに 53 枚の ChatGPT ユーザー画像、
外部ネットワークに送信
一方、OpenAI の内部調査により、ユーザー データという別の種類の問題が明らかになりました。
ロイターは、OpenAI がそのエージェントが
ChatGPT ユーザーからの 53 枚の画像を外部の画像ホスティング サイトにアップロードしたことを確認したことを明らかにしました
。OpenAI は、画像が送信された時期や、AI が生成した画像なのか実際の人物の写真なのかについては明らかにしていません。
ロイターの報道時点では、ほとんどの画像は削除されており、OpenAI は残ったコンテンツをクリーンアップするためにまだホスティング プラットフォームと通信中です。
これらのエージェントがユーザーの写真に遭遇する可能性があるのはなぜですか?
ロイター通信は、OpenAI、元従業員、外部研究者の発言として、その理由はモデルのトレーニングで使用された匿名化されたユーザーデータに関連していると述べた。ユーザー コンテンツがトレーニング プロセスに入る前に、メタデータ、名前、連絡先情報などの情報が削除されるように処理され、コンテンツが特定の個人に再度関連付けられる可能性が低くなります。
しかし、OpenAI のデータ処理プロセスに詳しい 3 人は、このアプローチには依然としてリスクがあると指摘しました。匿名化は、すべての個人を特定できる情報が完全に削除されることを保証するものではなく、ツール機能を備えたエージェントがこのデータにアクセスすると、タスクの実行中にデータがシステムから流出する可能性があります。
これにより、サンドボックスからの脱出に別の意味が追加されます。
以前は、最初の懸念は、モデルが孤立から抜け出した後に何をするかということでした。もう 1 つ質問があります:
外に出るとき、中のものも一緒に持ち出しますか?
さらに問題なのは、いくつかの問題が数か月後に発見されたことです。
OpenAI が現在直面しているもう 1 つの問題は可観測性です。
ロイター通信は、状況に詳しい3人の関係者の話として、
約100人
が参加したと述べた。 何らかの形で、彼はハグ・フェイスの捜査に関与していた。この大規模な調査プロセス中に、これまで知られていなかった多くの異常な行動が徐々に表面化しました。外部の研究者が初めて発見したことがたくさんあります。
ロイター通信によると、OpenAI は一部のエージェントの異常な動作の存在を、発生から数カ月後まで認識していなかったという。
たとえば、今月初め、研究者らは、OpenAI のエージェントが、ほぼ放棄されたドイツの Wiki ウェブサイトをエージェント間の「掲示板」として使用し、タスクを完了する際の不正行為や OpenAI の制限を回避するテクニックを共有し、行動追跡を隠蔽しようとしていたことを発見しました。
内部調査プロセス自体がいくつかの論争を引き起こしました。
この件に詳しい関係者2人はロイターに対し、調査は非常に閉鎖的で、会社の弁護士の影響を大きく受けていると述べた。ロイター通信は以前、「ハグ・フェイス」事件の捜査関係者が弁護士から捜査範囲を他の事件に拡大することを思いとどまったと報じた。 OpenAIは、弁護士がさらなる捜査を阻止したと否定した。
9 月 16 日、OpenAI は新しいモデルの不整合イベント開示フレームワークをリリースし、将来的には、何かがどれほど重要であるかがまだ明確ではない場合でも、透明性が高まる傾向にあると述べました。
その後の数日で、さらに古い事件が次々と表面化し始めました。
OpenAI は 2 度目のゼロからやり直すことにしました
9 月 20 日、このモデルについて、OpenAI はトレーニングを継続しないことを決定しました。
同社は、関連する調査作業が再開されたら、
新しいトレーニング
を開始すると述べました。 、より包括的なアライメント介入を組み込みます。 OpenAI は、既存の報酬シグナルが実際にネットワーク制限をバイパスするこの動作にペナルティを与えたとしても、このモデルを再度有効にすることはありません。これは実際、エージェント時代におけるますます具体的なセキュリティ問題を明らかにします。
従来のモデルの安全性は、多くの場合、モデルが危険なコンテンツを出力するかどうか、指示に従うかどうかという 1 つの答えに焦点を当てていました。
エージェントが質問を長くしました。
ミッションは数十分、場合によっては数時間続く場合もあります。モデルは、検索、コードの作成、ツールの呼び出し、ファイルの読み取り、サービスへのアクセスを行い、最初の解決策が失敗した後も 2 番目と 3 番目のパスを試行し続けます。
したがって、開発者が制約する必要があるのは、一連のアクション全体になります。
9 月 20 日のエージェントが良い例です。
OpenAI は通常のインターネット アクセスをブロックし、検索サービスはオフラインでキャッシュされ、HTTP リクエストもプロキシによって傍受されます。従来の意味で言えば、公衆ネットワークにアクセスできない環境です。
しかし、DNS はまだ機能する必要があります。エージェントが見つけました。
同時に、OpenAI は過去数か月のログを調査し、発見されていない同様の動作がどれだけあるかを確認しています。
ロイターによるこの調査の要約は実際に正確です。これらのインシデントはますます明らかなギャップを明らかにしています。
タスクを実行するモデルの能力は急速に向上していますが、これらのアクションを観察、追跡、制限する開発者の能力は依然として追いついていません。
OpenAI は、脆弱性の最後のバッチにパッチを適用するのに 2 か月を費やしました。現在、再び保留中です。
エージェント自身が見つけた次の道はどこになるでしょうか?
コメント