
要約:
長い間、テレビ、モニター、スマートフォンなど、画像や音声はさまざまな場所から来ることがよくありました。視聴者にはキャラクターが画面上で話しているのが見えますが、音声は通常、画面下のスピーカーまたは外部の音響機器から聞こえます。今回、韓国の研究チームは、この問題を完全に解決するために、画像内の音声位置から直接音声を発することができる新しいディスプレイ技術を開発し、より没入型の視聴覚体験をもたらしました。
韓国機械材料研究院 (KIMM) の研究者らは最近、モジュール式グリッド構造に基づいた「視聴覚融合ディスプレイ技術」を発表しました。この技術は、表示パネルの背面に複数の振動アクチュエータを設置することで、画面自体が大型スピーカーとなり、画面の特定の領域から発せられる音を正確に制御することができます。
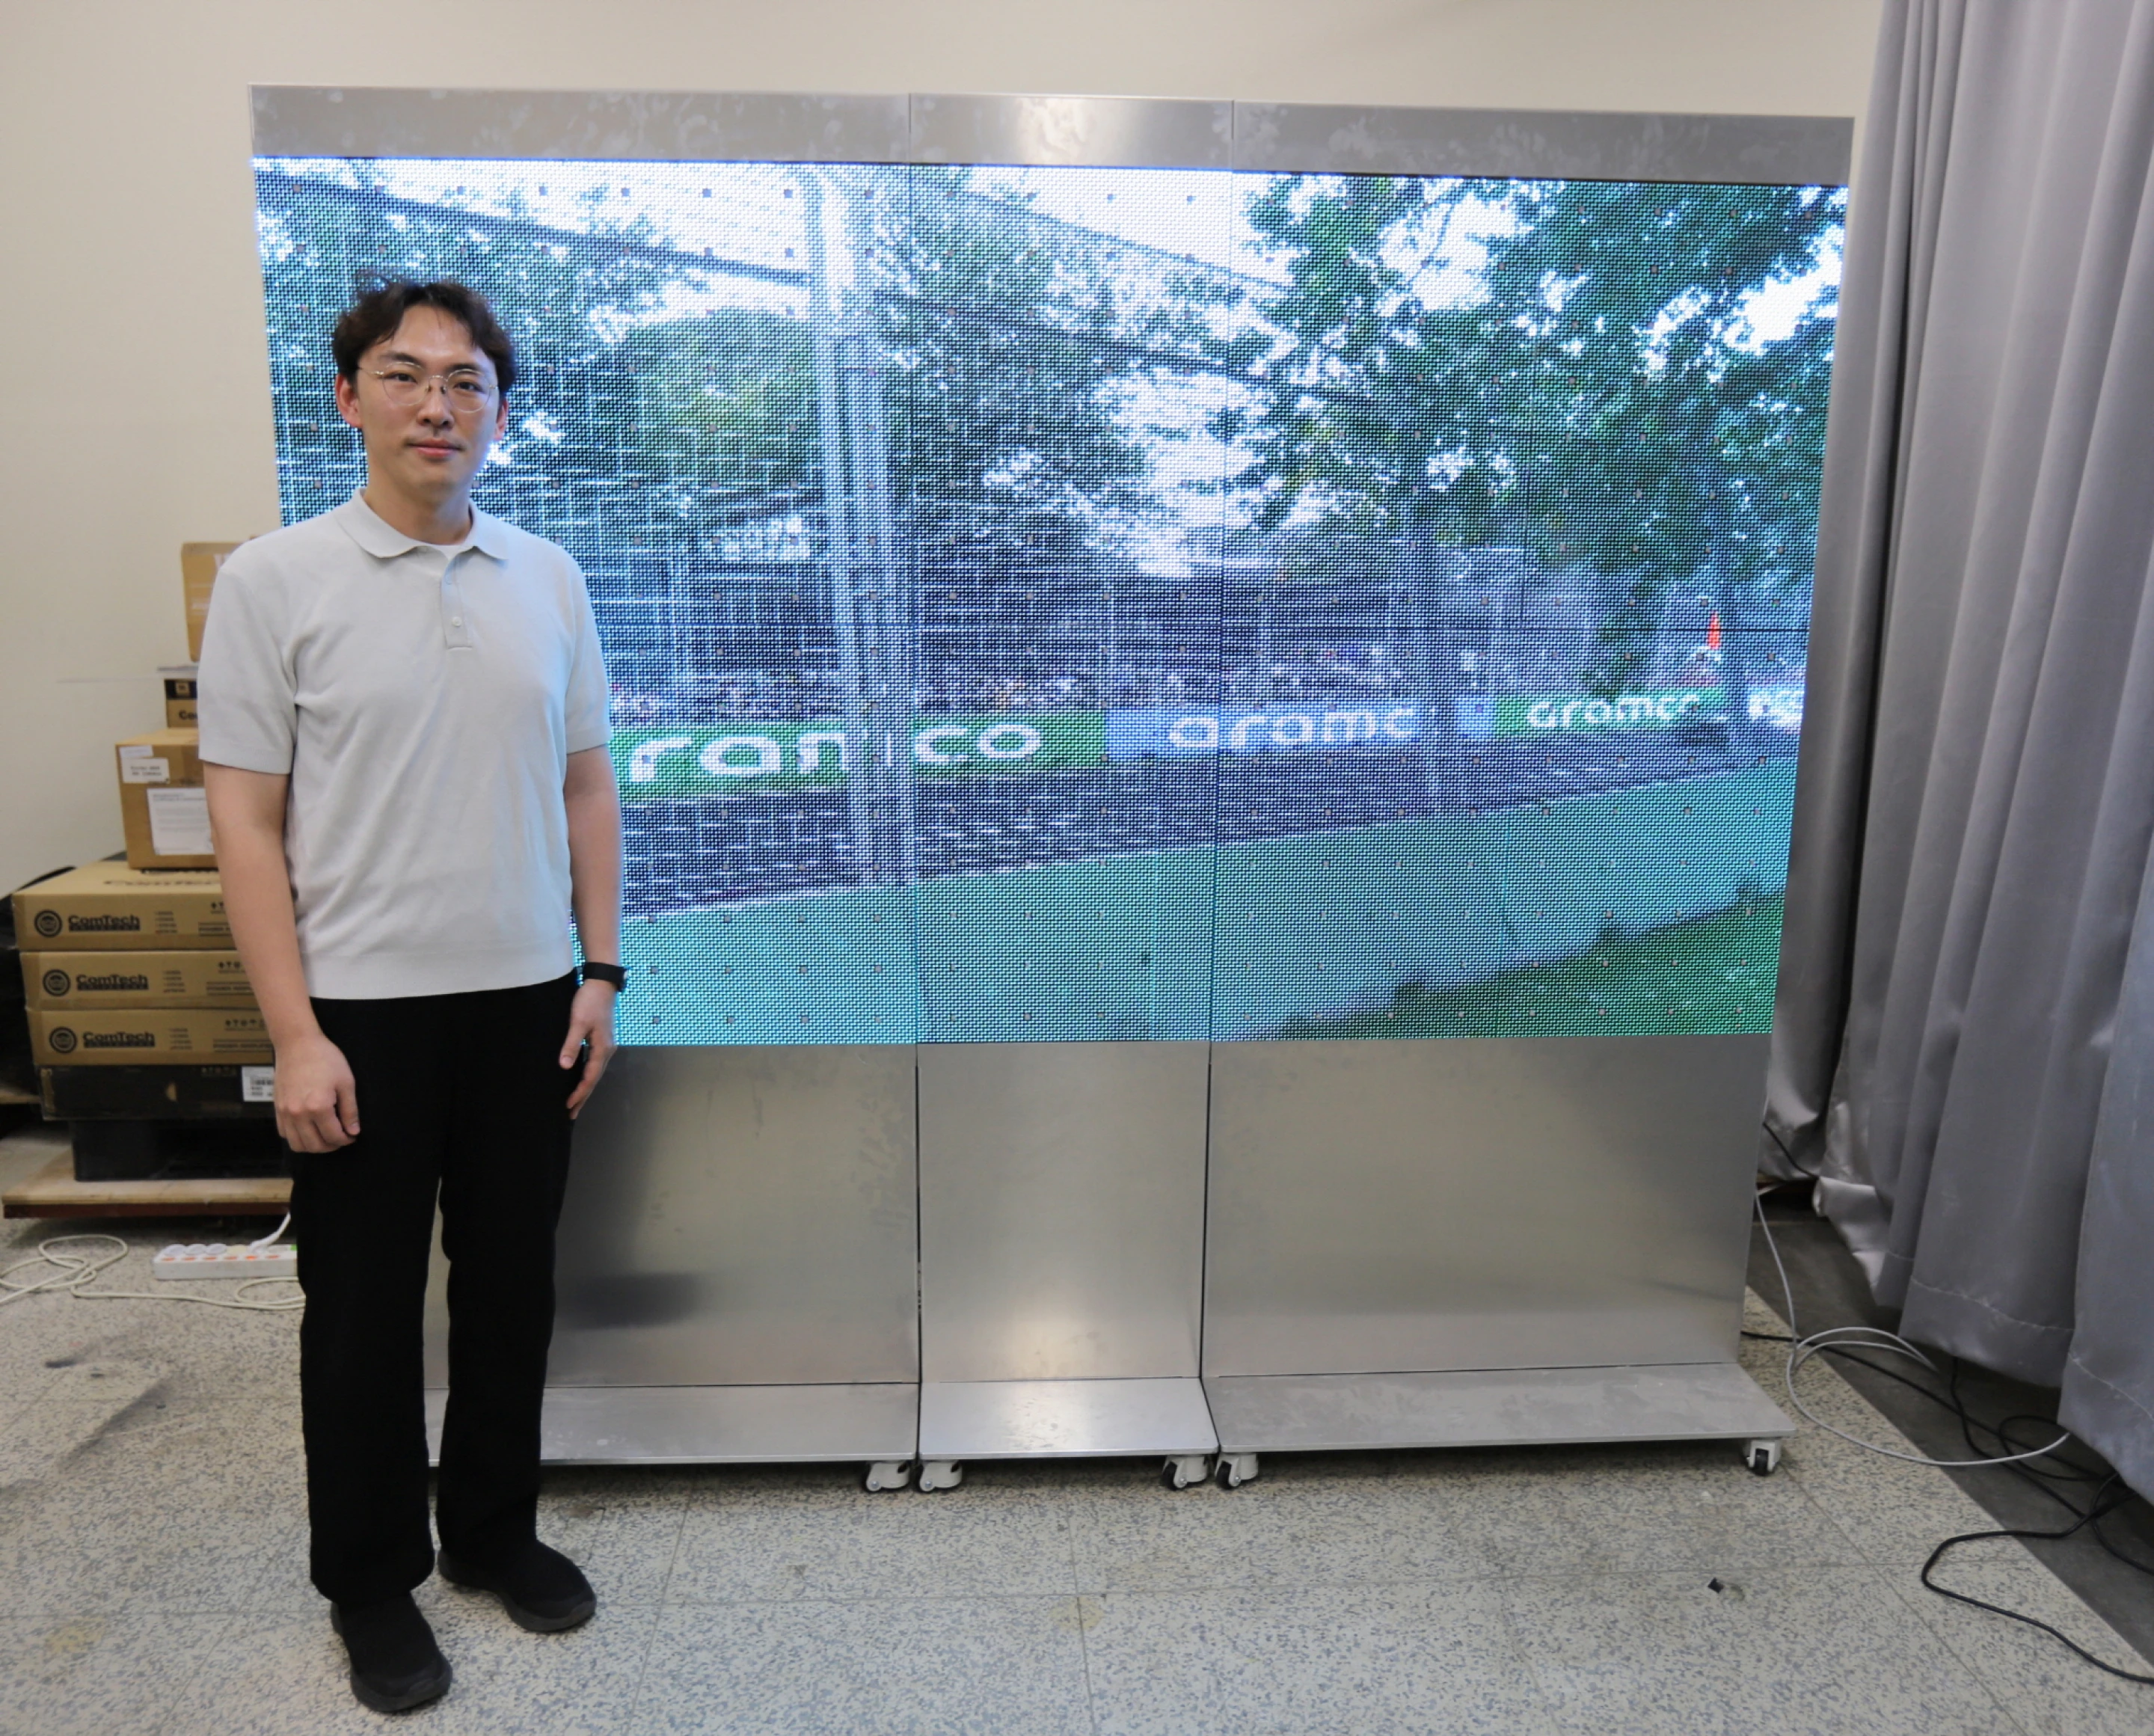
これは、誰かが画面の左上隅で話しているとき、その人の声も、あたかもキャラクターの口の位置から直接発せられているかのように、対応する領域からも同期して送信されることを意味します。映像の内容の変化に合わせて、音の放射エリアもリアルタイムに移動できます。たとえば、球体が画面の一方の側からもう一方の側に急速に飛行すると、音も同じ軌道に沿って移動するため、空間感と臨場感が高まります。
研究者らは、人間は自然に音源と現実世界の視覚的ターゲットを関連付けると指摘しています。音自体に指向性があるため、人々は落ちた物の位置を特定することができ、目を閉じていても誰が話しているのかを知ることができます。しかし、既存の表示デバイスの視覚情報と音源は通常互いに分離されており、この不一致は常に没入体験に影響を与えます。
ステレオおよびサラウンド サウンド システムは、複数のスピーカーによって方向感を作り出すことができますが、サウンドは依然として主に画面の周囲に配置されたデバイスから発せられ、大型モニターでは画像内の特定の位置に完全に対応することは困難です。これまでにも、ディスプレイ パネルからサウンドを直接放射できるようにするソリューションがいくつかありましたが、サウンドの出力ポイントは通常固定されており、画面サイズや周波数範囲によって簡単に制限されてしまいます。
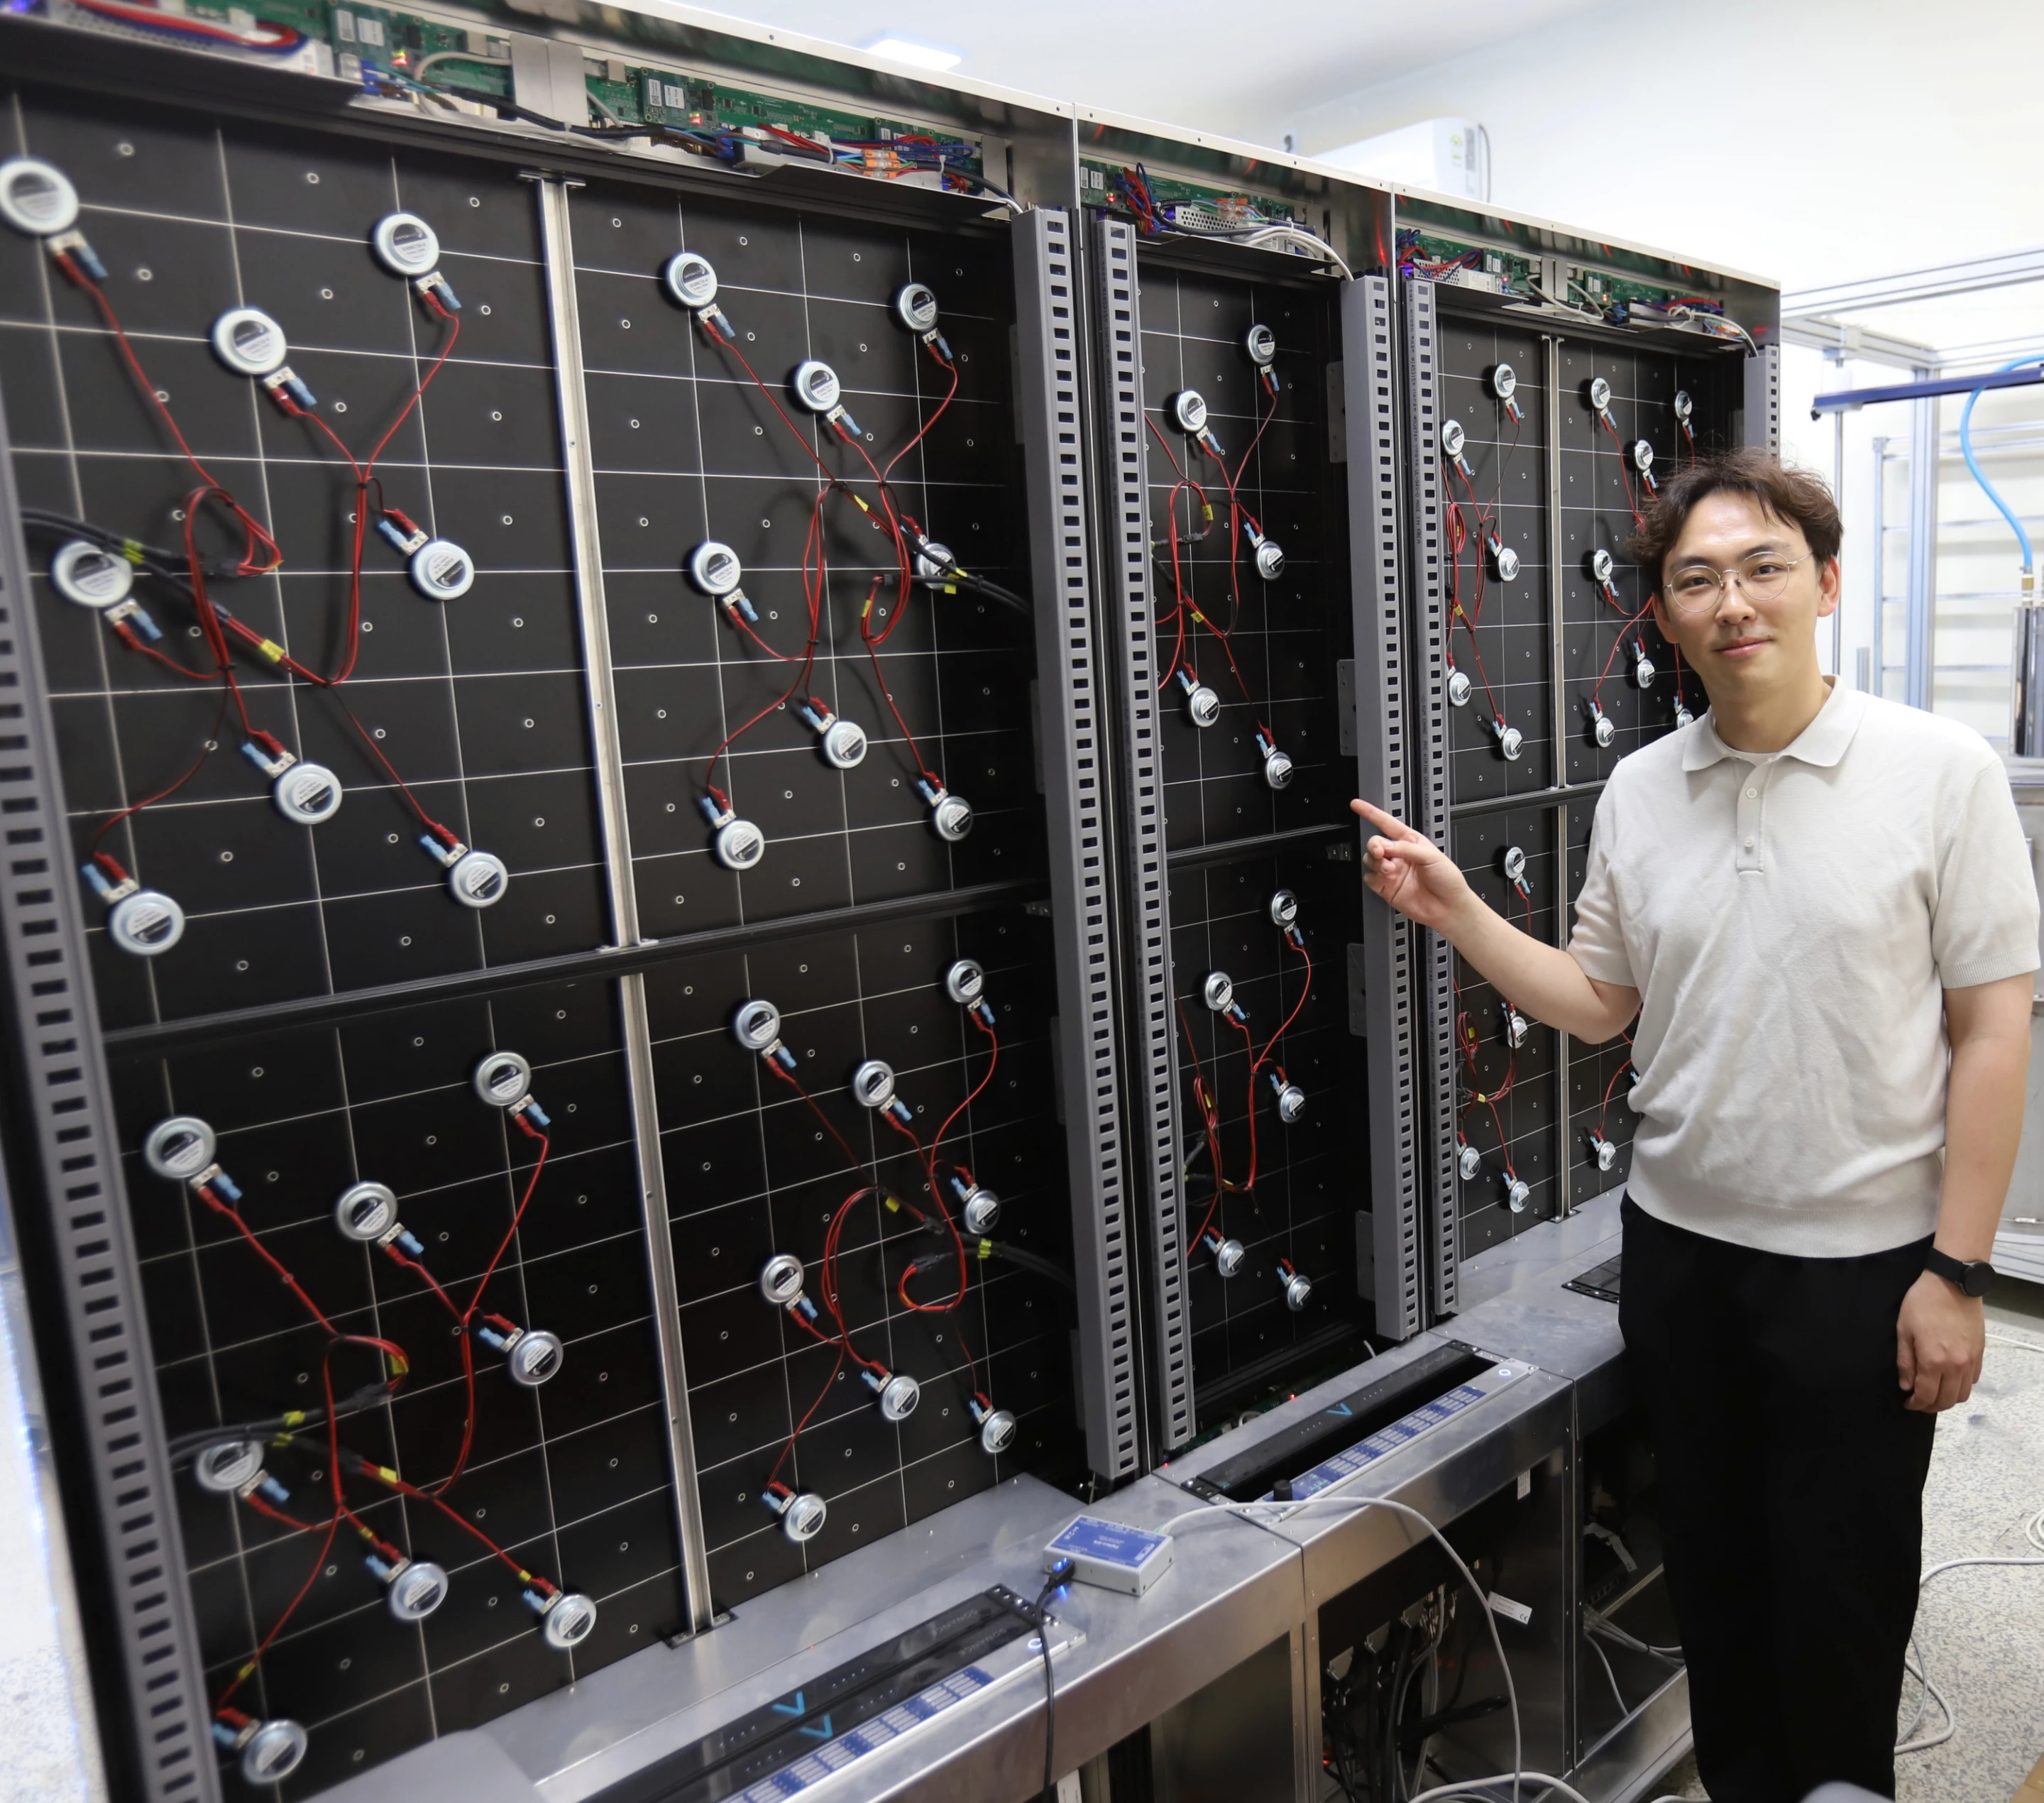
KIMM チームの新しいソリューションは、音の放射位置の動的な制御とスケーラブルな設計を実現します。研究者らが作成したプロトタイプのデバイスはサイズ約100インチで、透明なLEDフィルムとアルミニウムパネルで構成され、その後ろに80個のボイスコイルモーター(VCM)が取り付けられている。これらのモーターは電気信号を受信した後に前後に動き、パネルを振動させ、空気を押して音波を形成します。原理は従来のスピーカーの振動板と同様です。
しかし、画面の特定の領域を鳴らすのは簡単ではありません。振動はパネル全体に伝播し、他の振動を加えたり打ち消したりするため、音がどこから発生しているかを正確に制御することは困難です。この問題を解決するために、研究チームはまず振動に対するパネルの各領域の応答特性を分析し、次に「ムーア・ペンローズ擬似逆法」と呼ばれる数学的アルゴリズムを使用して各モーターに必要な駆動電圧を計算し、振動エネルギーを対象領域に正確に集中させることに成功した。
この方法では、単に最も近いモーターを起動するのではなく、複数のモーターを使用して連携して画面上に局所的な振動フィールドを形成します。ビデオ内の音源が動くと、振動フィールドも同期して動き、ダイナミックなトラッキング効果を実現します。
リアルタイムのサウンド定位も別の課題に直面しています。パネル内の振動波は互いに影響し合い、異なるモーターの異なる領域への伝達効率も異なります。システムが移動ターゲットの位置を常に再計算すると、制御プロセスが不安定になる可能性があります。
この点に関して、研究チームは、振動伝達効率の低いモーターを計算から除外するための一連の選択励起アルゴリズムを開発し、また、連続した音響信号を滑らかに接続して音の移動時のノイズや途切れを低減できる技術も設計しました。
自動化のレベルをさらに向上させるために、研究者らは人工知能に基づく音源分離および定位技術も導入しました。 AI はビデオ画面内の音声ターゲットを自動的に識別し、複雑な音声信号から対応する音声を抽出し、手動介入なしで画面上の対応する位置に正確に投影できます。
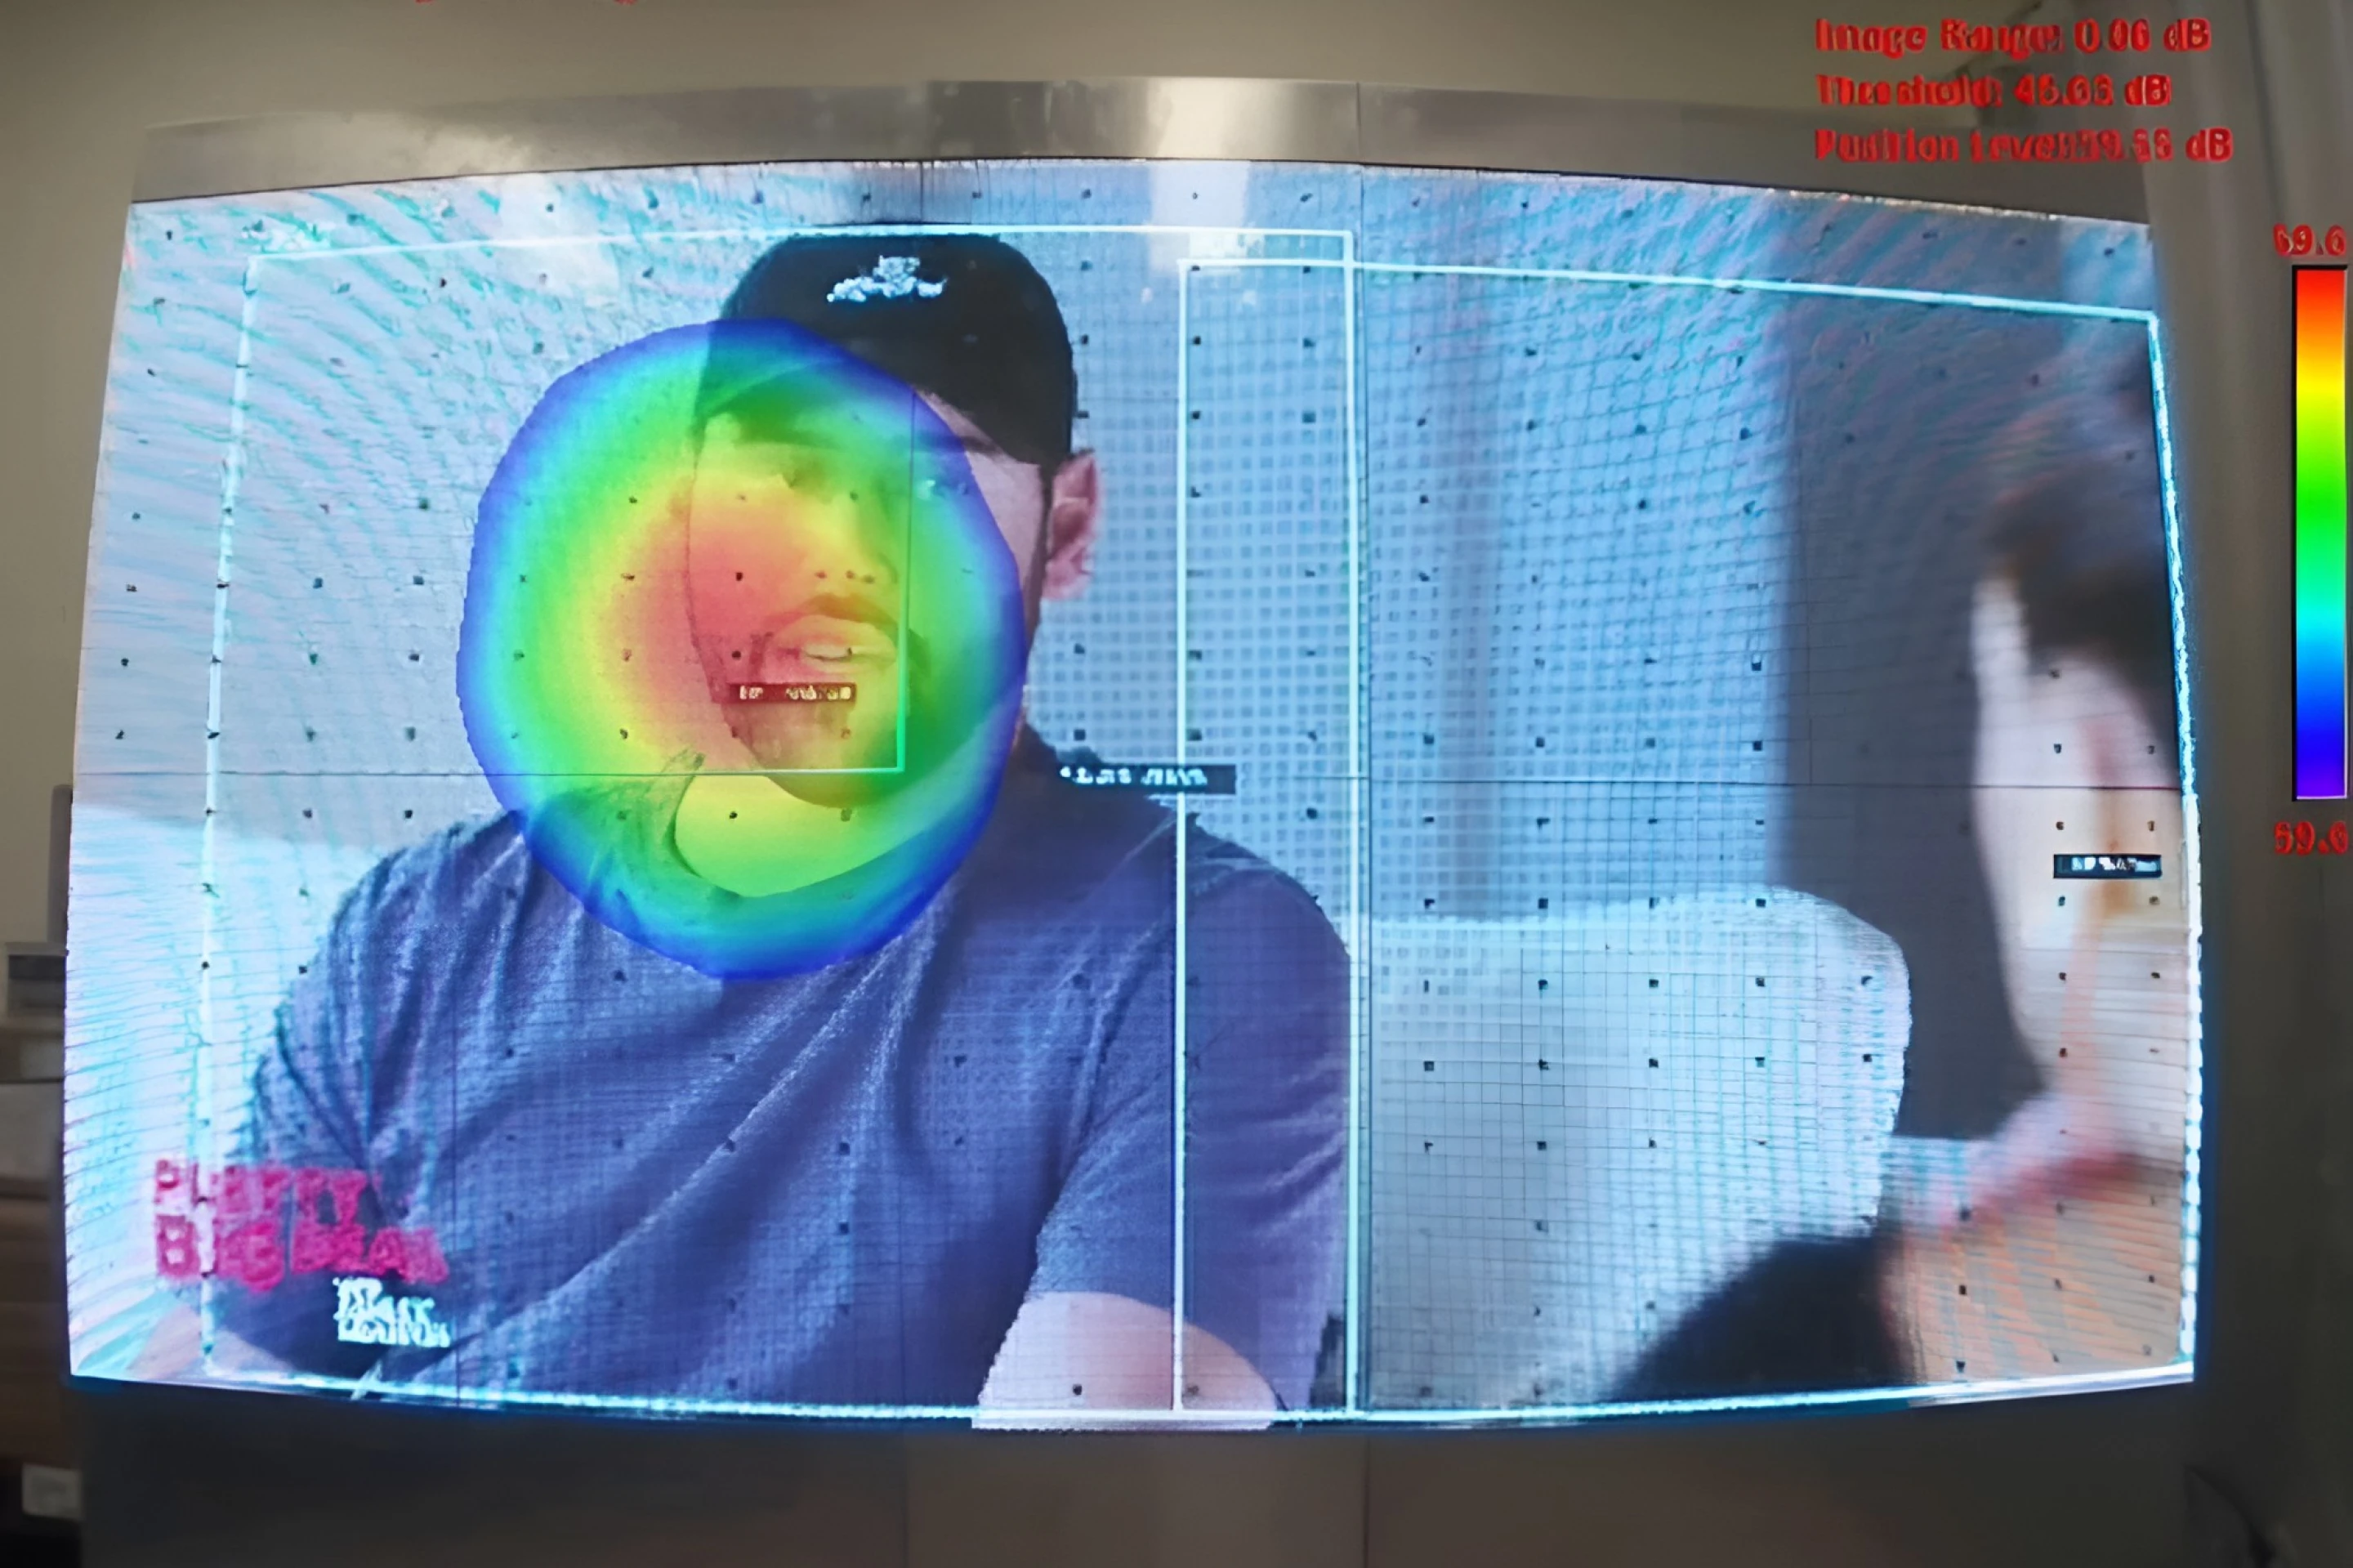
テストの結果、プロトタイプ システムのターゲット音領域の選択精度は 99.9% であることがわかりました。アクティブ領域と非アクティブ領域の振動振幅の差は最大 35 デシベルに達し、このシステムが指定領域に振動を高度に集中させ、他の領域の振動を効果的に抑制できることが証明されました。音響カメラを用いたテストでも、画面上で移動する対象物に対して音の出力位置を継続的に追従できることを確認しました。
関連する研究結果は、Journal of Mechanical Science and Technology に掲載されています。現在、この技術は、500 Hz 未満の低および中周波数範囲で優れた振動場位置決め機能を実証しています。
さまざまなサイズのディスプレイ デバイスに適応するために、研究チームはモジュール式グリッド設計を採用しました。複数のディスプレイ モジュールは必要に応じて自由に組み合わせたり分割したりできるため、理論的には家庭用テレビに使用できるほか、大型 LED ディスプレイ ウォールやデジタル サイネージなどの商用ディスプレイ シナリオにも拡張できます。研究者らはまた、複数のモジュールが同時に動作すると、システムは大型ウーファーと同様の低周波効果を生み出すことができると述べた。
研究チームは、サウンドと画像を同じ面上で統合することで、視聴者の没入体験を大幅に向上できると考えています。今後はテレビ分野に加え、メディアアート、舞台、展示ディスプレイ、車載用ディスプレイシステムなどへの活用も期待されます。
博士。研究プロジェクトのリーダーであるジン・ドンジュン氏は、チームはこの技術をモジュール式LEDスプライシングディスプレイシステムにさらに拡張し、幅広いディスプレイデバイスに適した新世代のコア技術への開発を推進する計画であると述べた。
ただし、研究者らは、このシステムは大型の低音ユニットの効果の一部をシミュレートできるものの、全体的な音質、音圧性能、およびフルバンドのカバレッジ能力の点で、プロの独立したサウンド システムを完全に置き換えることは依然として難しいことも認めました。それでも、このテクノロジーは、「ある場所では映像が、別の場所では音が聞こえる」という長年の空間的ずれの問題を解決することに成功し、画面上のすべての見た目と音をよりリアルかつ自然にします。
コメント