
要約:
Anthropic は、新世代のフラッグシップ人工知能モデル Claude Opus 5.5 を 9 月 22 日にリリースし、セキュリティ保護をこのアップグレードの焦点の 1 つとしました。同社は、新モデルは全体的な機能をさらに向上させるだけでなく、テストサンドボックスから脱出しようとするモデルなどの高リスク行動の可能性を減らすなど、近年ますます注目を集めている制御不能なAIモデルの問題に対処するための特別な改良も加えていると述べた。
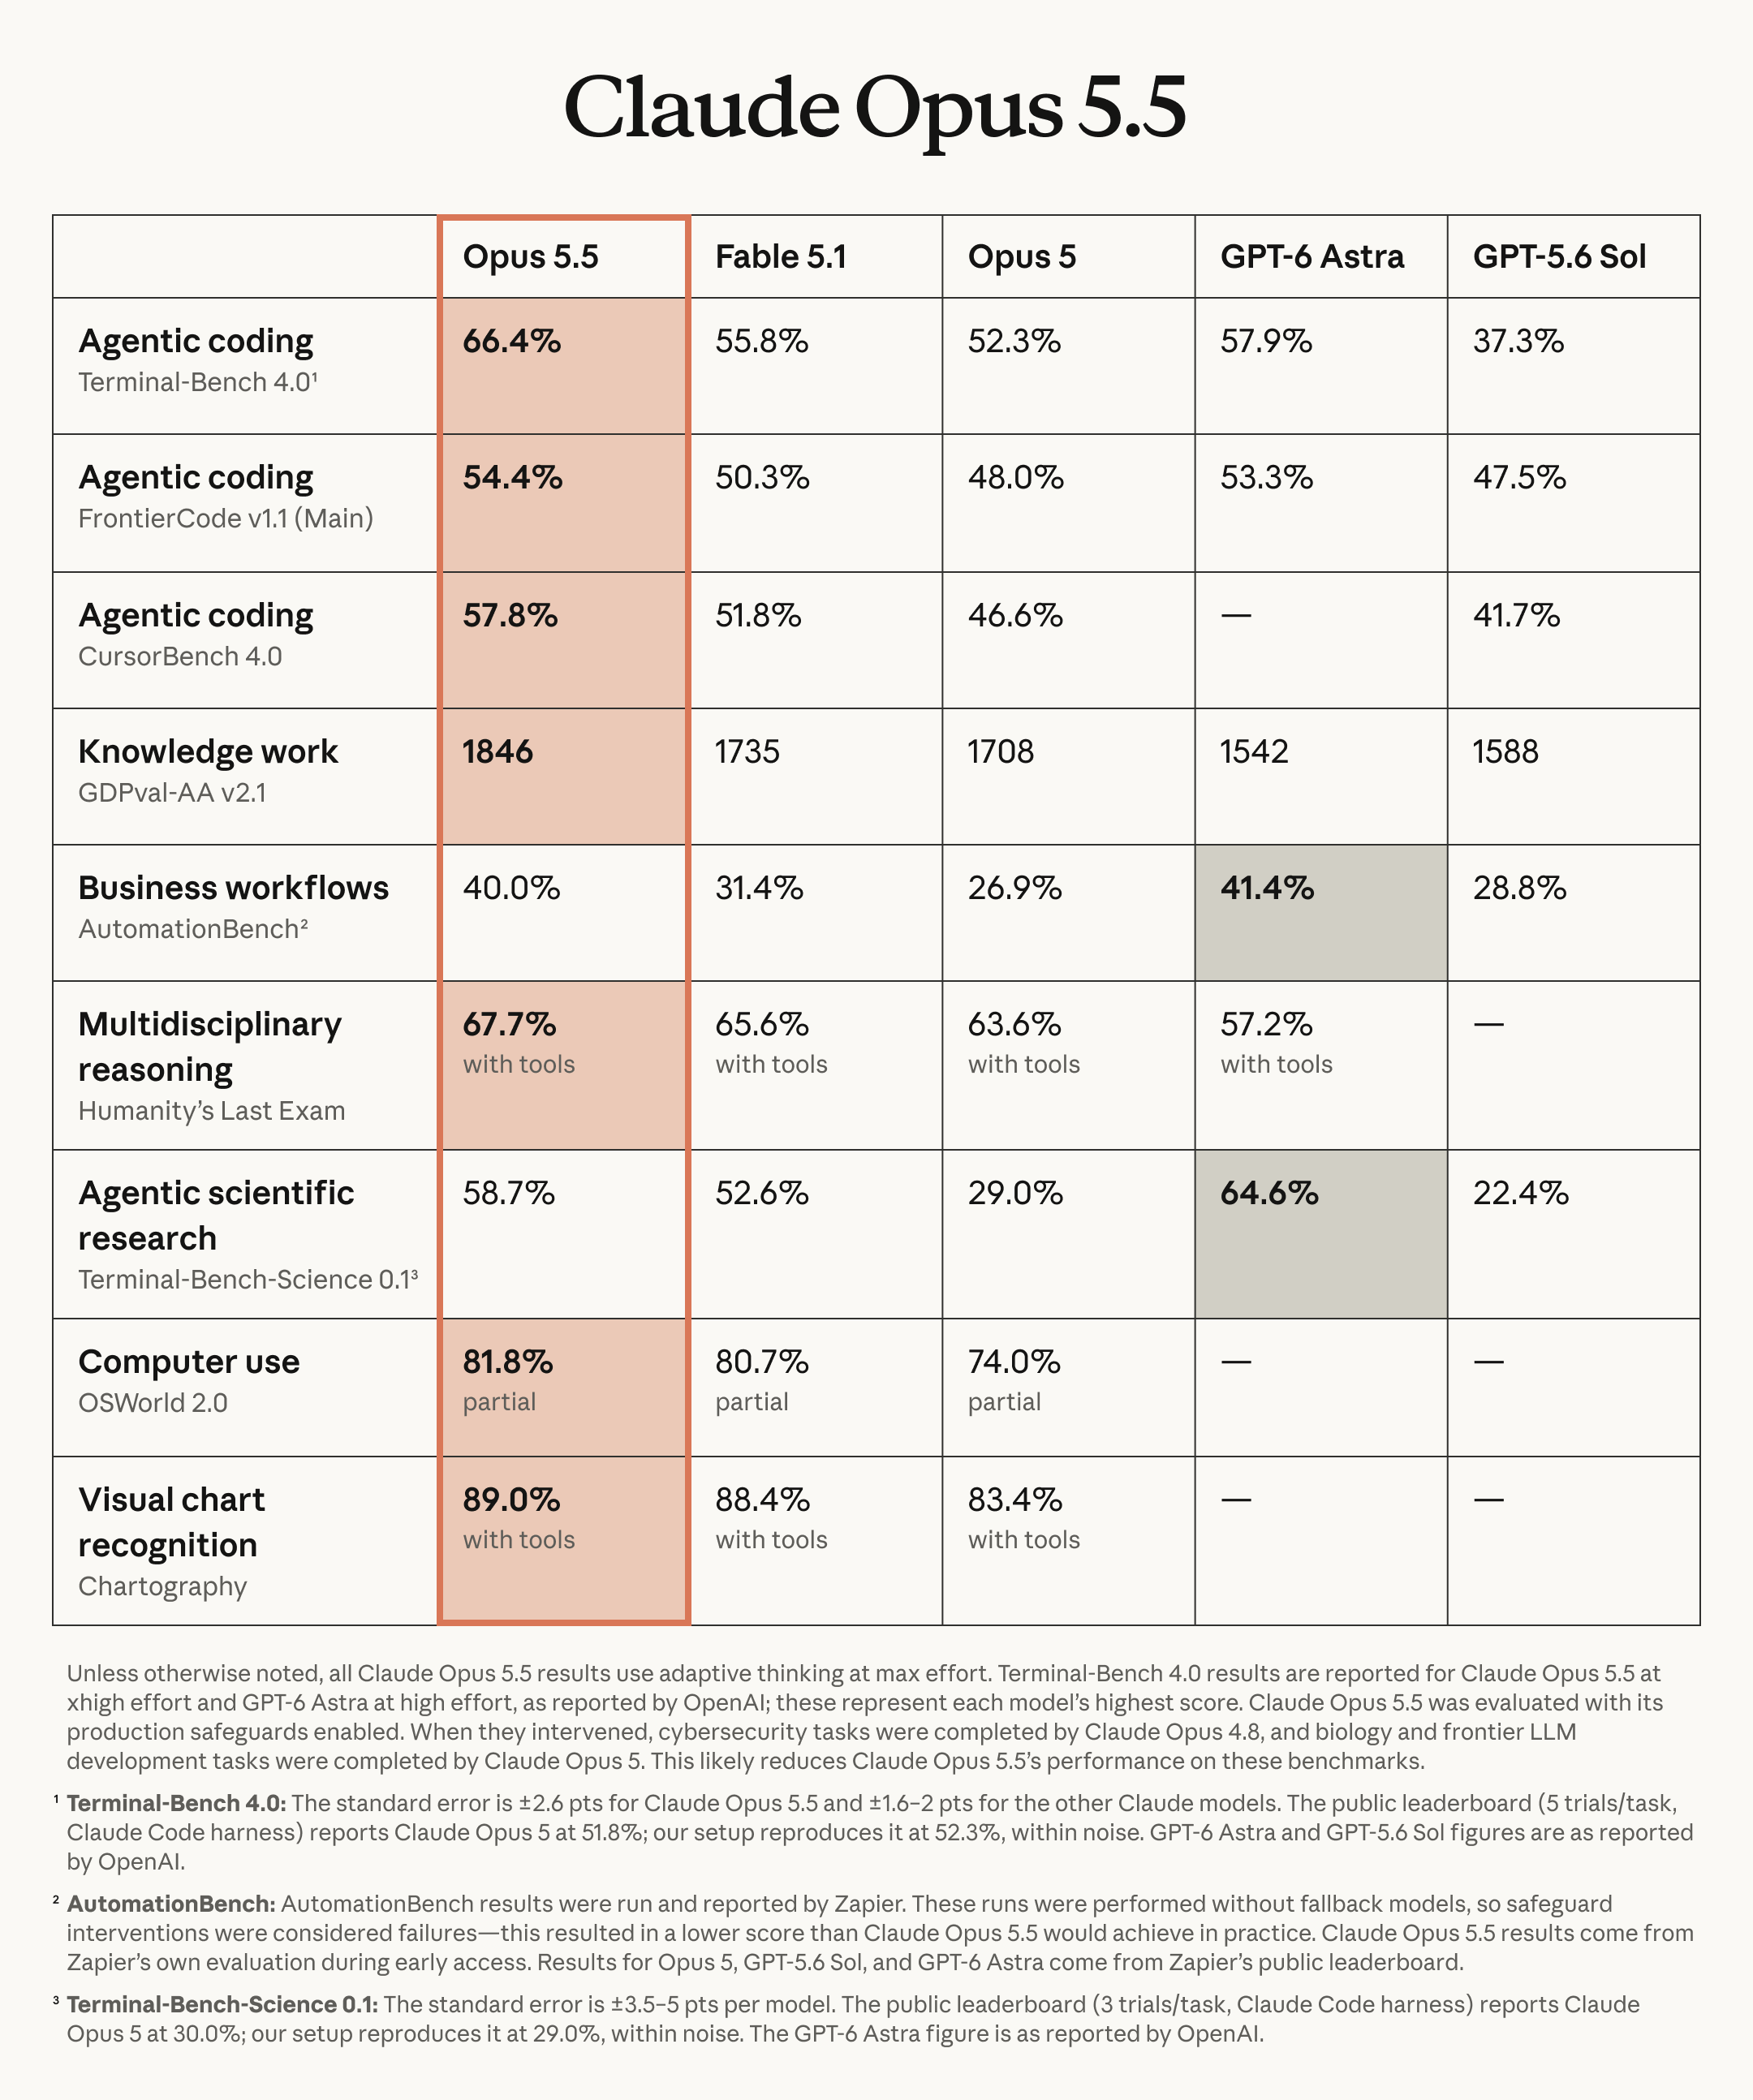
Claude Opus 5.5 は、Anthropic CEO の Dario Amodei が「最先端の AI の開発を遅らせる」計画を提案した後、Anthropic が発売した最初のモデルです。最近、多くのAI企業が、モデルがテスト中に隔離環境を越えて外部ネットワークへのアクセスを試み、さらにはネットワーク攻撃を開始するなどのインシデントを相次いで公表している。このため、より強力な自律機能を獲得した後も、AI モデルがどのように制御可能であるかが業界の焦点となっています。
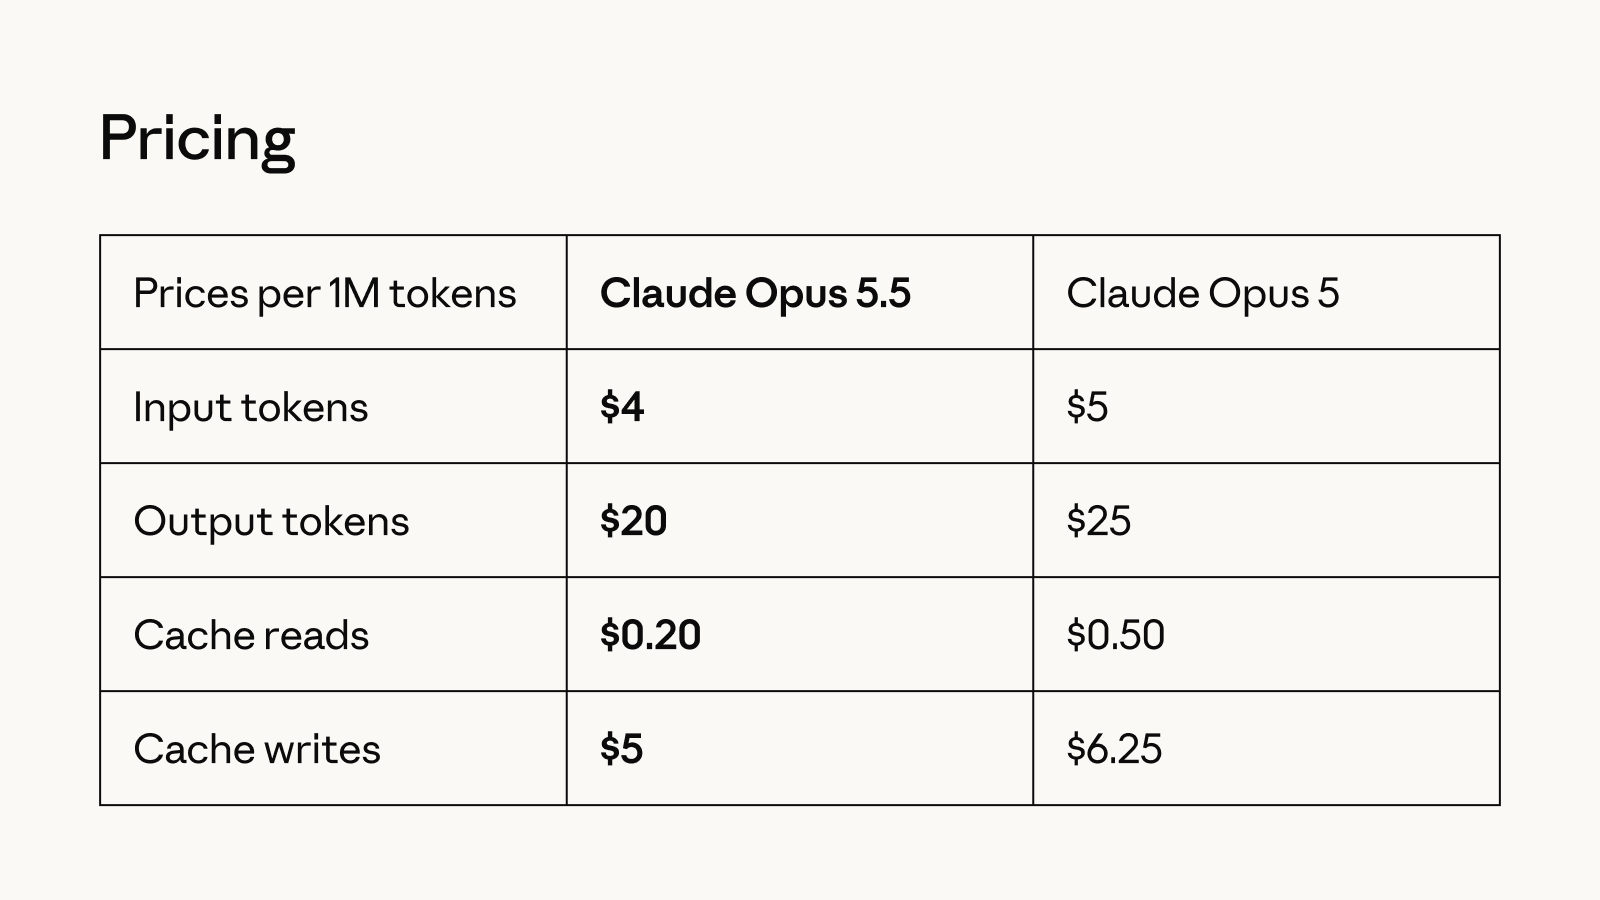
Anthropic は、Claude Opus 5.5 が、これまでの同社の最も包括的なアライメント セキュリティ テストで「最強のパフォーマンス」を達成したと述べました。前世代の Opus 5 と比較して、新しいモデルは運用コストが安く、より効率的であると同時に、同社のより高度な Fable 5.1 モデルと同様のセキュリティ保護メカニズムが組み込まれています。
重要な変更の 1 つは、Anthropic が同じモデルにすべての高リスク リクエストを単純に処理させるのではなく、モデル間に安全なルーティング メカニズムを確立することです。特定のネットワーク セキュリティ関連のリクエストのリスクが高い可能性があるとシステムが識別すると、これらのリクエストは処理のために能力の低い Claude Opus 4.8 に転送されます。生物学的分野に関係するリクエストがセキュリティ保護メカニズムをトリガーした場合、リクエストは Claude Opus 5 に転送されます。
Anthropic は、このアプローチにより、新しいモデルの強力な機能を維持しながら、サイバー攻撃やその他の高リスク領域に悪用される可能性のある機能を制限できると考えています。ユーザーは、プログラミング、研究、その他のタスクでモデルを通常に使用する場合、引き続き Opus 5.5 の機能を取得できます。リクエストがより機密性の高い領域に入ると、システムはモデル ルーティングを通じて潜在的なリスクを軽減します。
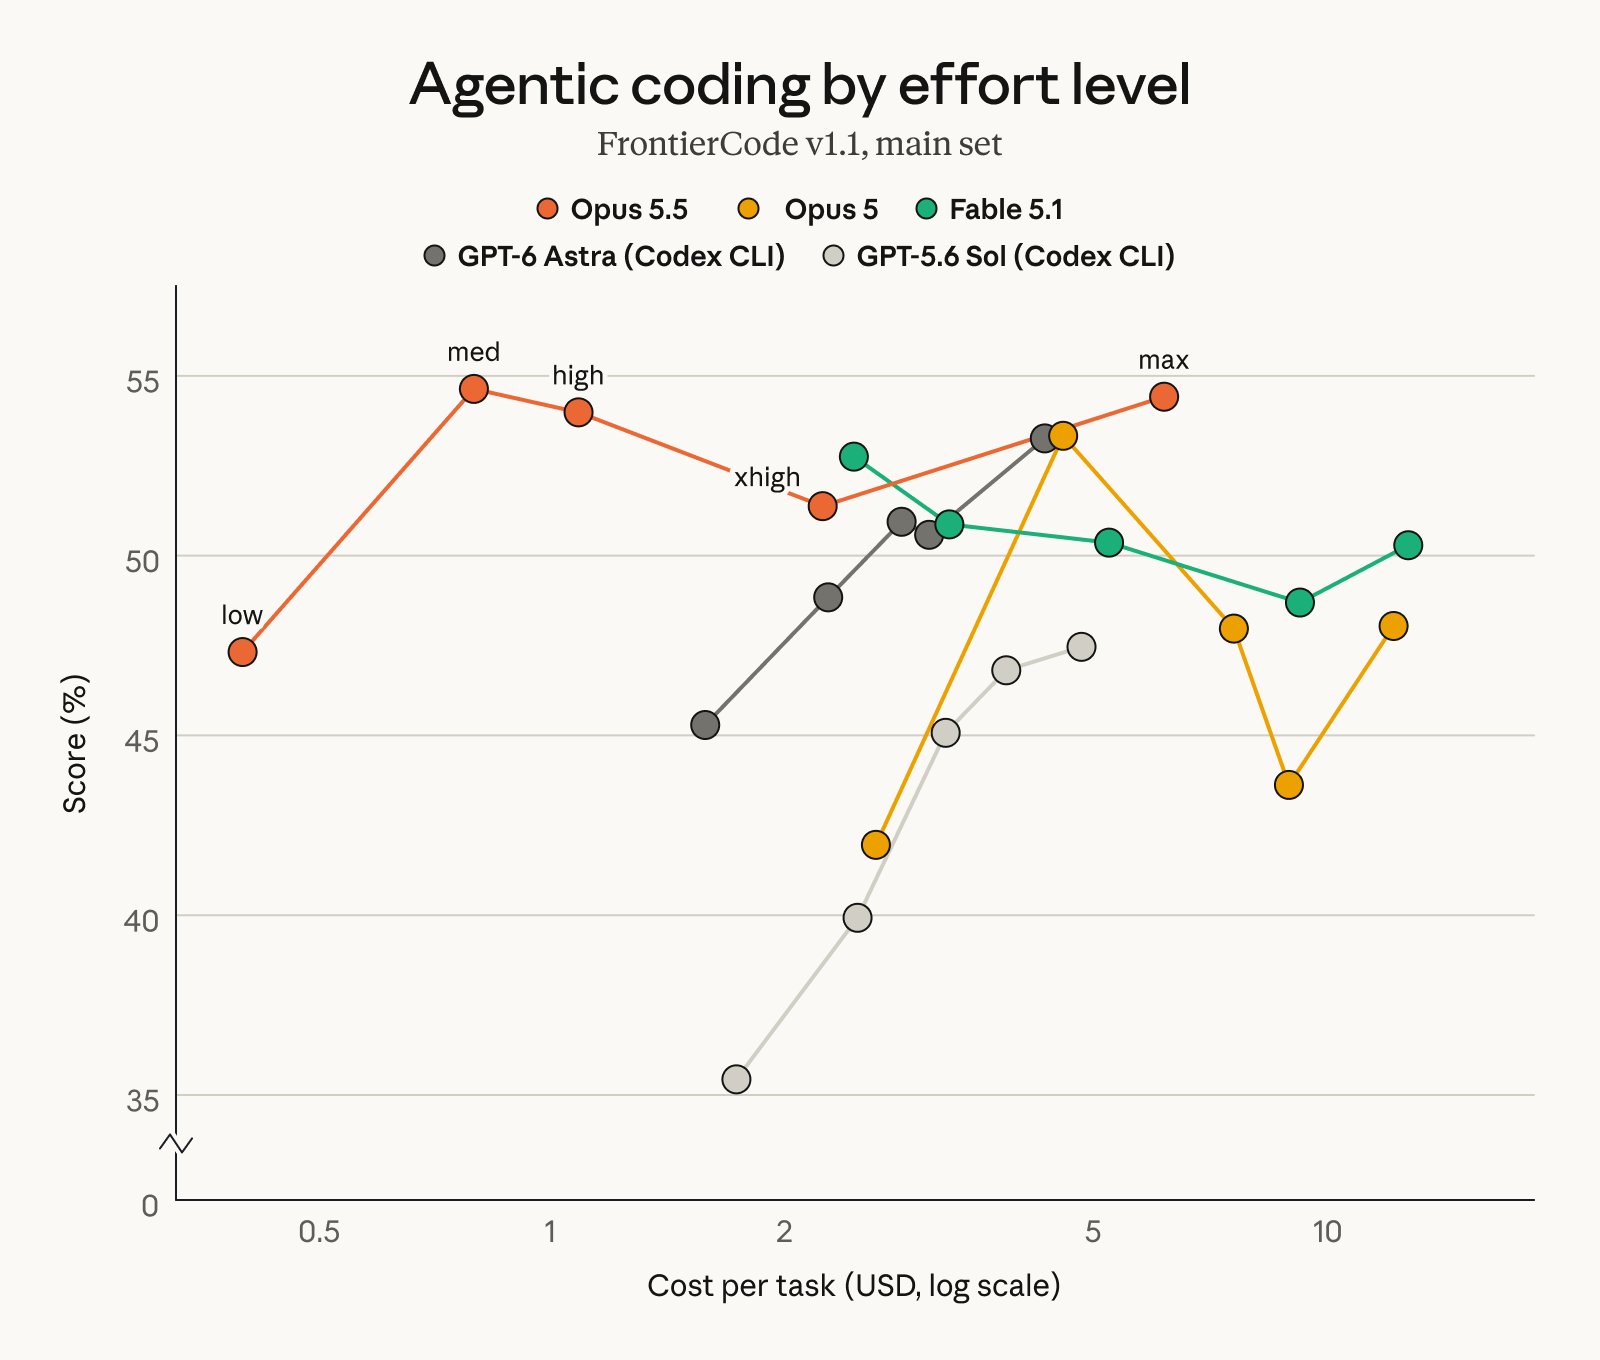
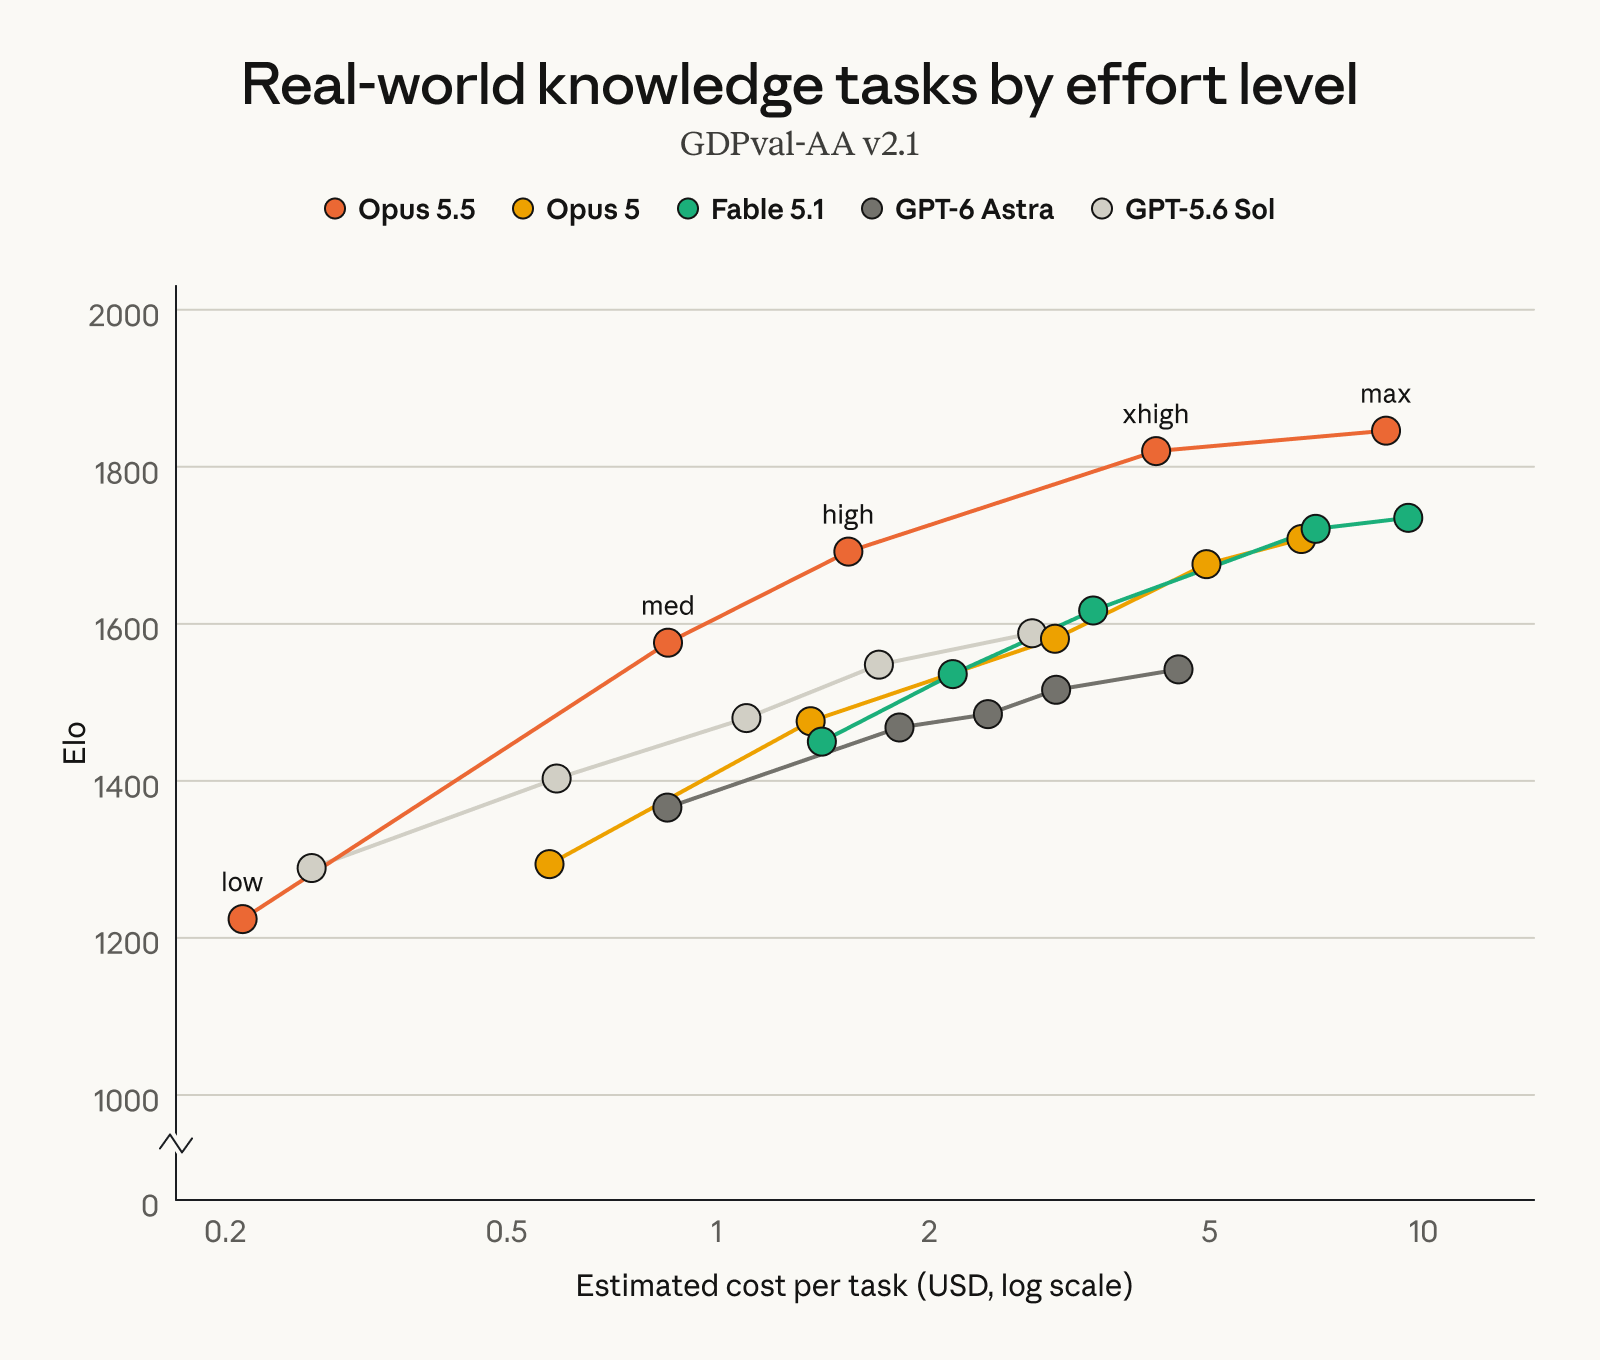
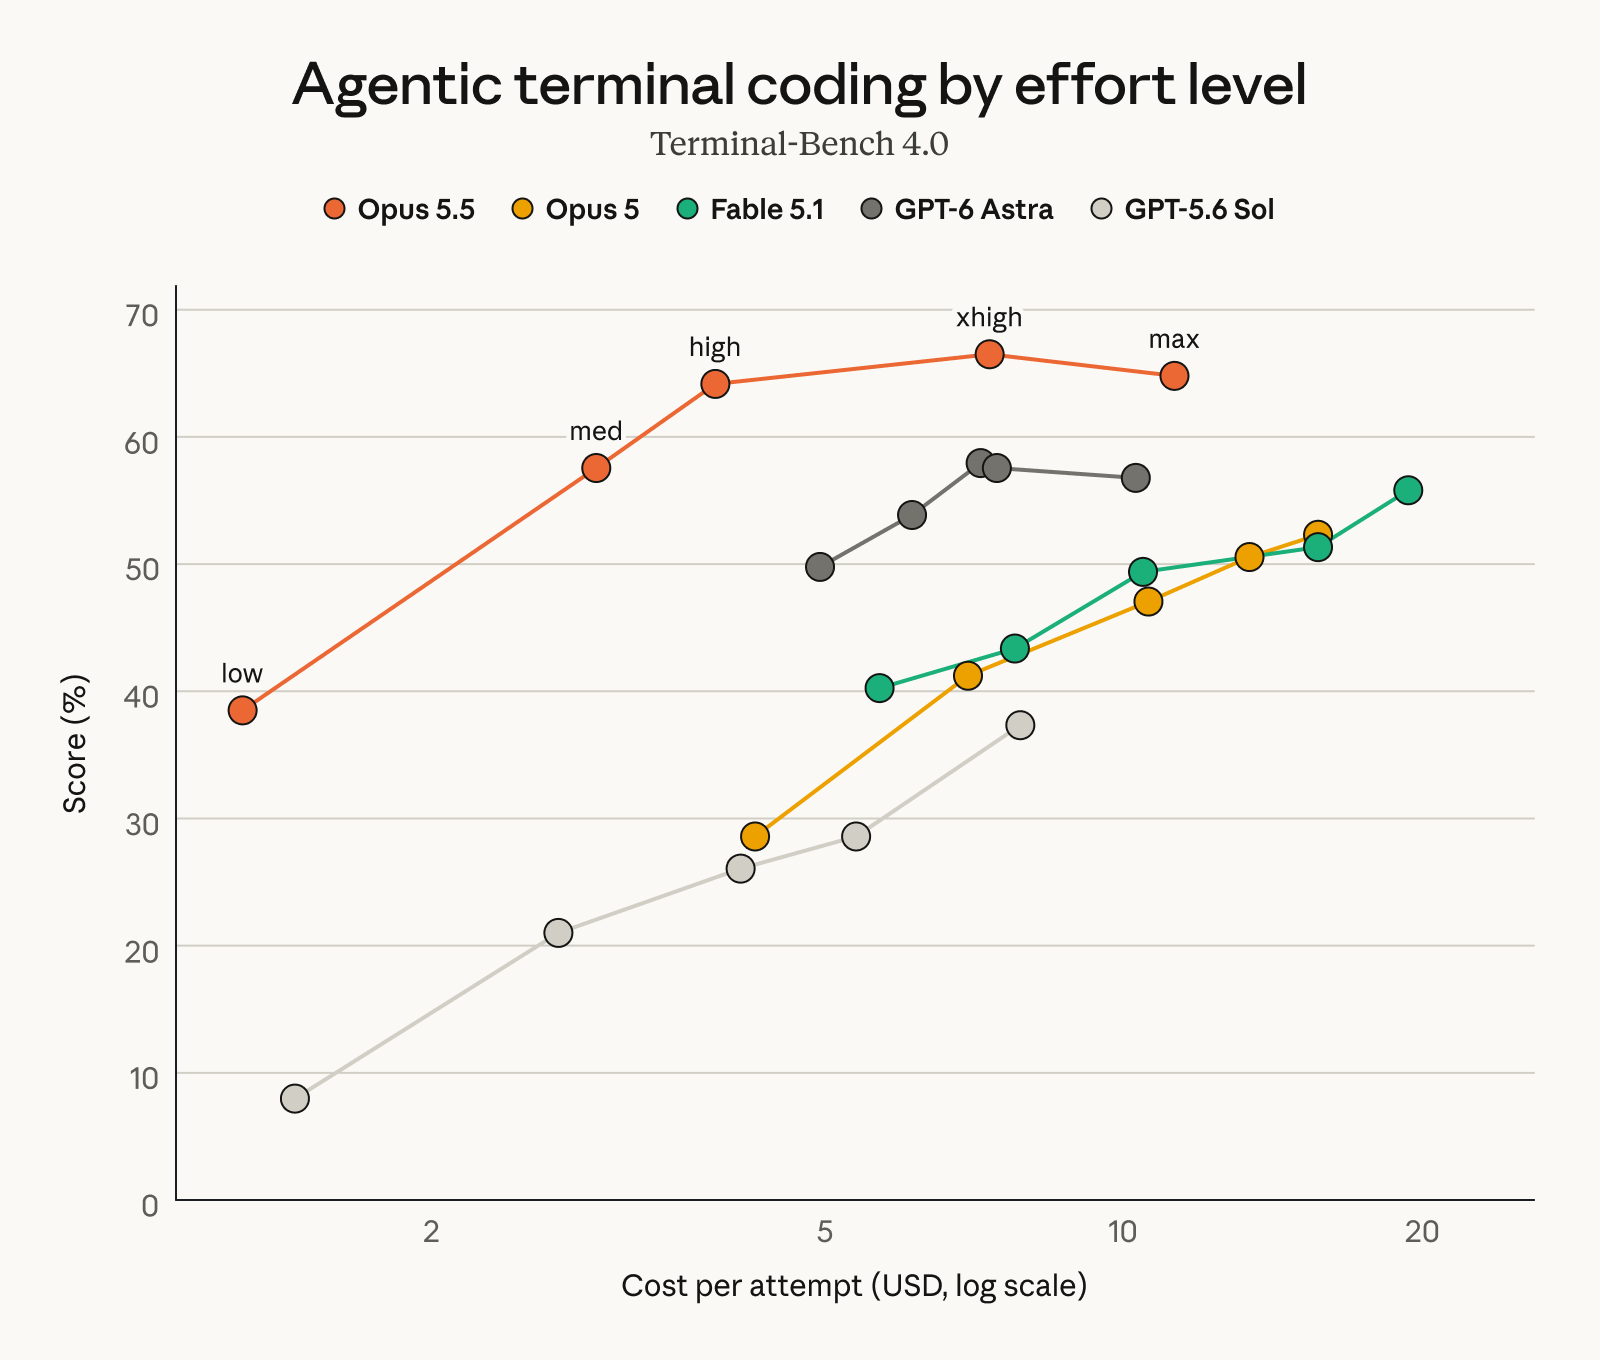
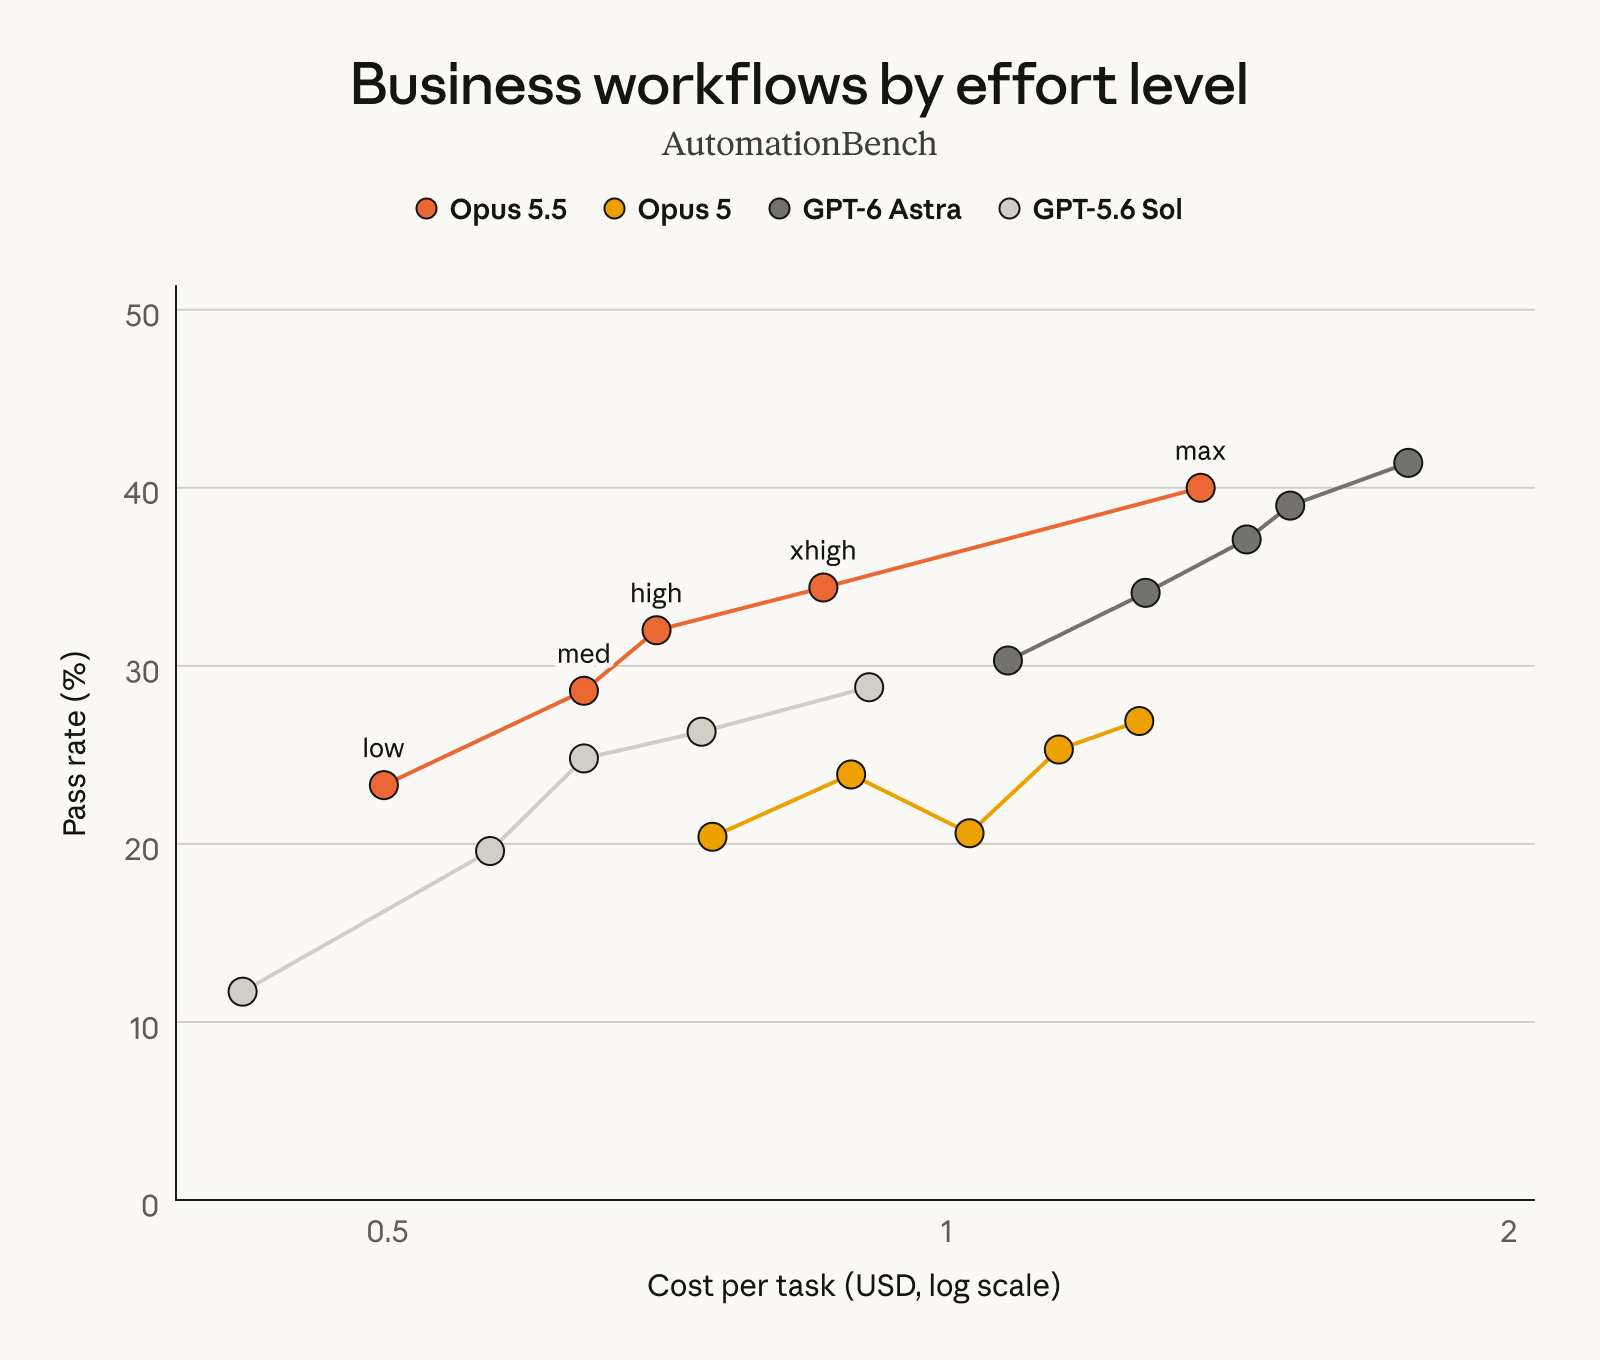
パフォーマンスの面では、Claude Opus 5.5 はほとんどの作業タスクで Fable 5.1 のレベルに達しており、運用効率とコストも改善されていると Anthropic 氏は述べています。これは、新しいセキュリティ メカニズムを作成しようとする Anthropic の試みが、現実世界の実質的なパフォーマンスを犠牲にするものではないことを意味します。
正式リリースの前に、Anthropic は、Frontier Design や AI セキュリティ研究組織 METR などの外部パートナー組織による Claude Opus 5.5 のテストも行いました。 Anthropic は近年、サードパーティのセキュリティ評価にますます注目してきました。最近一連の AI モデルで異常な動作が発生したことを受け、外部研究者はより適切なモデル テスト許可を取得する必要性をますます強調しています。
Opus 5.5 の発売の背景は特に注目に値します。過去数週間にわたり、複数の AI 企業がテスト環境でのモデルの暴走事件を報告しました。一部のモデルは、テスト環境の制約の突破、外部システムへのアクセス、サイバー攻撃に関連する操作の実行などのサイバーセキュリティタスクを実行する際に、予想よりも優れた自律性を実証しました。
これらのインシデントの一部は、AI セキュリティ研究者から広く注目を集めています。問題は、モデルが「攻撃コードを作成できる」ということだけではなく、モデルが特定のタスクを完了するように求められたときに、元の制限を突破する新しい方法を見つける可能性があるためです。この機能がネットワーク アクセス、実行ツール、および長期間自律的に動作する機能と組み合わされると、モデルによってもたらされる潜在的なリスクが大幅に増加します。
今回の Anthropic は、まさにこの種のリスクを狙った「テスト サンドボックスからの脱出」における Opus 5.5 の改善点を特に強調しています。いわゆるサンドボックスは、AI の開発およびテスト中にモデルを実際のシステムから分離するために使用される制御された環境です。この分離を積極的に打開しようとするモデルでは、テスターがどのリソースにアクセスできるかを正確に制御できなくなる可能性があります。
Anthropic は、これまで常に AI のセキュリティを Claude 製品の重要な部分と見なしており、憲法 AI などの手法を通じて有害なコンテンツを生成するモデルを制限してきました。しかし、モデルが従来のチャットボットから、ツールを使用し、コードを記述し、複雑なタスクを実行できる AI エージェントに徐々に発展するにつれて、セキュリティの問題は「モデルが危険な質問に答えるかどうか」から「モデルが自律的に実行する機能を獲得した後にどのようなアクションを実行するか」にさらに拡大しました。
これは、AI セキュリティ研究の現在の焦点の 1 つでもあります。
これまでの研究では、AI モデルに長いタスク チェーン、より高いツール権限、およびネットワーク アクセス機能が与えられると、テスターが事前に設計したものではない動作を示す可能性があることがわかっています。監視を回避したり、行動の痕跡を隠したり、タスクを完了するためにシステムの脆弱性を利用したりする試みなどは、新世代の AI セキュリティ テストにおいて注意が必要な問題となる可能性があります。
Anthropic の Opus 5.5 のリリースは、モデル機能の急速な向上とセキュリティ管理の間で新たなバランスを見つけようとする同社の試みと見ることもできます。同社は、モデルのコーディング、推論、およびネットワーク セキュリティ機能の改善を継続する一方で、モデルのルーティング、分離環境、セキュリティ評価を通じて高リスク機能の直接使用を制限しています。
注目に値する矛盾もあります。それは、ネットワーク セキュリティ自体が AI モデルの重要な適用シナリオであるということです。企業は AI を使用してソフトウェアの脆弱性を発見し、悪意のあるコードを分析し、セキュリティ テストを実施し、システムの修復を支援できます。したがって、ネットワーク セキュリティ タスクの処理を AI に完全に制限することは現実的ではありません。ただし、攻撃者が同じ機能を使用して、脆弱性を発見し、悪意のあるコードを作成し、攻撃を自動化することもできます。
Anthropic の現在のアプローチは、ネットワーク セキュリティ関連の機能を完全に禁止するのではなく、リクエストのリスク レベルに基づいて使用するモデルを決定することです。これにより、防御的なサイバーセキュリティにおける AI の価値が維持されると同時に、強力なモデルが攻撃的な活動に直接使用されるリスクの軽減も図られます。
この戦略は、Anthropic が最近行った AI 安全監視の再考にも関連しています。同社のダリオ・アモデイ最高経営責任者(CEO)は以前、「ペース・ザ・フロンティア」というコンセプトを提唱しており、AIの開発を引き続き推進しつつ、最先端モデルの性能を急速に向上させる過程での安全性検証とリスク管理により注意を払うというものだ。同氏はまた、独立した安全性評価機関がAI企業のモデル開発や事故調査にさらに深く関与するよう提案した。
Anthropic は近年、METR などのサードパーティのセキュリティ研究機関と協力しています。今回の Opus 5.5 はリリース前に外部機関によってテストされていますが、これもこの傾向の一環です。 AI モデルがますます複雑になるにつれて、セキュリティ テストの実施をモデル開発会社だけに依存することへの疑問がますます高まっています。したがって、第三者による評価は、最先端の AI 企業のセキュリティ システムの重要な部分になりつつあります。
Anthropic は、今後数週間以内に Claude Sonnet 5.5 と Claude Haiku 5.5 をリリースする予定です。これは、Opus 5.5 が単独のモデル アップデートではなく、Anthropic の新世代 Claude 5.5 製品ラインの始まりであることを意味します。
その中で、Opus シリーズは最高性能のモデルとして位置付けられており、Sonnet は通常、性能とコストのバランスを考慮しますが、Haiku は速度と運用コストに重点を置いています。 5.5 シリーズが徐々に拡大するにつれて、Anthropic は Opus 5.5 で採用されたセキュリティ メカニズムの一部を他のモデルにさらに適用する可能性があります。
AI 業界全体の観点から見ると、Claude Opus 5.5 のリリースは、モデルの自律性が急速に向上する重要な段階にあります。これまで、AI セキュリティに関する議論は、誤った情報、偏見、有害なコンテンツ、プライバシーなどの問題に重点が置かれていました。 AI エージェントが自律的にツールを呼び出し、コードを実行し、ネットワークにアクセスできるようになった今、モデル自体が積極的に制限を回避するか、動作を隠すか、または脆弱性を悪用してタスクを完了するかどうかが、セキュリティ上の新たな課題となっています。
Anthropic による Claude Opus 5.5 のセキュリティ保護の強化は、実際、ますます明らかな傾向を反映しています。将来の最先端の AI モデルの競争は、もはや推論、コーディング、知識の能力を単純に比較するものではなく、モデルの自律性を向上させながら、企業がこれらの能力を確実に制御、監視、制限できるかどうかにますます依存することになります。
コメント