
要約:
Google DeepMind エンジニアは最近、創造的な実験をデモンストレーションし、Google の Gemma 3 270M 小型言語モデルを通常のオフィス レーザー プリンタで直接実行することに成功しました。このモデルのパラメータ数は約 2 億 7,000 万個で、実験に使用したプリンタの空きメモリは 14.1MB しかありませんが、それでも 1 秒あたり 60 ワード以上の生成速度を達成しています。
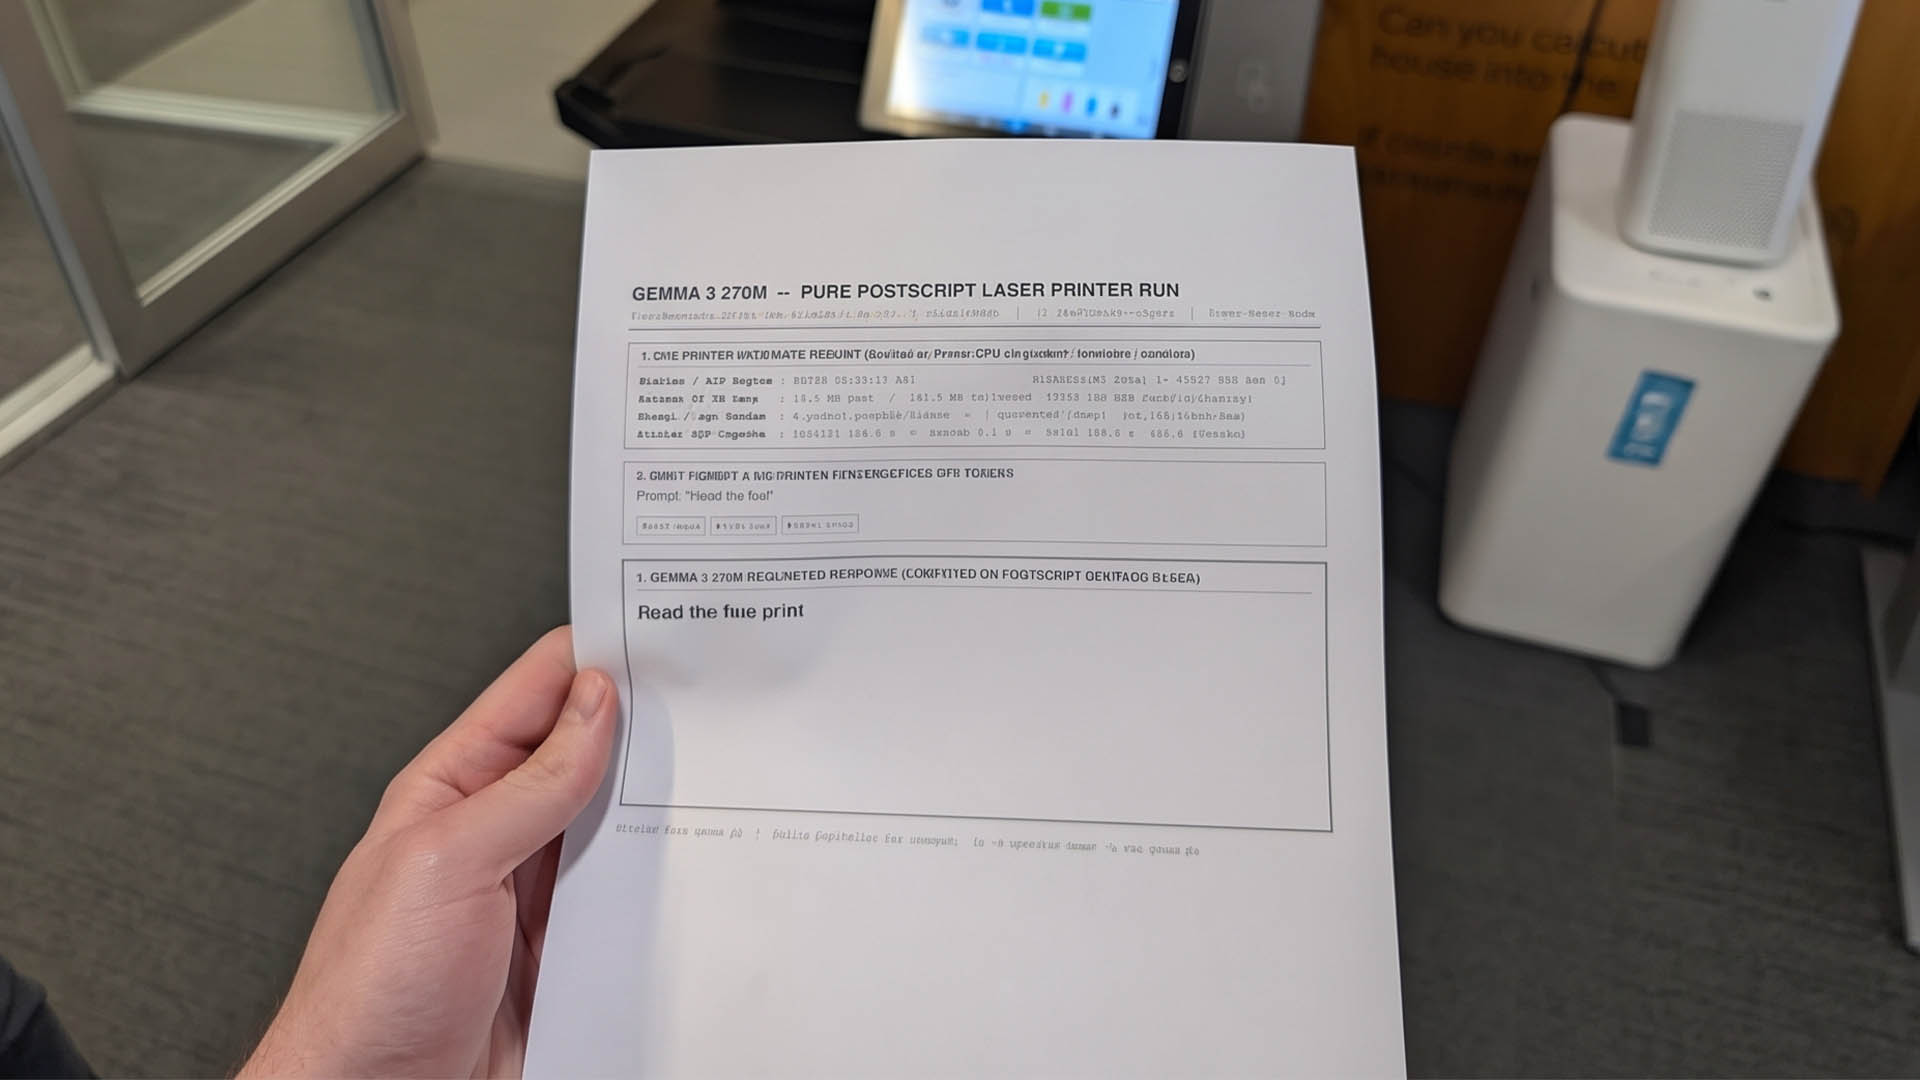
この結果は、エンジニアの Omar Sanseviero によってソーシャル プラットフォーム X で発表されました。彼は、Carbon プロジェクトの助けを借りて、Gemma モデルをオフィスのプリンターで直接実行したと述べました。実験全体では、プリンターのファームウェアは変更されず、外部のコンピューティング ボードやその他のハードウェアも使用されませんでした。代わりに、最新のレーザー プリンタに組み込まれている PostScript ページ記述言語に完全に依存していました。
PostScript は、プリンタがテキスト、グラフィックス、およびページ レイアウトを表示する方法を制御するために一般的に使用される、チューリング完全なページ記述言語です。実験チームは、軽量の Transformer 推論エンジンである Carbon を使用し、量子化された Gemma 3 270M モデルと組み合わせて、最終的にオリジナルの PostScript 印刷ファイルを生成しました。プリンタがファイルを実行すると、実際には PostScript インタプリタ内で言語モデルの推論計算が完了します。
モデル推論中にプリンターのメモリが不足するのを避けるために、実験では動的層流負荷テクノロジーを採用しました。システムはモデルのさまざまなレイヤーを常にメモリにロードしたりメモリからロードしたりして、ピーク時のメモリ使用量をわずか 14.1 MB に保ちます。一方、プリンタは 244.6 MB の PostScript 仮想メモリを割り当てます。それでも、Gemma 3 270M は、プリンターの CPU 上で 61.3 トークン/秒の生成速度を達成しました。
実験で取得したハードウェア情報によると、このリコー プリンタは、PostScript レベル 3 インタープリタ内で 18 層の Transformer 計算をネイティブに実行します。 4 つのトークンのみを含むプロンプト「Read the Fine」が入力された場合、事前充填段階には 184 秒かかりますが、1 つのトークンを生成するためのデコード時間はわずか 0.1 秒で、処理プロセス全体の合計は 184 秒になります。
計算が完了すると、プリンターは最終的に「細かい文字を読んでください」という 3 単語の答えを紙に直接印刷します。この結果は、モデルが実際にプリンタ内部で推論を完了していることを証明するだけでなく、ソフトウェア レベルでの日常的なオフィス機器の可能性が人々の期待をはるかに超えていることも示しています。この操作モードは実際の運用環境には適していませんが、小規模な定量モデル、推論エンジン、および既存のハードウェア機能を組み合わせた場合に可能なことの限界を示しています。
コメント