
要約:
Google は、Gemini 4 シリーズの新しいメンバーである Gemini 4 Neon を正式に発売します。このモデルは、複雑なプログラミング、分析的推論、および複数ステップのタスクの実行向けに位置付けられており、高レベルのインテリジェンスと運用効率のバランスをとろうとしています。 Googleによると、初期のテストではNeonの全体的な品質は主力モデルのGemini 4 Carbonと同等かそれを上回っているが、タスクの実行速度は3倍速く、同じタスクのコストはCarbonの60%のみだという。
以前、Google は日常業務向けに Gemini 4 Carbon と Gemini 4 Hydrogen を発売しました。炭素は主に複雑で長期にわたる困難な作業を目的としていますが、水素は素早い反応と日常的な使用を重視しています。今回発売された Neon は、強力な推論能力が必要だが実行速度とコストに敏感な作業シナリオに対応することに重点を置き、両者のポジショニングのギャップを埋めます。
Gemini 4 Neon は、人工分析インテリジェンス インデックスの評価で 61 ポイントを獲得し、最高レベルの xhigh 思考モードをオンにした場合に 3 位にランクされ、一部の大型で低速なモデルに次いで 2 位になりました。 Vals Index のレビューでは、70.9% のスコアで 2 位にランクされました。さらにGoogleは、Neonは複数ステップの命令実行、複雑な制約処理、ユーザーが途中でタスク要件を変更した場合の適応性において優れたパフォーマンスを発揮すると述べた。
ソフトウェア開発の分野では、Neon は長期にわたるインテリジェント エージェント ワークフローに特に重点を置いています。複数のファイルにわたるコードのデバッグ、リファクタリング、およびプロジェクトの変更を処理し、タスクの進行状況を継続的に報告しながら、実行中の繰り返しのファイル読み取りを削減します。 Google は、これらの改善により、このモデルがコードを生成するだけでなく、実際のソフトウェア開発に近い環境で複雑な作業を独立して完了できるようになることを期待しています。
Google が発表したテスト結果では、人工分析コーディング エージェント インデックスで Neon が 58.6 ポイント、terminal-bench 4.1 が 65.2%、FrontierCode 2.0 が 46.2% を獲得しました。 SWE スイープ テストでは、ミニ SWE テスト フレームワークを使用した場合のスコアは 12.8% でしたが、GoogleAntigravity 環境では 39.0% に増加しました。この一連の違いは、インテリジェント エージェントが使用するソフトウェア フレームワークと実行環境が最終結果に大きな影響を与える可能性があることも示しています。
Neon は、Antigravity のコーディネーターとしても機能し、複雑なタスクを分割し、複数の Gemini 4 Hydrogen サブエージェントに引き渡して並列実行することができます。このようにして、モデルはさまざまなコード モジュールまたは作業ステップを同時に処理し、各サブエージェントの結果を統合できます。複数のファイルと複数の機能モジュールを含む開発タスクの場合、この協調的なアプローチにより全体の実行時間が短縮されることが期待されます。
エンタープライズ ナレッジ ワークの観点から、Neon はテキスト、画像、オーディオ、ビデオなどのマルチモーダル入力をサポートし、統合されたコンテキスト ウィンドウは最大 100 万のトークンをサポートできます。ユーザーはスプレッドシート、PDF、チャート、オーディオ、ビデオ、その他のマテリアルを同じタスクに組み込むことができ、モデルが包括的に分析して構造化された結果を生成できるようになります。
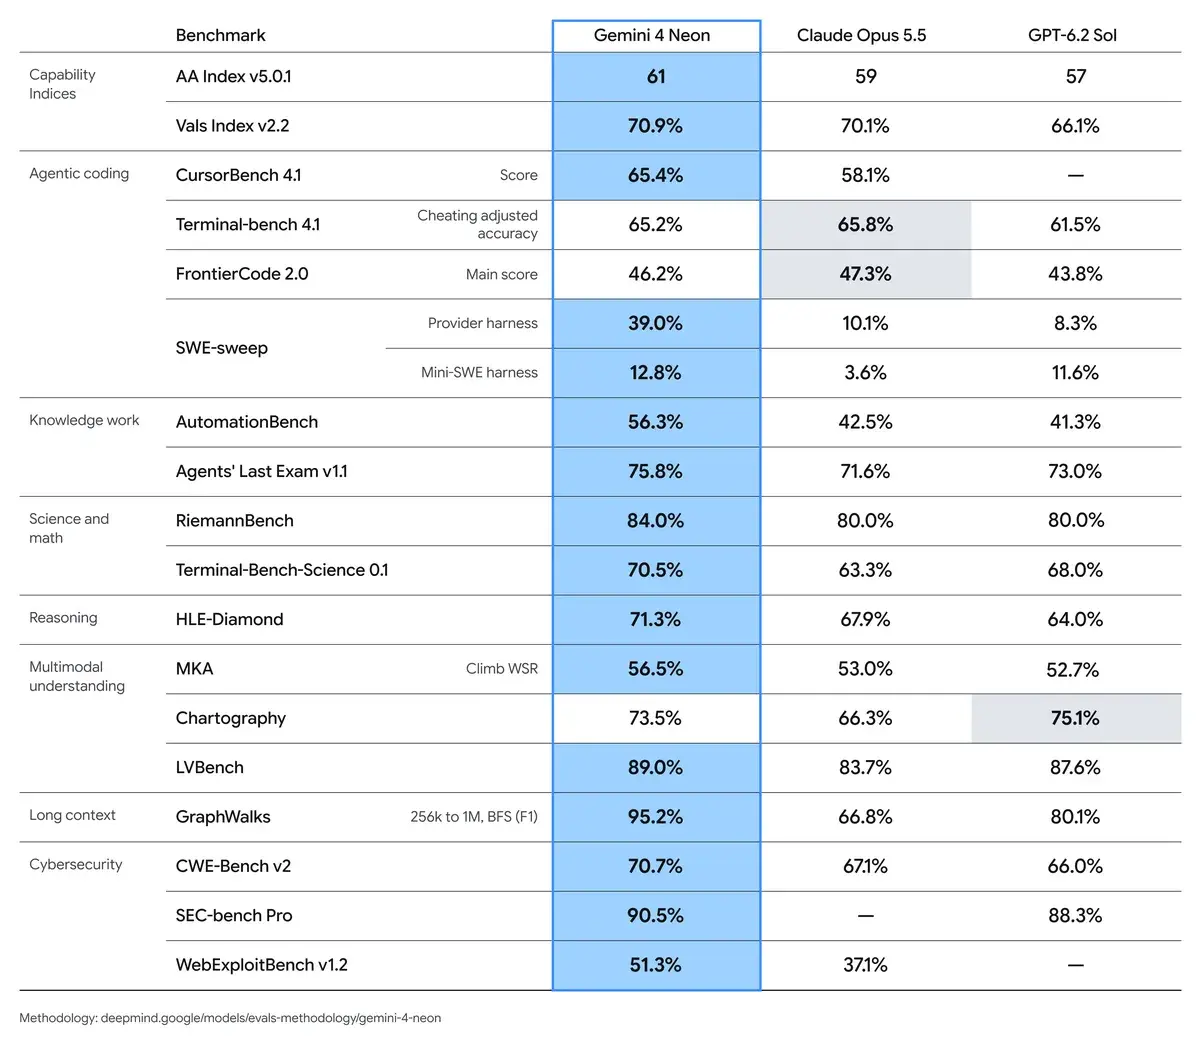
Google が発表したテスト データによると、Neon は Vals Index で 70.9% のスコアを達成し、法律調査と税務当局のテストの両方で 1 位にランクされました。 Zapier AutomationBench 自動タスク テストでは、56.3% のスコアを獲得しました。 Andon Labs の Vending-Bench 2 長期ビジネス シミュレーションでは、シミュレーション収益は 16,843 ドルに達しました。さらに、Chartography プロフェッショナル チャート理解テストでは 73.5%、Agents' Last Exam v1.1 テストでは 75.8% のスコアを獲得しました。
科学的および数学的推論も、Neon が強化に重点を置いている能力です。 Terminal-Bench Science テストでは 70.5% を達成しました。リーマンベンチ数学テストでは 84.0% を達成しました。 HLE-Diamond テストでは 71.3% を達成しました。これらの結果は、Neon をプログラミングに適しているだけでなく、複雑な科学研究、数学的分析、技術研究タスクも実行できる一般的なモデルとして位置づけたいという Google の意向を反映しています。
サイバーセキュリティは、このリリースのもう 1 つの焦点です。 Google は、主に安全なコードの生成、脆弱性の発見、侵入テストの検証、およびコードの修復に使用される、ネットワーク セキュリティ作業用の Gemini 4 Neon の専用バージョンを発売しました。 AutoBaxBench テストでは、このバージョンは難しいプロジェクトで 76% のスコアを達成しました。 WebExploitBench v1.2 テストでは 51.26% を達成しました。 SEC-bench Pro 脆弱性発見テストではスコアが 90.5%、CWE-bench v2 コード強化テストでは 70.7% に達しました。
Google は、Neon はネットワーク セキュリティ機能を向上させながらも、依然として Carbon に匹敵する厳しい悪用防止機能を維持しており、悪意のあるプロンプト インジェクションに対するモデルの耐性をさらに向上させたと述べています。ネットワーク セキュリティ固有のバージョンは、Fairwind プログラムを通じて段階的に資格のあるセキュリティ防御者に提供されます。
セキュリティと信頼性の観点から、Google は長期にわたる複数ステップのタスクを実行する際の Neon の動作制御を特に重視しています。同社によれば、このモデルはユーザーの指示に従いやすくなり、架空の結果、タスク範囲の不正な拡大、要件を満たさないショートカットの実行などの問題を軽減できるという。内部テストでは、Neon の行動指標の一部は以前の Carbon よりも優れていましたが、これらのデータは主に Google 独自の評価システムから得られたものであり、検証するにはさらに独立したテストが必要です。
価格に関しては、Gemini 4 Neon が Gemini API を通じて提供する標準価格は、100 万個の入力トークンあたり 3 米ドル、100 万個のキャッシュされた入力トークンあたり 0.15 米ドル、100 万個の出力トークンあたり 15 米ドルです。比較すると、Carbon の現在のプロモーション価格は、入力トークン 100 万あたり 2 ドル、出力トークン 100 万あたり 10 ドルですが、このオファーは 11 月 30 日まで続く予定です。12 月 1 日から、Carbon の標準価格は入力トークン 100 万あたり 4 米ドル、出力トークン 100 万あたり 20 米ドルに調整されます。その時点で、Neon の単一トークンの価格は Carbon より 25% 低くなります。
ただし、トークンの価格を単純に比較するだけでは、実際の使用コストを完全に反映することはできません。 Google は、Neon はタスクをより速く完了し、同じ作業を完了するためのトークンの消費量を削減できるため、実際のワークロード下での単一タスクのコストが低くなる、と強調しました。 Google が発表したデータによると、デフォルトの高思考モードでは、Neon のタスク完了コストは Carbon より 32% 低くなります。より高い xhigh モードでも、Neon には依然としてコスト上の利点がありますが、特定の範囲はタスク タイプとモデル構成によって影響されます。
ジェミニ 4 ネオンは現在、徐々に開いています。開発者は Google AI Studio および Gemini API の有料サービスを通じて使用でき、企業顧客は Gemini for Business および Antigravity を通じてアクセスできます。消費者側では、Google AI Pro および Ultra の加入者は Gemini アプリで Neon を選択でき、Pro および Ultra ユーザーは Antigravity でもそれを体験できます。
一般に、Neon は単にモデル サイズの拡大や単一テストのスコアの向上を追求しているのではなく、実際の使用においてより重要な問題、つまり、主力の推論機能を備えたモデルに実際の作業をより高速かつ低コストで完了させる方法を解決しようとしています。 AI エージェントを頻繁に呼び出したり、大規模なコード ベースを処理したり、複雑なオフィス タスクを実行したりする必要があるユーザーにとっては、純粋なモデル パラメーターやベンチマーク ランキングよりもタスク完了効率の方が実用的に重要である可能性があります。
コメント