
要約:
11 月 6 日、Google は木曜日にビデオ生成モデル Gemini Omni 1.2 Flash を正式に発売しました。このモデルは、複数ラウンドの対話によるネイティブ 15 秒ビデオの生成と編集をサポートしています。価格は前世代より 30% 下がりました。
Gemini Omni 1.2 フラッシュ
Google によると、Gemini Omni 1.2 Flash は、Gemini API、Google AI Studio、Google Cloud Console、Flow、Google Vids、Google AI Ultra 加入者向けの Gemini アプリケーション、および Google 広告を通じて展開されます。生成された各ビデオには、その起源を示す知覚できない SynthID の透かしが入れられます。
モデルによって生成されるビデオ クリップの長さは、以前の最大 10 秒から 3 ~ 15 秒に設定できるようになりました。同時に、720p ビデオ生成の価格は 30% 引き下げられ、1 秒あたり 0.07 ドルになりました。ユーザーは、進行中の会話を通じて生成されたビデオを編集することもできます。
その際立った機能の 1 つは、Google が「会話型編集」と呼ぶものです。ユーザーは、ビデオ全体を再生成することなく、背景の変更、照明の調整、アスペクト比の変更など、複数回の対話を通じて、生成されたビデオを徐々に調整できます。 Googleによれば、この機能は15秒全体のビデオの編集をサポートしているという。
この機能を階層型ワークフローと組み合わせることで、制作コストの削減も期待されます。ユーザーはまず最初のドラフトを 360p または 720p の解像度で生成し、その後の編集で個々の詳細を修正し、最後に最終フィルムのみをアップコンバートして解像度を 1080p または 4K に高めます。
Google は、参考資料に従うモデルの能力も大幅に向上したとも述べています。公式発表によると、ユーザーはキャラクター画像や商品写真、最大3秒の短いビデオクリップ、音声プロンプトを入力できるとのこと。このモデルは、さまざまな撮影角度の下でも、キャラクターの顔、服装、製品パッケージのテキスト、ブランドのカラーマッチングの一貫性を維持できます。
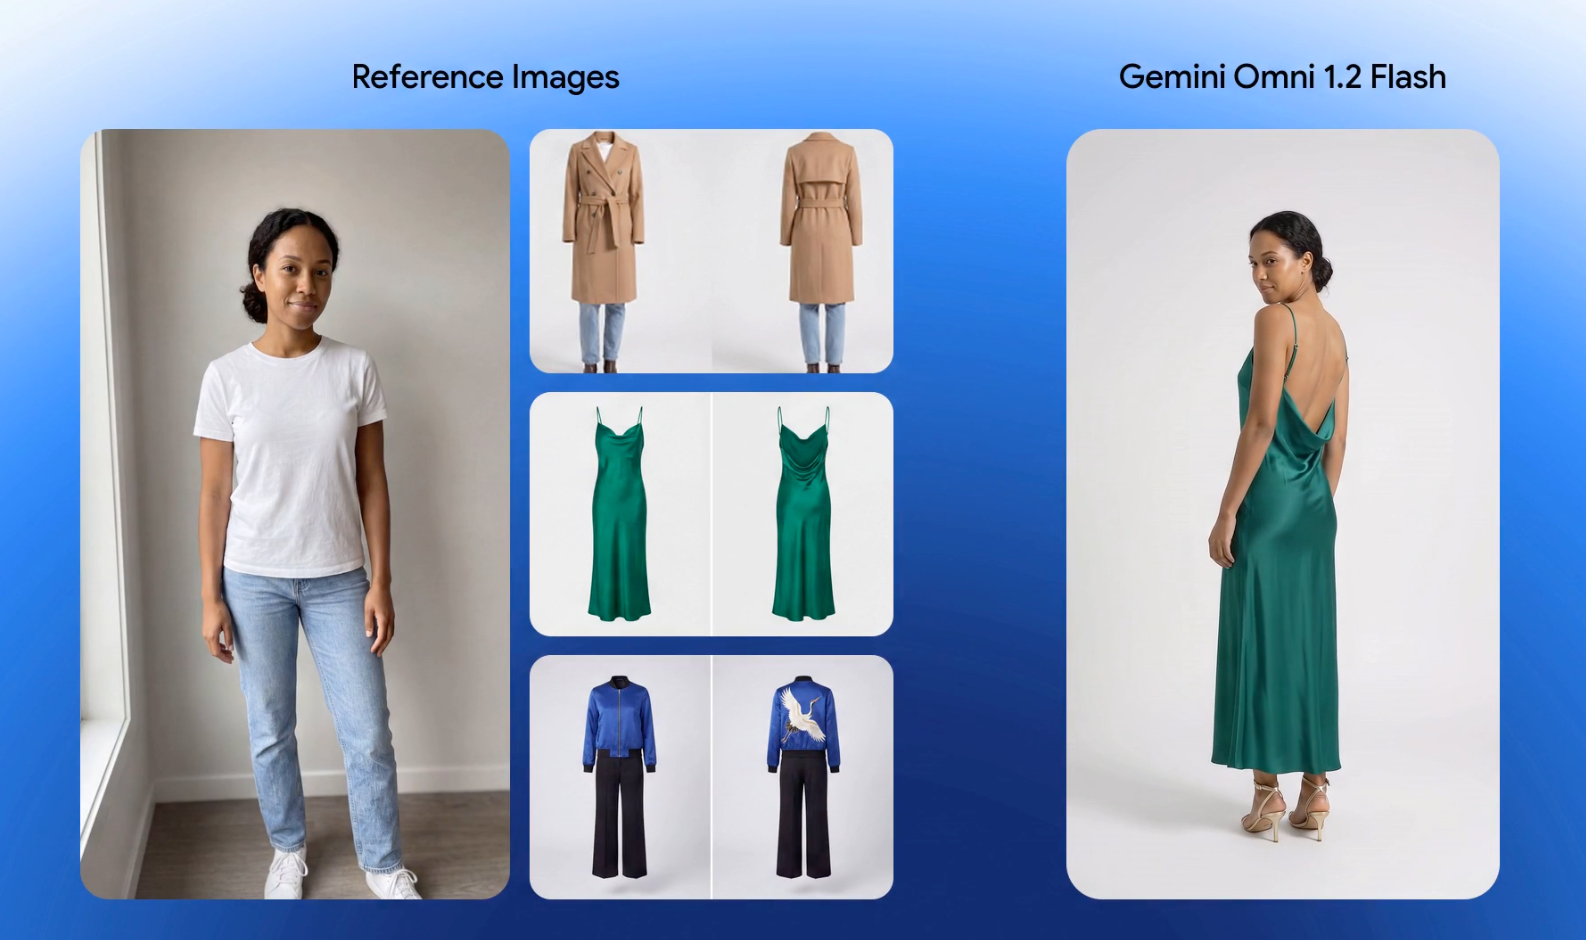
資料を追う能力が大幅に向上しました
Google は仮想試着セグメントを例に挙げています。1 枚のモデル写真と 3 セットの衣類の製品画像を使用するだけで、モデルはモデルのアイデンティティと各衣類のカットとドレープを維持しながら、360 度回転する 15 秒の連続シーンを生成できます。
同時に、全体的な視覚的な一貫性も向上しました。 Googleによれば、新モデルは前世代モデルと比べて、画面移動時やレンズ切り替え時の視覚的なズレや変形が少ないという。
さらに、Gemini Omni 1.2 Flash は、よりスムーズで自然な会話音声を生成でき、口の形と音声の同期効果がより正確になり、複数の異なる話者を区別する機能も備えています。
このモデルは、FPV ドローンの飛行ショットや視覚的なインパクトが強い高速ズーム ショットなど、複雑で連続的なカメラの動きをより適切に処理できるようになり、不必要なジャンプ カットが大幅に削減されます。
コメント