
要約:
Linux の創設者 Linus Torvalds は、カーネル開発における人工知能プログラミング ツールの応用をさらに研究しています。最近 Anthropic の Claude Code を利用して Linux カーネル パフォーマンス最適化パッチを開発した後、Torvalds 氏は大規模言語モデル (LLM) を使用して、長い間理解することが困難だったカーネル コードの一部を分析しました。彼は、開発者によって以前に報告された欠陥を確認しただけでなく、10 年以上眠っていた他の 3 つの脆弱性も発見しました。これらの問題はすべて、Linux カーネルでの連想配列の実装に関連しています。
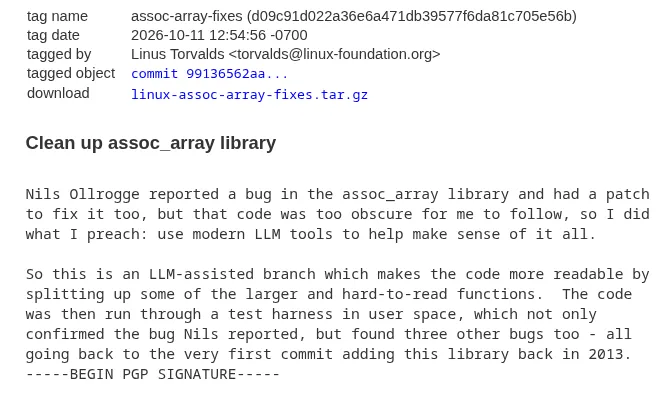
Phoronix が 10 月 12 日にリリースしたレポートによると、Torvalds 氏は最近、連想配列コードに対する一連の修復を整理してマークするために、「assoc-array-fixes」と呼ばれる Git タグを Linux カーネル コード リポジトリに追加しました。この研究は、クロード コードを使用してファイル読み取りパフォーマンスを最適化するという以前のプロジェクトとは独立していますが、どちらも複雑なカーネル開発プロセスに AI ツールを導入するという彼の試みを反映しています。
この作業の原因は、開発者の Nils Ollrogge が連想配列ライブラリのバグを報告し、対応する修正パッチを提出したことでした。しかし、トーバルズ氏がパッチをレビューしたところ、関連するコードの実装があまりにも難解で、その特定のロジックを直接理解できないため、パッチが問題を正しく解決したかどうかを簡単に判断するのは不可能であることがわかりました。
この状況に直面して、トーバルズ氏は分析を支援するために最新の大規模言語モデルを使用することを選択しました。彼は Git タグの説明に、今回は以前から提唱していたアプローチ、つまり複雑なコードの理解を助けるために最新の LLM ツールを使用するというアプローチを採用したと書いています。
トーバルズ氏はその後、AI を利用した修正を加えた一連のパッチを整理して、一部の大きくて読みにくい関数をより明確な構造に分割し、コード ロジックを理解して確認しやすくしました。注目に値するのは、この作業の目的は、単純に連想配列の実装全体を AI に書き換えさせることではなく、まず既存のコードの可読性を向上させ、その後、その動作が期待どおりであるかどうかをテストを通じて検証することです。
変更が完了すると、関連するコードもユーザー空間テスト フレームワークに組み込まれて実行されます。テストでは、Olrog によって最初に報告されたバグが実際に存在することが確認されただけでなく、さらに 3 つの問題も発見されました。
さらに懸念されるのは、これらの欠陥が最近発生した新しい問題ではないということです。 Torvalds 氏によると、さらに発見された 3 つの脆弱性は、連想配列ライブラリが Linux カーネルに初めて導入された 2013 年に遡ります。言い換えれば、それらは関連するテストによって完全には検出されずに、10 年以上コード内に潜んでいたということです。
Linux カーネルの連想配列は、キー値によってデータを編成および取得するために使用されるデータ構造です。整数の添字を介して要素にアクセスする通常の配列とは異なり、連想配列は特定のキーに基づいて対応するデータを検索できるため、オブジェクトの柔軟なインデックス付けと管理が必要なシナリオに適しています。
Linux カーネルの連想配列の実装は、カーネル内のデータ管理のニーズに応えます。カーネル コードは、厳密なパフォーマンス、メモリの安全性、および同時アクセスの要件の下で実行する必要があるため、このような基本コンポーネントの実装は、通常のアプリケーションの同様のコードよりも複雑になることがよくあります。関数が表面上はデータの挿入、削除、または検索のみを実行する場合でも、ツリー構造の調整、ノードのライフサイクル管理、およびさまざまな境界条件が含まれる場合があります。
このタイプのコードには明確な構造が欠けているため、保守者がコードの動作を理解することがさらに困難になります。開発者は、通常時の動作ロジックを確認するだけでなく、異常な入力や特殊なデータ構造の状態、複数の動作を連続して実行した場合に発生する問題などを解析する必要があります。
コードが進化し続けると、初期の実装では簡単に引き起こされなかった欠陥が長期間残る可能性があります。特に複雑なデータ構造では、一部のエラーは特定の操作シーケンスまたは特殊な構造状態でのみ明らかになり、通常のテストでは必ずしもすべての状況をカバーできるとは限りません。
この AI 支援の作業で採用されたアイデアは、まず理解するのが難しい大きな機能を分析しやすい部分に分割し、その後、独立したテスト プログラムを通じて関連するロジックを検証するというものです。コード構造が明確になると、開発者がさまざまな操作間の関係を特定しやすくなり、テスト ツールが特定の動作の検証条件を構築しやすくなります。
しかし、今回発見された 3 つの脆弱性は、単に AI が人間を超えてプログラムを理解する能力に起因するものではありません。より正確には、AI 支援のコード リファクタリング、開発者レビュー、テスト フレームワークがすべて連携して動作します。大規模な言語モデルはコード ロジックを整理し、潜在的な問題を特定するのに役立ちますが、最終的には実際の実行と反復可能なテストを通じて欠陥が本物であるかどうかを確認する必要があります。
このケースの特別な点は、AI がコード分析に参加しただけでなく、パッチ レビュー プロセス中にトーバルズ氏が理解の障壁を解決するのにも役立ったということです。大規模なオープンソース プロジェクトを保守する開発者にとって、これは実用的な価値のある作業方法となる可能性があります。コードが複雑すぎて、保守者が修復計画が正しいかどうかをすぐに判断することが難しい場合、AI を使用してコード構造の整理を支援し、テストと手動レビューを通じて結論を検証できます。
現在、この連想配列の修正セットはまだ Linux カーネル メインラインにマージされていません。 Phoronix のレポートによると、今後の Linux 7.4 マージ期間中に関連作業がさらに進められる予定ですが、最終的なマージが完了するかどうかはその後のコード レビューとテストの結果に依存します。
トーバルズ氏が Linux カーネル開発における AI の使用を最近公に実証したのはこれが初めてではないことは注目に値します。
以前、彼はクロード コードを使用して別のカーネル最適化作業を実行していました。目標は、複数のスレッドが同じファイルを同時に読み取るときにメモリ ページ参照カウント操作によって引き起こされる競合問題を解決することでした。関連するパッチは、ファイル読み取りパスを調整することで不必要な参照カウント操作を削減し、それによって特定のワークロードでの読み取りパフォーマンスを向上させようとします。
その作業では、AI が最初のコード作成、テスト プログラム開発、コード レビュー、パッチノート ドキュメントの草稿に参加しました。 Torvalds は、最適化の方向性を決定し、開発プロセスを監督し、自分のコンピュータでパフォーマンス測定を実行する責任を負います。
2 つのタスクの技術的目標は異なりますが、同様の開発モデルを具体化しています。カーネルに精通したエンジニアが問題を特定し、AI を使用して複雑な実装を理解し、コードを作成または調整し、最後にテストを通じて結果を検証します。
このモデルは、Linux のような大規模でメンテナンス サイクルが長いオープン ソース プロジェクトにとって特に価値があると考えられます。カーネル コードは数十年にわたって進化し続けており、広範な実装履歴と複雑な互換性要件が含まれています。経験豊富なメンテナであっても、各サブシステムの詳細をすべて常に把握しているとは限りません。
従来のコード レビューでは、主に開発者がコードを読み取り、ロジックを分析し、テストを設計します。 AI ツールは、保守者が馴染みのないコードをより迅速に分類し、関数間の関係を説明し、考えられる境界条件を提案し、テスト ケースの生成を支援するのに役立ちます。専門的なレビューに代わるものではありませんが、複雑なコードを理解するための時間コストを削減することが期待されます。
同時に、AI が生成したコードにも限界があります。大規模な言語モデルは、複雑な制御フローを誤解したり、まれな境界条件を無視したり、合理的に見えても実際には正確さを保証しない変更を提案したりする可能性があります。コード エラーはシステムの安定性、メモリの安全性、さらにはシステム全体の信頼できる動作にさえ影響を与える可能性があるため、オペレーティング システム カーネルの場合、これらの問題は特に重要です。
したがって、AI がカーネル開発に参加しても、レビュー要件が緩和されるわけではありません。代わりに、コードのリファクタリング、自動テスト、パッチ レビュー、および実際の検証が、変更の品質を確保するための鍵となります。連想配列プロジェクトは長年の問題を発見することができました。これは、AI ツールが効果を発揮するには厳格なエンジニアリング検証プロセスと組み合わせる必要があることを示しています。
トーバルズ氏は、AI プログラミング ツールに対して常に実用的な態度をとっています。同氏は、開発プロセスを支援する AI の価値を認識していましたが、開発者が機械生成コードをレビューせずに受け入れるべきであるとは主張しませんでした。今回、彼はコードの分析に LLM を使用していると公に述べ、AI がカーネル開発ツールボックスの補助的なオプションになりつつあることをさらに示しました。
より広範には、このインシデントは、大規模なソフトウェア プロジェクトの維持における長年の困難にも光を当てています。コードは正しく実行される必要があるだけでなく、将来の開発者が理解できるものでなければなりません。 10年以上、場合によっては数十年にわたって保守され続ける基本ソフトウェアでは、可読性自体が信頼性を左右する重要な要素となります。
この変更により、複雑な関数を分割することでコード構造が改善され、テストを使用して以前は見落とされていた問題が発見され、コードの可読性と欠陥のトラブルシューティングとの間に密接な関係があることが実証されました。プログラム ロジックが明確になると、開発者は潜在的なエラー パスを特定し、関連する動作をカバーするテストを構築することが容易になります。
このパッチ セットが最終的に Linux メインラインに導入される場合、その重要性は、特定された 4 つの問題を解決するだけでなく、その後のメンテナンスのためのより明確なコード ベースを提供することにもなります。
AI プログラミング ツールは開発を続けるため、将来的には大規模なオープンソース プロジェクトで同様のケースがさらに増える可能性があります。しかし、Linux カーネルなどの主要な基本ソフトウェアの場合、AI 支援開発が長期的な評価を獲得できるかどうかを決定するのは、パッチが厳格なレビューに合格できるかどうか、テストで問題を再現できるかどうか、そして最終コードが十分に信頼できるかどうかです。
今回、AI は Linux 創設者に代わって最終的な判断を下すことはありませんでしたが、もともとレビューが困難だったコードを理解して、長年隠されていた欠陥をさらに発見するのに役立ちました。成熟したソフトウェア エンジニアリングにとって、これは人工知能の最も実用的な応用方向の 1 つである可能性があります。
コメント