
要約:
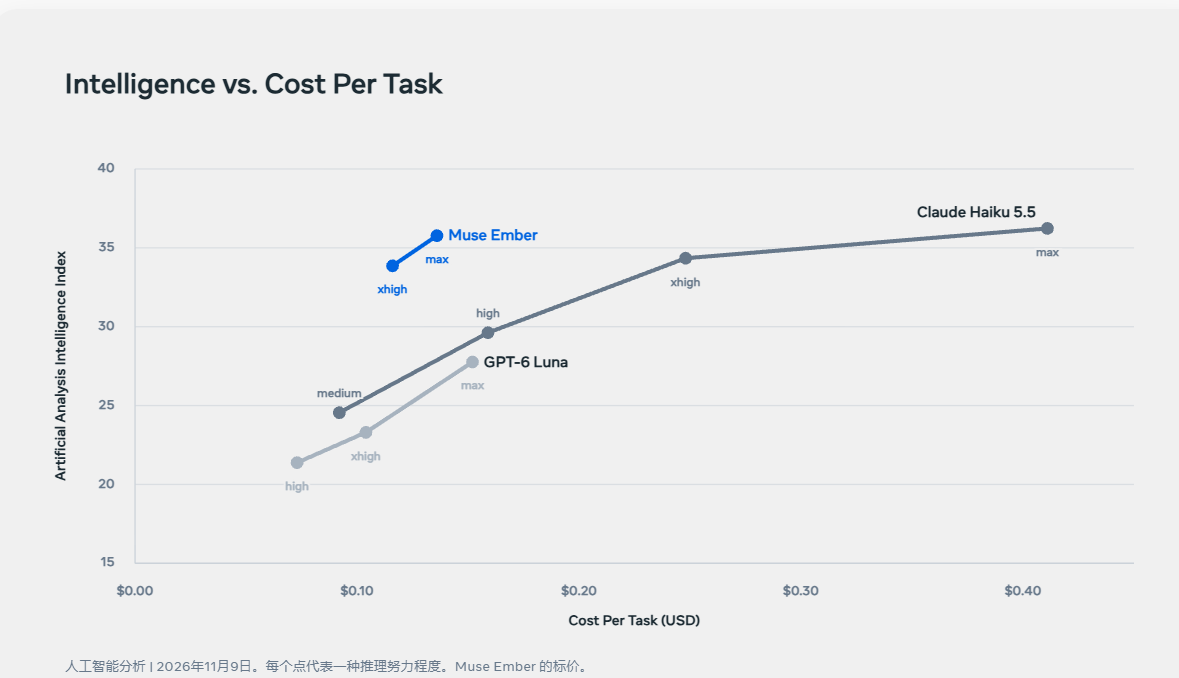
Meta released the lightweight AI model Muse Ember on November 9, local time.第三者評価機関 Artificial Analysis のデータによると、このモデルは総合知能指数で 36 ポイントを獲得しました。
これは、Anthropic の Claude Haiku 5.5 の最高推論ギアと同じですが、単一の評価タスクのコストは後者の約 3 分の 1 です。
。
メタは Muse Ember を最小かつ最も効率的なモデルとして位置付けています
、主に、ツールの呼び出し、プログラミングのサブタスクの実行、リクエストのルーティング、情報の抽出、長いドキュメントの解析など、AI エージェントによって繰り返し処理する必要がある高頻度のタスクに使用されます。モデルは、テキスト、画像、オーディオ、ビデオ、PDF などの複数の入力フォームを受け取り、結果をテキスト形式で出力できます。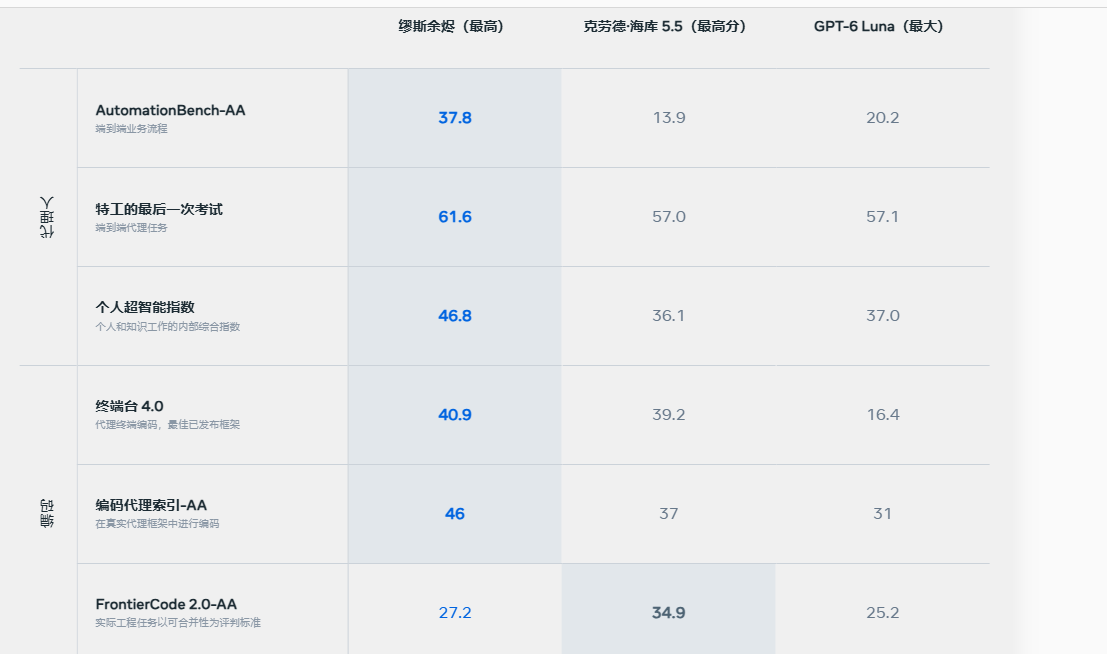
Muse Ember には約 100 万トークンのコンテキスト ウィンドウがあり、最大約 512,000 トークンを出力でき、1 回のリクエストでより大きなコード ベースやドキュメント コレクションを処理できます。
。このモデルは現在、Muse コードとメタ モデル API を通じてオンラインになっており、モデル番号は「muse-ember-1.0」です。価格に関しては、Muse Ember は入力トークン 100 万あたり 0.10 米ドル、キャッシュされた入力 100 万あたり 0.004 米ドル、出力トークン 100 万あたり 0.50 米ドルを請求します。人工分析によるテストによると、
最も高い推論ギアのコストはタスクあたり約 0.14 米ドル、Claude Haiku 5.5 では同様のタスクを完了するのに約 0.41 米ドルかかります
。ただし、異なる評価プロジェクトの結果には違いがあります。 Meta が公開したテストでは、Muse Ember が一部のエージェント、ツール呼び出し、マルチモーダル タスクにおいて Claude Haiku 5.5 や OpenAI の GPT-6 Luna よりも優れていることが示されています。プロジェクトのメンテナがコードの変更を採用できるかどうかを調べる FrontierCode 2.0 テストでは、Muse Ember のスコアは Claude Haiku 5.5 よりも低かった。
コメント