
要約:
イーロン マスク氏の人工知能企業である XAI は、データセンターの規模をさらに拡大しており、今後数年間で 120 万個を超える Nvidia AI GPU を導入する予定です。 Colossus データセンターが拡大を続ける中、xAI は大規模コンピューティング インフラストラクチャを通じて次世代 Grok モデルをトレーニングおよび実行し、OpenAI などの競合他社とのより激しい AI インフラストラクチャ競争を開始したいと考えています。
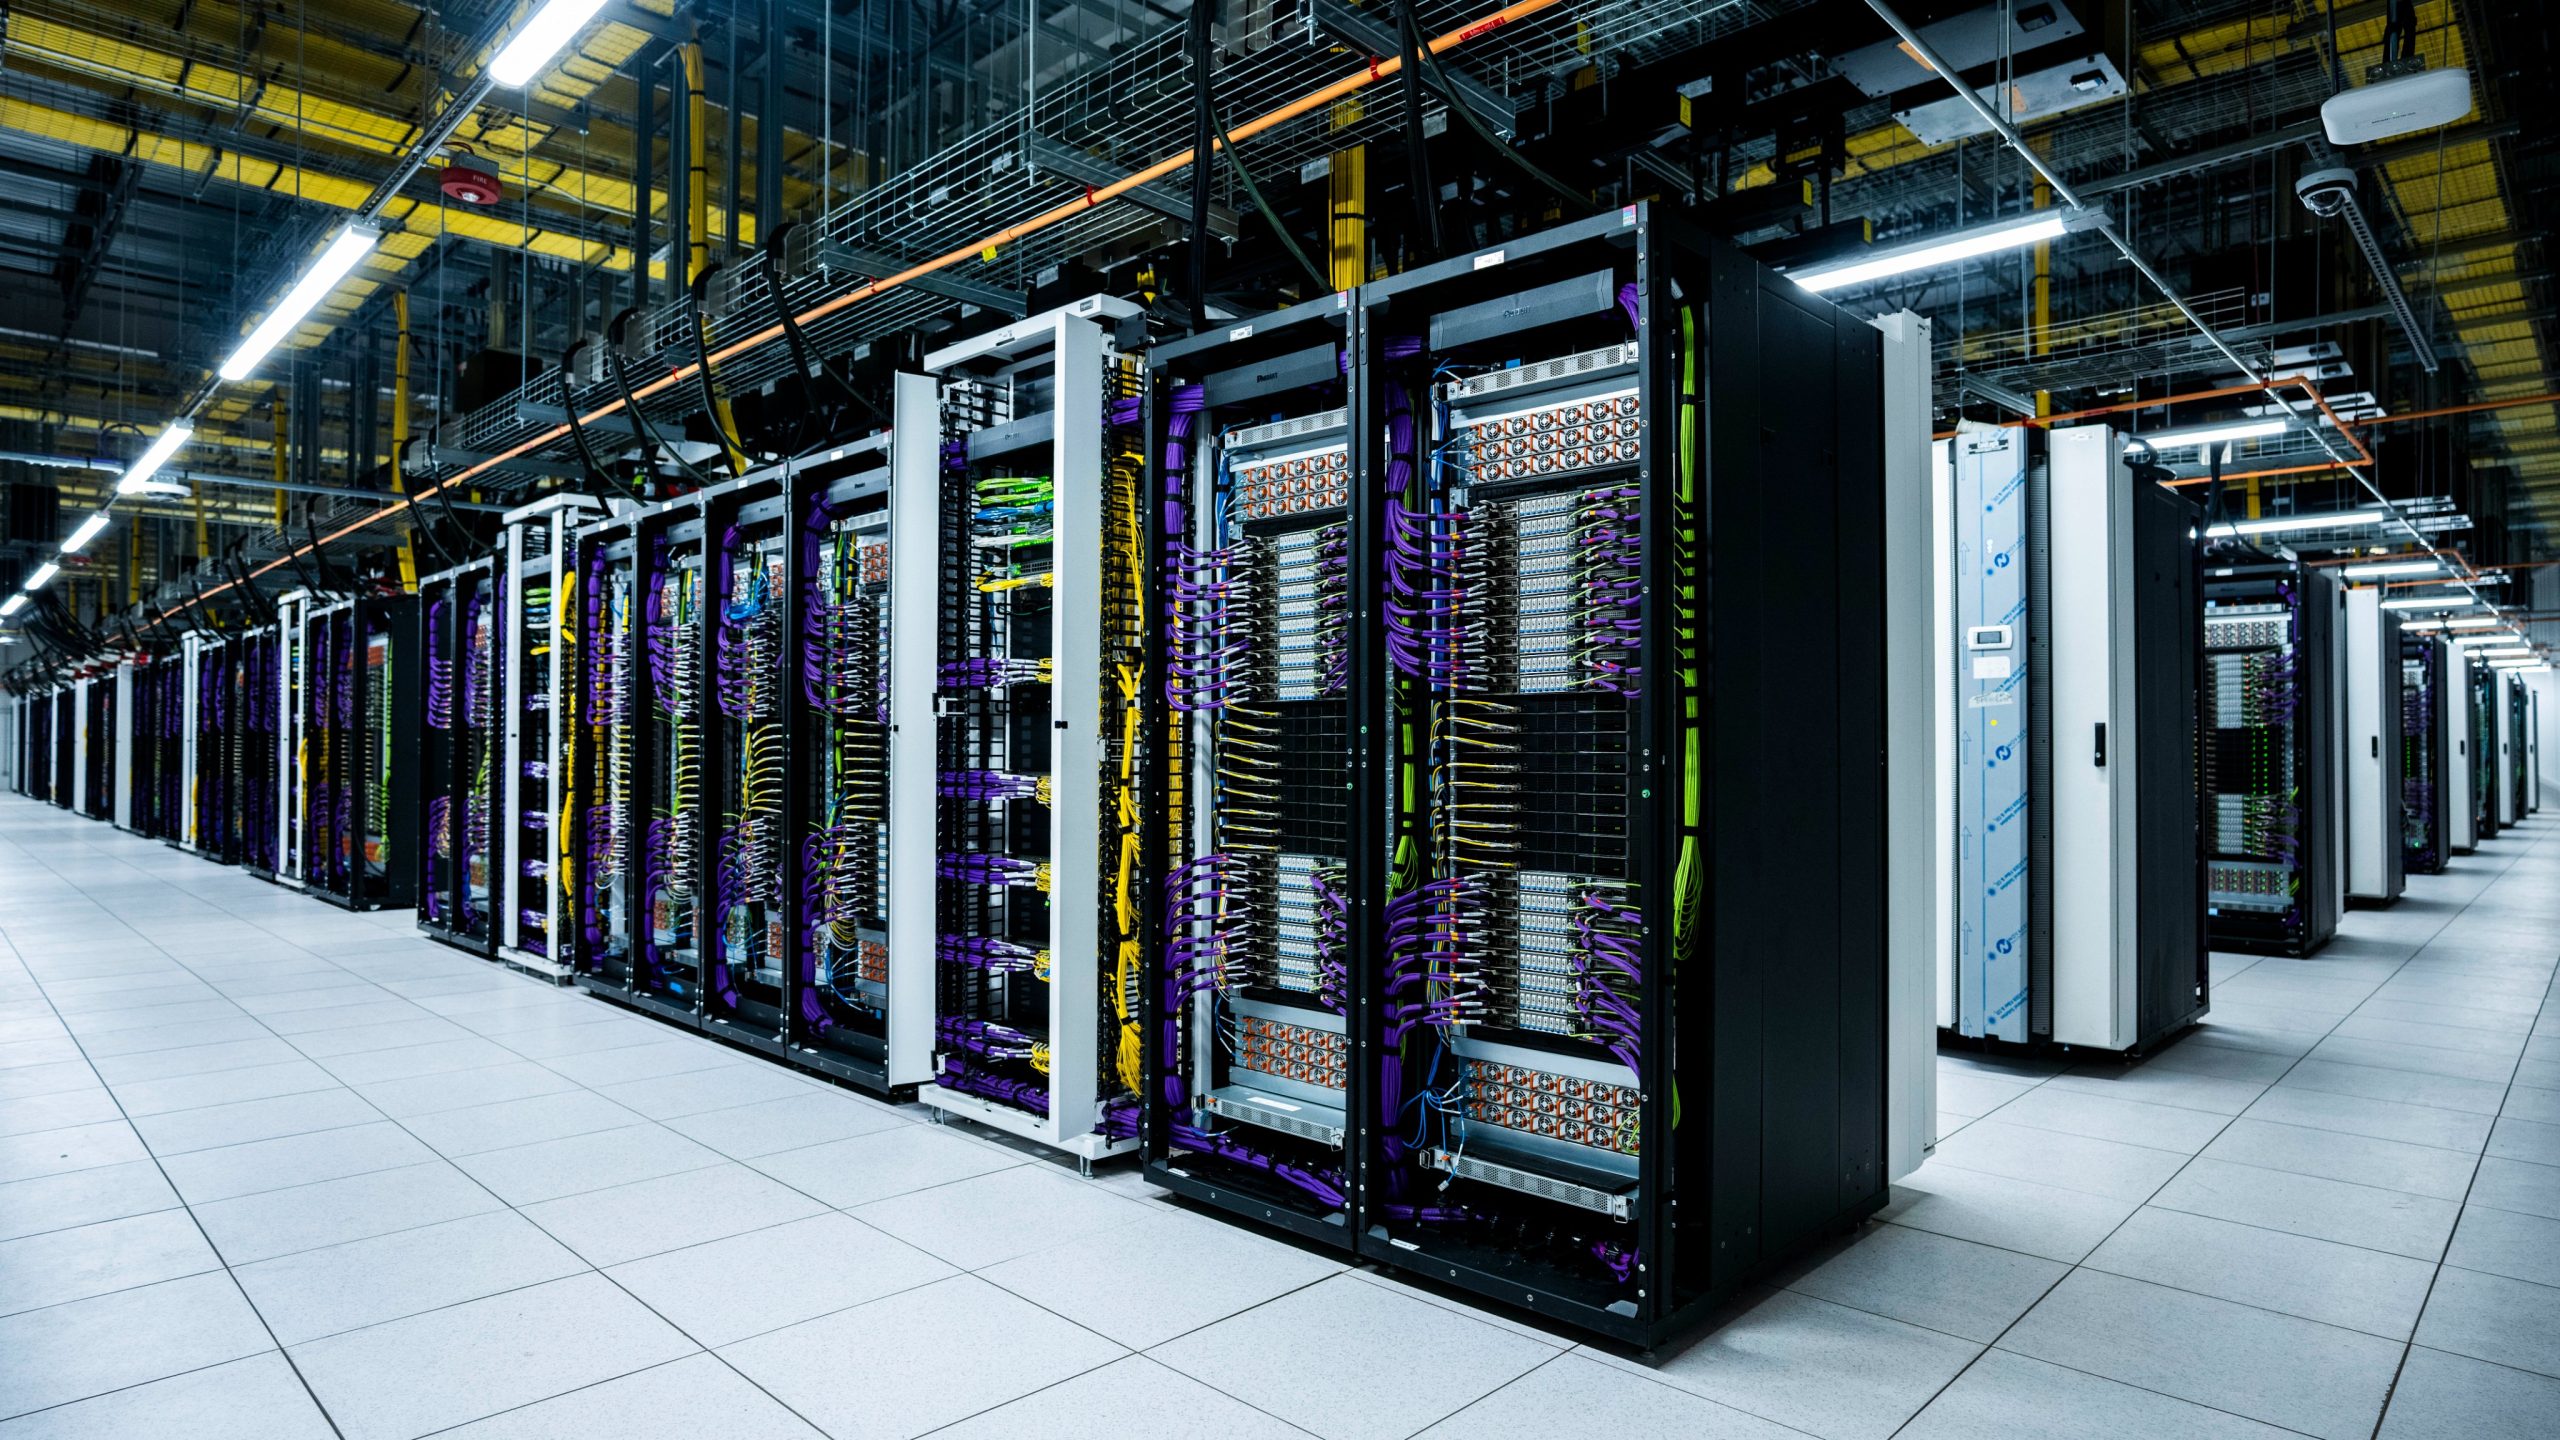
xAI の現在最大の AI インフラストラクチャ プロジェクトは、米国テネシー州メンフィスにある Colossus データ センターです。プロジェクトの建設は 2024 年に始まり、第 1 フェーズであるコロッサス 1 はすでに稼働しています。マスク氏は以前、ColossusをxAIの「コンピューティングパワーのスーパーファクトリー」と呼んでおり、その主な目標は多数のGPUをできるだけ早く一元的に導入することだ。
Colossus は当初、NVIDIA H100 GPU を使用していました。以前に発表された第 1 フェーズの規模は、H100 が約 20 万台です。その後の拡張に伴い、データセンターはより高度な Blackwell シリーズ GPU を追加し始めました。最新の情報によると、Colossus 1 にはオリジナルの H100 に加えて、約 30,000 個の Nvidia GB200 が導入されているため、Colossus 1 の現在の GPU 数は約 230,000 個に達しています。
xAI の第 2 フェーズである Colossus 2 はさらに規模が大きくなります。このプロジェクトもメンフィスにあり、500,000 個を超える NVIDIA GPU を導入する予定です。現在の計画によれば、Colossus 2 は世界最大の AI データセンター プロジェクトの 1 つとなり、その計算能力は従来のスーパーコンピューターの能力をはるかに上回ります。
Colossus 1、Colossus 2、およびその後の建設プロジェクトをすべて含めると、xAI が将来使用する予定の NVIDIA GPU の数は約 120 万以上に達します。この数は、これらすべての GPU が設置されたことを意味するものではなく、xAI の将来のデータセンター拡張計画の全体的な規模に相当します。
xAI の GPU 数の大幅な拡大は、AI モデル トレーニングのためのコンピューティング パワーに対する需要の急速な増加に直接関係しています。大規模言語モデルのパラメーター スケール、トレーニング データ、強化学習プロセスには、ますます多くのコンピューティング リソースが必要になり、モデルのトレーニングと推論に必要なコンピューティング能力は、従来のデータ センターの規模からスーパーコンピューティング クラスターの規模に進化しています。
この場合、多数の GPU を備えていることが、AI 企業がモデルの機能を拡張するための重要な基盤となっています。マスク氏は、xAIは独自のスーパーコンピューティングクラスターを構築することで、できるだけ早くコンピューティング能力を拡張し、サードパーティのクラウドコンピューティングプラットフォームへの依存を減らす必要があると繰り返し強調してきた。
Colossus の建設速度も、xAI インフラストラクチャ戦略の大きな特徴です。第 1 段階のデータセンターは、放棄された産業施設をベースに改修され、xAI は、多数のプレハブ設備、並列建設、GPU の迅速な展開を通じて、短期間で数十万の GPU を備えた大規模な AI トレーニング施設に拡張しました。
xAI はまた、Colossus のデータセンターの構築と電力供給能力の拡張を続けています。最新の AI GPU の消費電力は非常に高いため、データセンターの拡張は単にサーバーの数を増やすだけでは済みません。また、大量の電力、冷却、ネットワーク、ストレージのインフラストラクチャも同時に構築する必要があります。
xAI は以前にも電源の問題に直面していました。 Colossus 1 の消費電力は数百メガワットに達し、GPU の数がさらに増加すると、必要なエネルギーも大幅に増加します。その後の拡大をサポートするために、xAI は新しい電力源を探し、対応する発電および配電インフラストラクチャを構築してきました。
NVIDIA Blackwell と後続の Rubin シリーズ GPU が徐々に市場に参入するにつれて、xAI のデータセンターはハードウェアのアップグレードを継続します。 H100 と比較して、新世代の GPU はより高い AI コンピューティング パフォーマンスを提供できますが、単一の GPU の消費電力も増加しています。したがって、将来の大規模 AI データセンターは、コンピューティング密度とエネルギー供給の問題を同時に解決する必要があります。
マスク氏はまた、xAI が 2027 年頃にデータセンター全体の電力容量を大幅に増加させ、コンピューティング能力を以前の規模の数倍に拡大する計画であると以前述べました。関連計画によると、xAI の将来のデータセンターの総電力規模は数ギガワット、さらには 10 ギガワットに達する可能性があります。
このような巨大なインフラストラクチャは、xAI が大手クラウド コンピューティング企業と同様の AI の「スーパー ファクトリー」を構築しようとしていることを意味します。 GPU サーバー、ネットワーク機器、ストレージ システム、電力設備、液体冷却システムは、Grok などの AI モデルをトレーニングおよび実行するための巨大なコンピューティング クラスターに統合されます。
この戦略により、xAI と OpenAI の間の競争もますます直接的になります。 OpenAI は近年、AI データセンターを大規模に構築しており、NVIDIA と大規模なインフラストラクチャ パートナーシップを確立しています。 NVIDIA は、数百万の GPU に相当する少なくとも 10GW の AI システムを OpenAI に提供する計画を発表しており、インフラストラクチャの展開を含めて OpenAI に最大 1,000 億米ドルを段階的に投資する予定です。
OpenAI の計画は、AI 業界が「ギガワットレベルのデータセンター」を基本的な競争単位として新たな段階に入りつつあることを意味します。以前は、AI 企業間の競争はモデルのアルゴリズム、人材、データに重点が置かれていましたが、現在ではコンピューティング インフラストラクチャ自体がモデル トレーニングの速度と規模を決定する重要な要素となっています。
xAI は、独自の大規模 Colossus データ センターを構築することを選択しました。これにより、同社は GPU の導入、ネットワーク構造、データ センター ソフトウェア、トレーニング インフラストラクチャをより直接的に制御できるようになります。大規模なモデルを継続的にトレーニングする必要がある企業にとって、このアプローチにより、外部クラウド プラットフォームへの依存を軽減しながら、エンジニアリング チームが自社のモデルに合わせてハードウェアとソフトウェアを最適化できるようになります。
ただし、120 万 GPU の規模はまだ将来の目標であり、xAI が現在展開している数ではありません。データセンターの建設、GPU 供給、電源、冷却設備、ネットワーク機器、資本投資の速度はすべて、最終的な導入速度に影響します。したがって、実際に実行されている GPU の数と完了時間は依然として異なる場合があります。
最終的な数値が現在計画されている規模に達するかどうかに関係なく、xAI によって建設中の Colossus は、AI インフラストラクチャ競争が新たな段階に入りつつあることを示しています。 OpenAI、Google、Meta、Microsoft、その他の AI 企業がギガワットレベルのデータセンターを構築するにつれ、将来の AI モデル間の競争は、データセンターの規模、電源、高度な GPU 取得能力間の競争に大きく発展するでしょう。
コメント