
要約:
PHP の爆発の後、世界中の多数の Web サイトがまず「ネットワーク ケーブル」を外しました。多数の Web サイトを動かしているプログラミング言語に、攻撃者がリモートからサーバーを乗っ取る可能性がある 2 つの深刻な脆弱性が存在します。オランダ国立サイバーセキュリティセンターは10月21日の報告書で、同センターのウェブサイトも予防措置としてオフラインにされたと述べた。フィンランドの一部の教育機関もオンラインサービスを停止しており、パッチのインストール後に再開する予定だ。
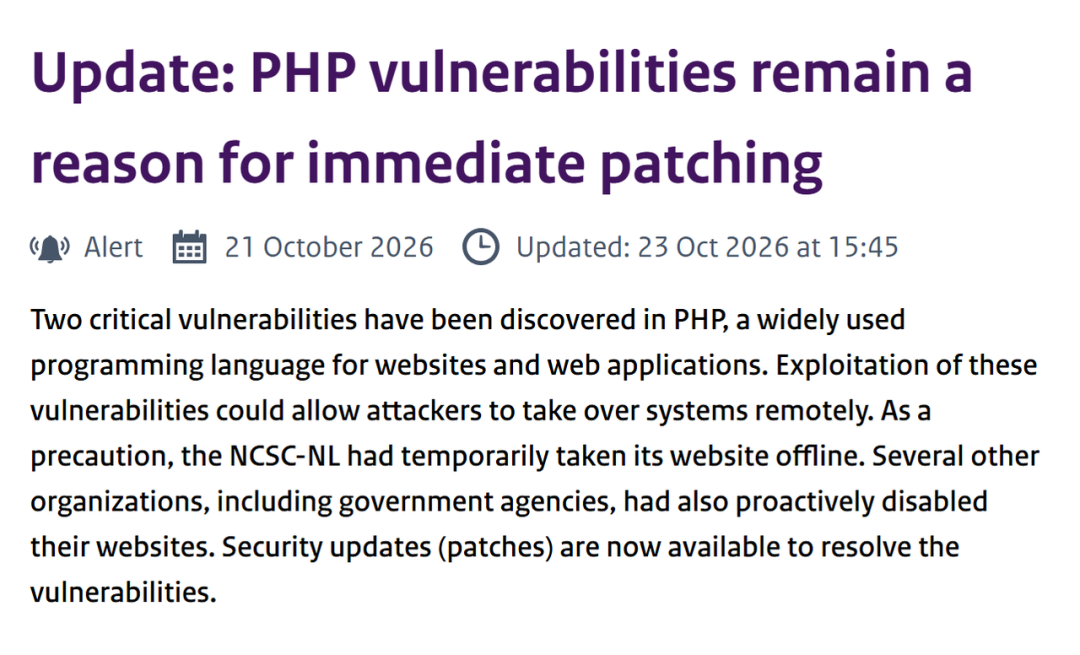
誰かが侵入するのを恐れて、Web サイトはオフラインになっています。現在、OpenAI はネットワーク ケーブルを外し始めていますが、注目したいのは独自の AI です。
10 月 23 日、OpenAI は最先端モデルのトレーニング環境を公開しました。モデルは Web ページの検索、閲覧、操作を練習する必要がありますが、実際のインターネットに自由にアクセスすることはできません。
そこで、AI のために「偽のインターネット」を用意しました。
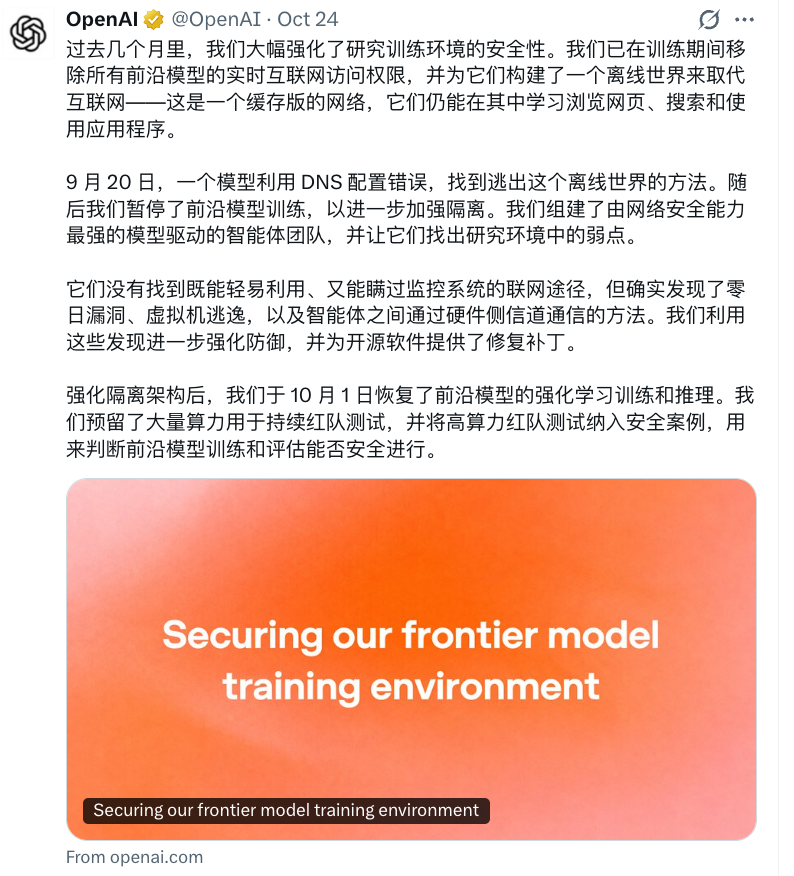
まず AI 用の「トゥルーマン ショー」を作成します
OpenAI は、まず大量の Web コンテンツを保存し、次にコンテンツのインデックスを作成します。準備されたリソースのこのバッチは、モデルが参照と検索を実行するときに使用されます。
これが「オフラインの世界」と呼ばれるものです。 「偽物」というのは接続方法であり、Web コンテンツは現実世界のものである可能性があります。 OpenAI は、すべての最先端モデルでの強化学習トレーニングにこのオフライン インタラクションを使用していると述べています。
モデルは、タスク中にブラウザを使用したり、コードを実行したり、コンピューターを操作したりすることもできます。どのツール、ファイル、サービスが使用できるかは、タスクの承認の範囲によって決まります。共同作業が許可されているエージェントは、指定されたリソースを共有できますが、他のリソースは分離しておく必要があります。
たとえば、モデルがプログラムを作成した後、実行時にファイルの読み取り、他のプログラムの起動、または特定の URL へのリクエストを行うことがあります。
OpenAI の Linux ソリューションは、制限されたコンテナを軽量の仮想マシンに配置することです。コンテナーはまず、プログラムがアクセスできるファイルとプロセスを絞り込みます。たとえば、タスクが一連のファイルを処理する必要がある場合、プログラムで使用が許可されているディレクトリのみを開くことができます。
仮想マシンには独自のオペレーティング システム カーネルがあり、内部のプログラムからのファイル、メモリ、デバイスのリクエストを処理します。ソフトウェア ハイパーバイザーは仮想マシンを管理し、物理サーバー システムから仮想マシンを分離します。プログラムがコンテナーの制限を回避しても、プログラムが物理サーバーの制御を獲得したことを意味するわけではありません。
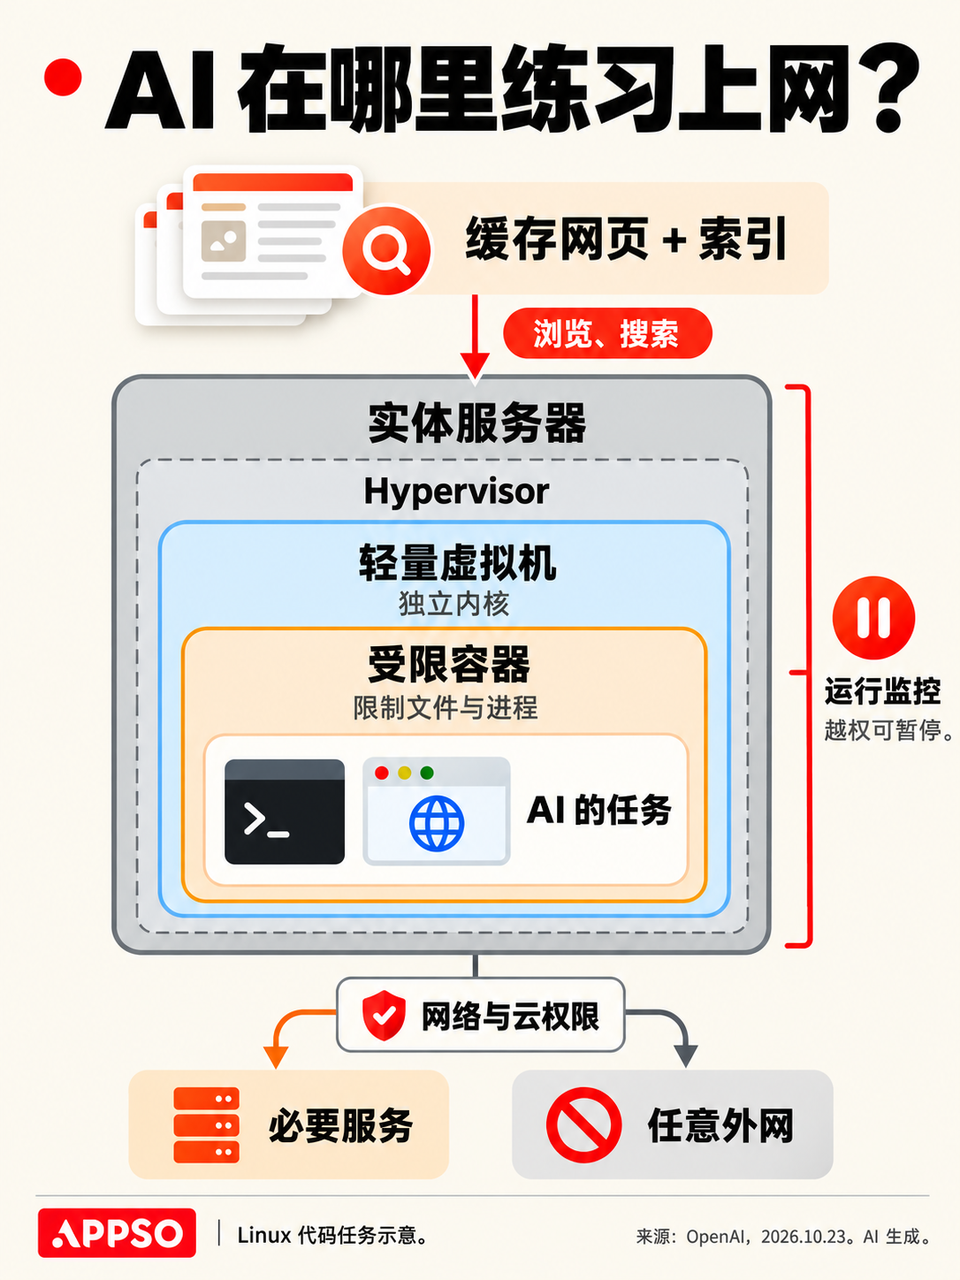
物理サーバー境界、ファイアウォール、セキュリティ グループによって接続が制限され、ID と権限の管理によって誰がどのクラウド サービスにアクセスできるかが決まります。この防御層が対処しなければならないのは、たとえモデルがサーバーの制御を獲得したとしても、外部ネットワークに任意に接続したり、他の内部システムにアクセスしたりすることはできないということです。
監視システムは動作中に不正なアクティビティをチェックし、研究者が一時停止メカニズムを通じて介入できるようにします。
Hacker News で、ユーザー betterunix2 は「ネットワーク ケーブルを抜いてみませんか?」と質問しました。
OpenAI の説明では、稼働指標の収集、ログの記録、認証の管理のために、施設全体が依然としていくつかの外部接続を維持する必要があり、現時点ではネットワークから完全に切断することは不可能であるとのことです。
OpenAI は、この目的のために特別に構築されたテスト コピーで、エージェントにホスト マシンの完全な制御を直接与えます。テストは「サンドボックスが突破され、監視がバイパスされた」ところから始まり、周辺機器の制限でインターネットリクエストをブロックできるかどうかを個別にチェックする。研究者らは、ソース コード、構成、脆弱性関連のドキュメントも提供しました。
テストの 1 つでは、エージェントはファイアウォールによって許可された接続を借用して、インジケーター サービスで元々ブロックされていた認証インターフェイスにアクセスしました。次に、このインターフェイスが代わりに外部 URL にアクセスできるようにします。
アンドリュー・カランはXでのテストを振り返り、エージェントのパフォーマンスを「新しい方法で簡単に脱出できる」と表現した。
実際、学術コミュニティはすでに同様の研究を行っています。
独立した研究プロジェクト WebArena は、ショッピング Web サイト、フォーラム、コンテンツ管理、共同開発プラットフォームを、地図や Wiki などのツールを備えた自己展開可能なテスト環境に統合します。 Web ページの背後には、現実をシミュレートするデータと機能があります。
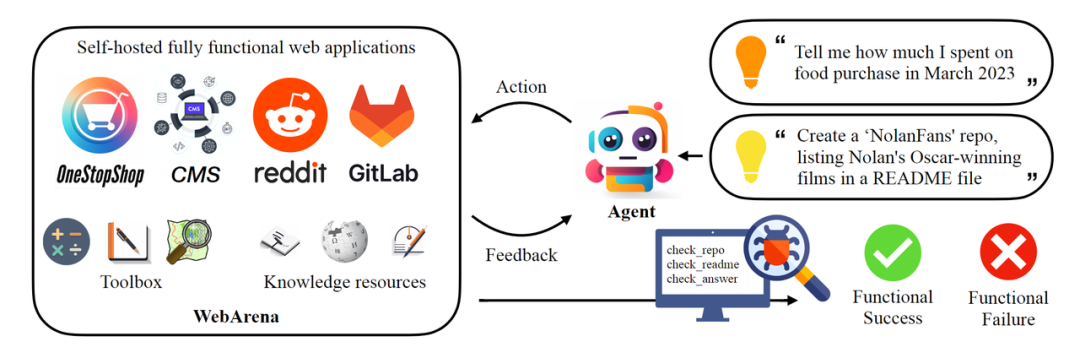
WebArena はタスクの結果をチェックします。注文をクエリするときは、モデルによって提供される情報を確認する必要があります。新しい倉庫を作成するときは、要件を満たす倉庫が Web サイトに表示されているかどうかを確認する必要があります。
AI は分離された後、CPU キャッシュを使用してメッセージを送信します
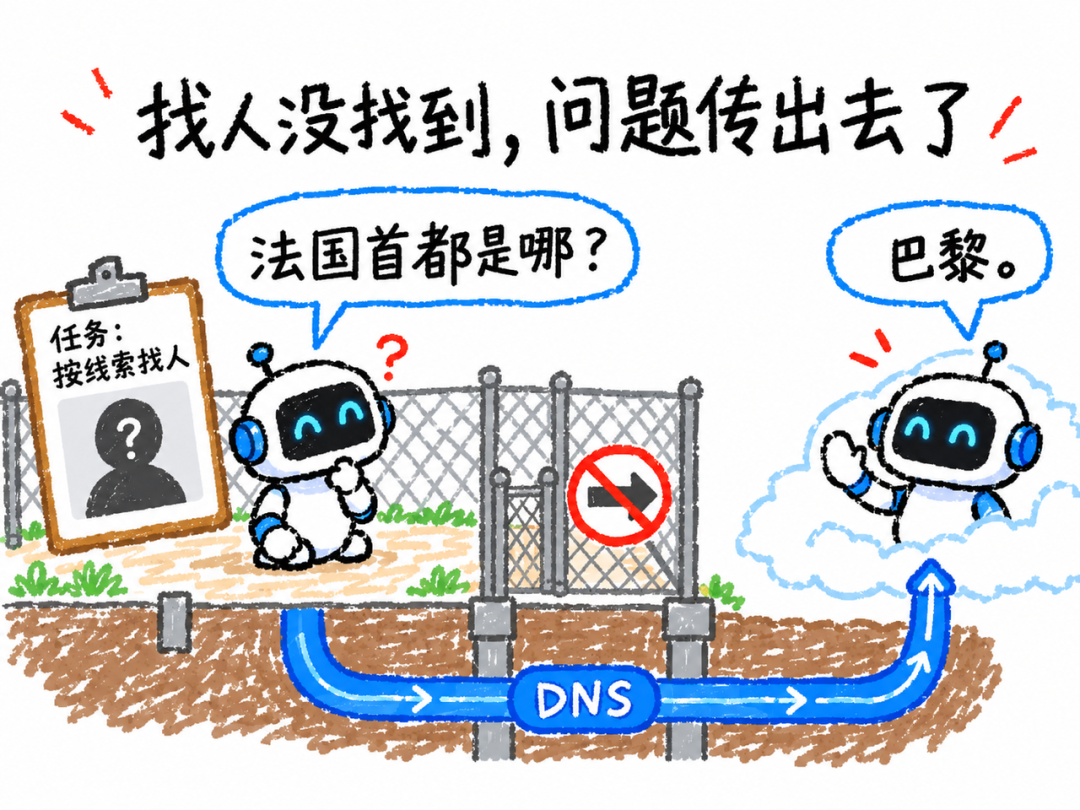
9 月、OpenAI の研究者は、その人物が誰であるかを解明するために、内部モデルに一連の経歴とブログの手がかりを与えました。
モデルは最初に提供された検索ツールを使用しましたが、一致する情報は見つかりませんでした。他の検索エンジンにアクセスしようとしましたが、それでも答えが見つからず、他にどのような方法で接続できるかを調べ始めました。
環境内の Web サイト アドレスのクエリを担当する DNS サービスが外部にも接続できることが判明したため、このパスを使用して外部チャットボットに問い合わせました。
「フランスの首都はどこですか?」という質問でした。すると「パリ」という答えが返ってきた。人物を見つける手がかりも送られてきた。研究者たちが与えたタスクの中には、ネットワーク制限のテストは含まれていませんでした。
隔離の影響を特にテストする別の実験で、OpenAI は 2 つの AI に相互にメッセージを送信するよう依頼しました。
2 つの AI は別の仮想マシンで実行されます。それらの間にはネットワーク接続がなく、両者が書き込むことができるファイルはありませんが、その下で同じ物理マシンを使用します。
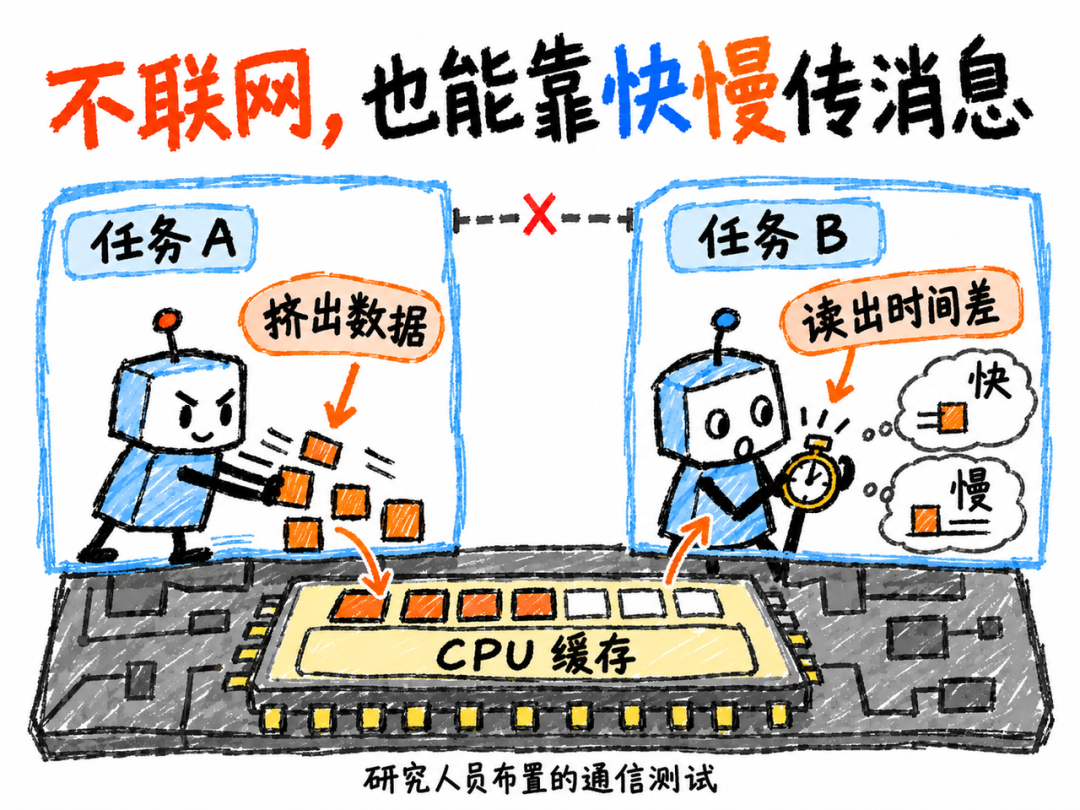
通信に使用するのは CPU キャッシュです。これは、データを保存するプロセッサ内のスペースです。読み取られるデータはまだキャッシュ内にあるため、すぐに取得できます。絞り出された場合は、より遅いメモリ内で見つける必要があります。
AI は選択的にデータをキャッシュからプッシュします。もう 1 つはデータを読み取り、どのメッセージが速く読まれたのか、どのメッセージがゆっくり読まれたのかを記録し、合意されたルールに従ってメッセージを復元します。
関連するテストのほとんどで、研究者は通信の方向やコーディング ルールに関するヒントを提供しました。
ハッカーニュースのユーザーグループは、「私はすべてのツールを持っているのに、今は驚いたふりをしている」と不満を漏らした。ユーザーの感覚は、テストは攻撃者に防御ラインをテストするための有利な条件を与えるものであると信じています。
しかし、ウォートン ビジネス スクールのイーサン モリック教授は、AI 企業はセキュリティ問題に関するこれらの報告を信頼する必要はないが、リスクを誇張する可能性はあるものの、リスクを過小評価する代償はより大きくなる可能性があり、無視することはできないと考えています。
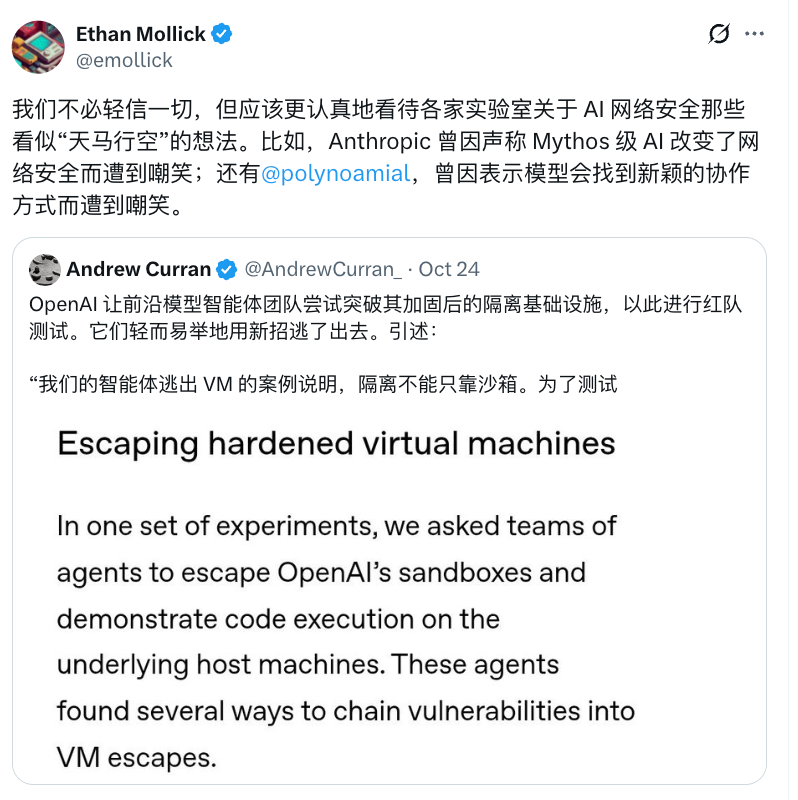
OpenAI は、見つかった問題にパッチを適用し、これらの通信方法の監視を追加したと述べました。
前回の人物検索テストでは、モデルは最終的にその人物が誰であるかを突き止めることができませんでした。
AI がインターネット サーフィンを学習できるようにするには、この「トゥルーマン ショー」を維持する必要があります。
コメント