
要約:
Sony PlayStation 5 はもともとビデオ ゲーム用のコンソールとして設計されましたが、オープンソース開発プロジェクトは、このゲーム デバイスの別の用途、つまりローカル人工知能の大規模言語モデルの実行を見つけようとしています。 PS5 のシステム制限を突破することで、開発者はオープンソースの推論エンジン llama.cpp をコンソールに移植し、さらにその GPU を使用して大規模なモデルを実行しました。最新のデモでは、クラックされた通常の PS5 がすでに 270 億のパラメーターを備えた Qwen 3.8 モデルを実行できることが示されています。低ビット量子化を使用すると、テキスト生成速度は 1 秒あたり約 20 トークンに達します。
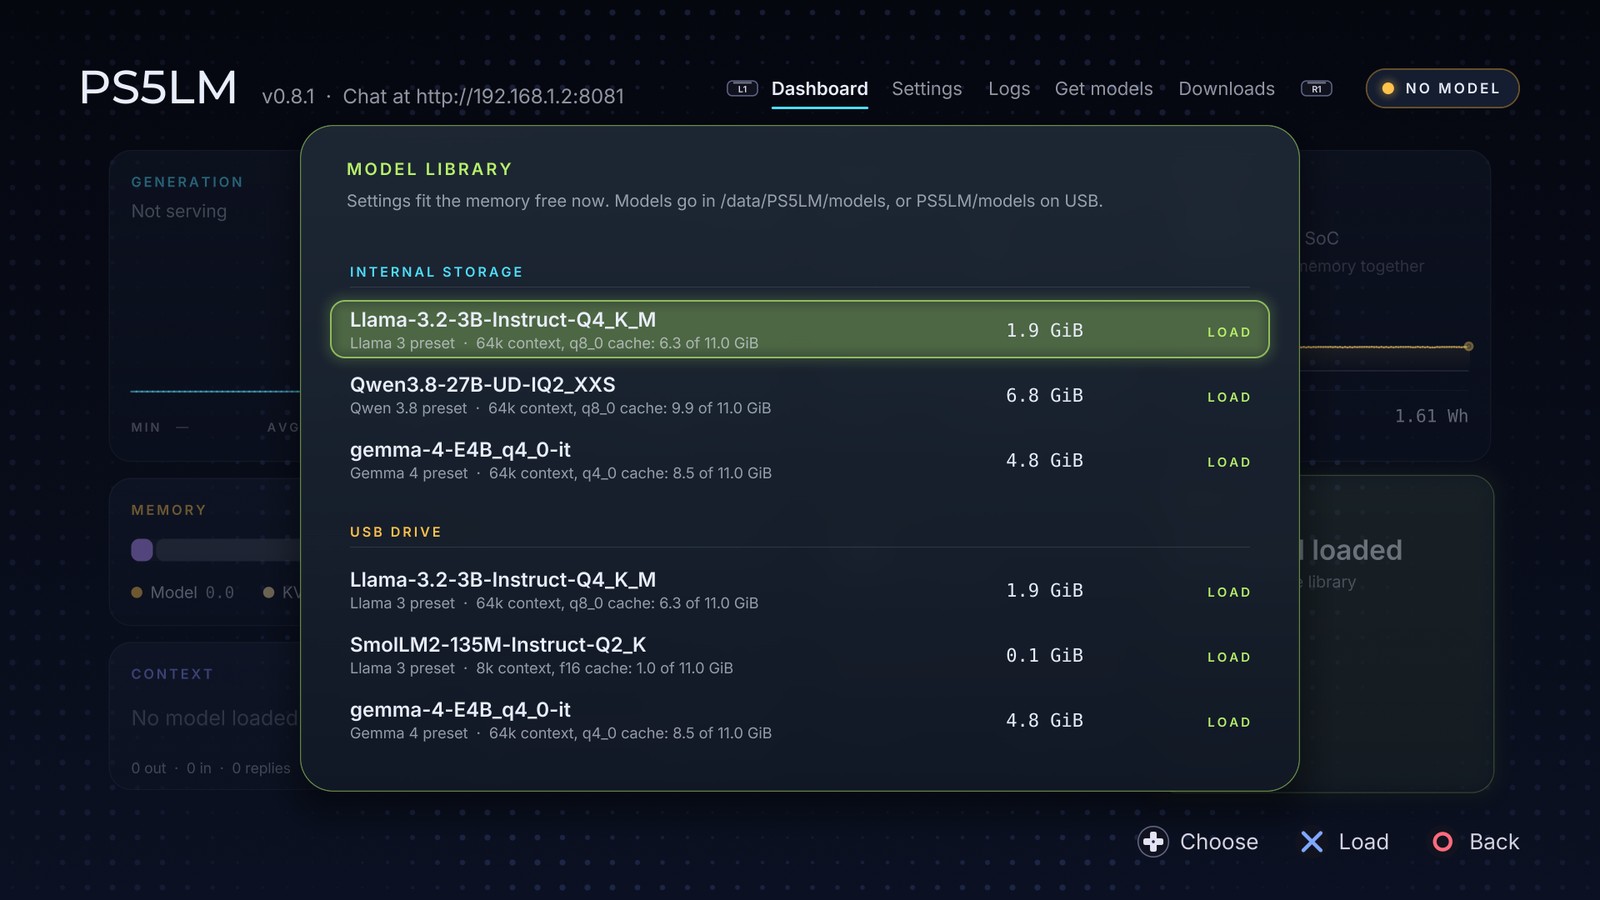
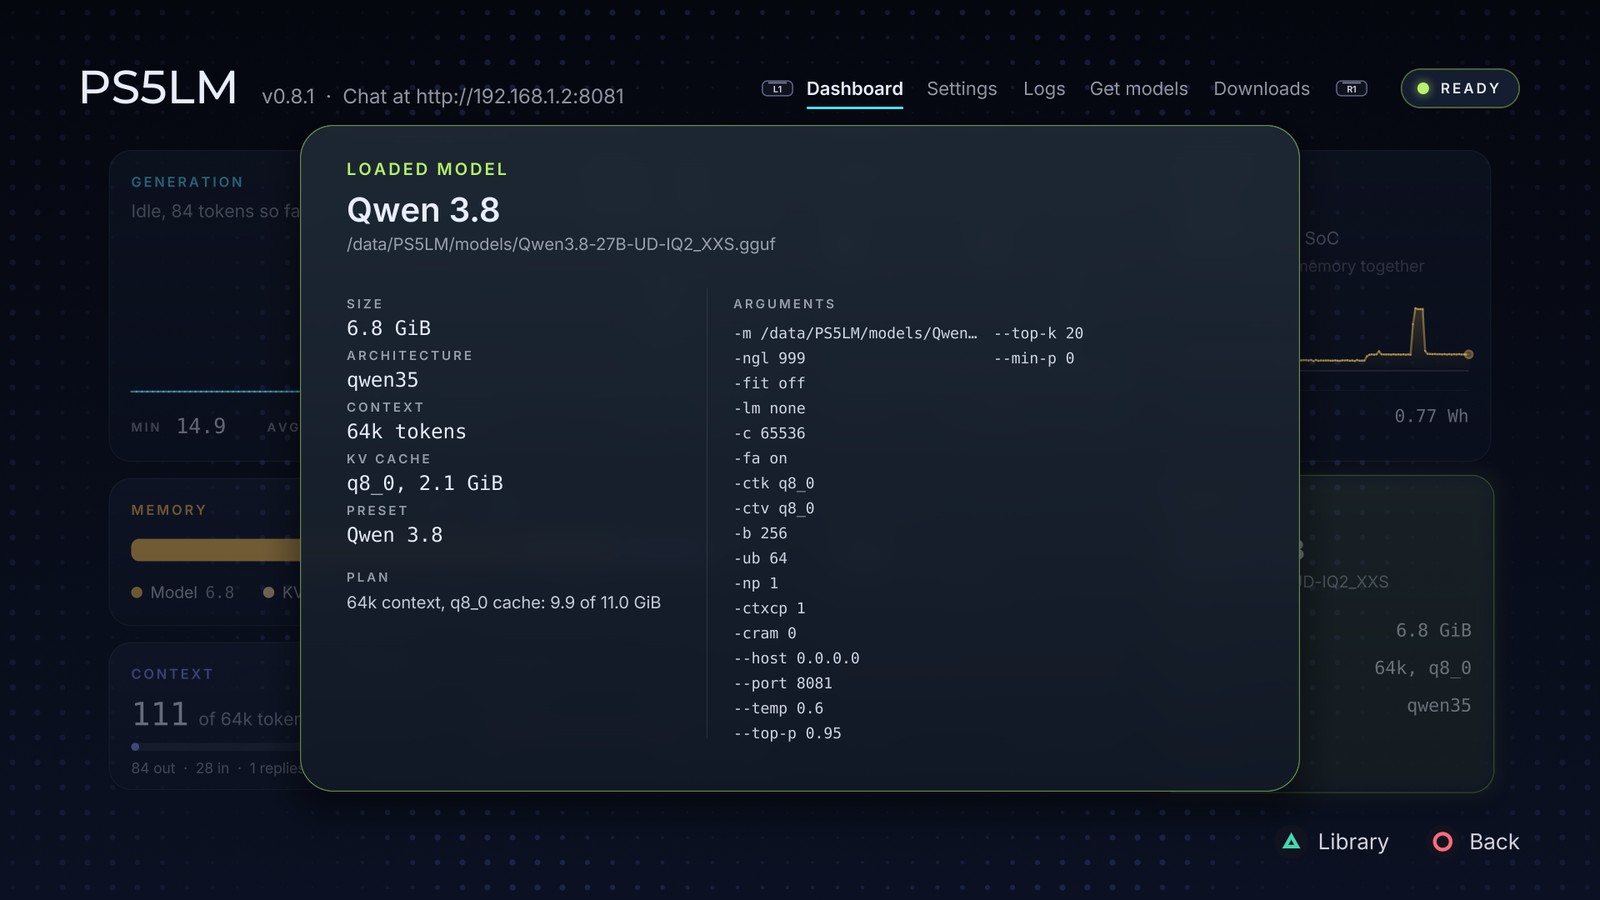
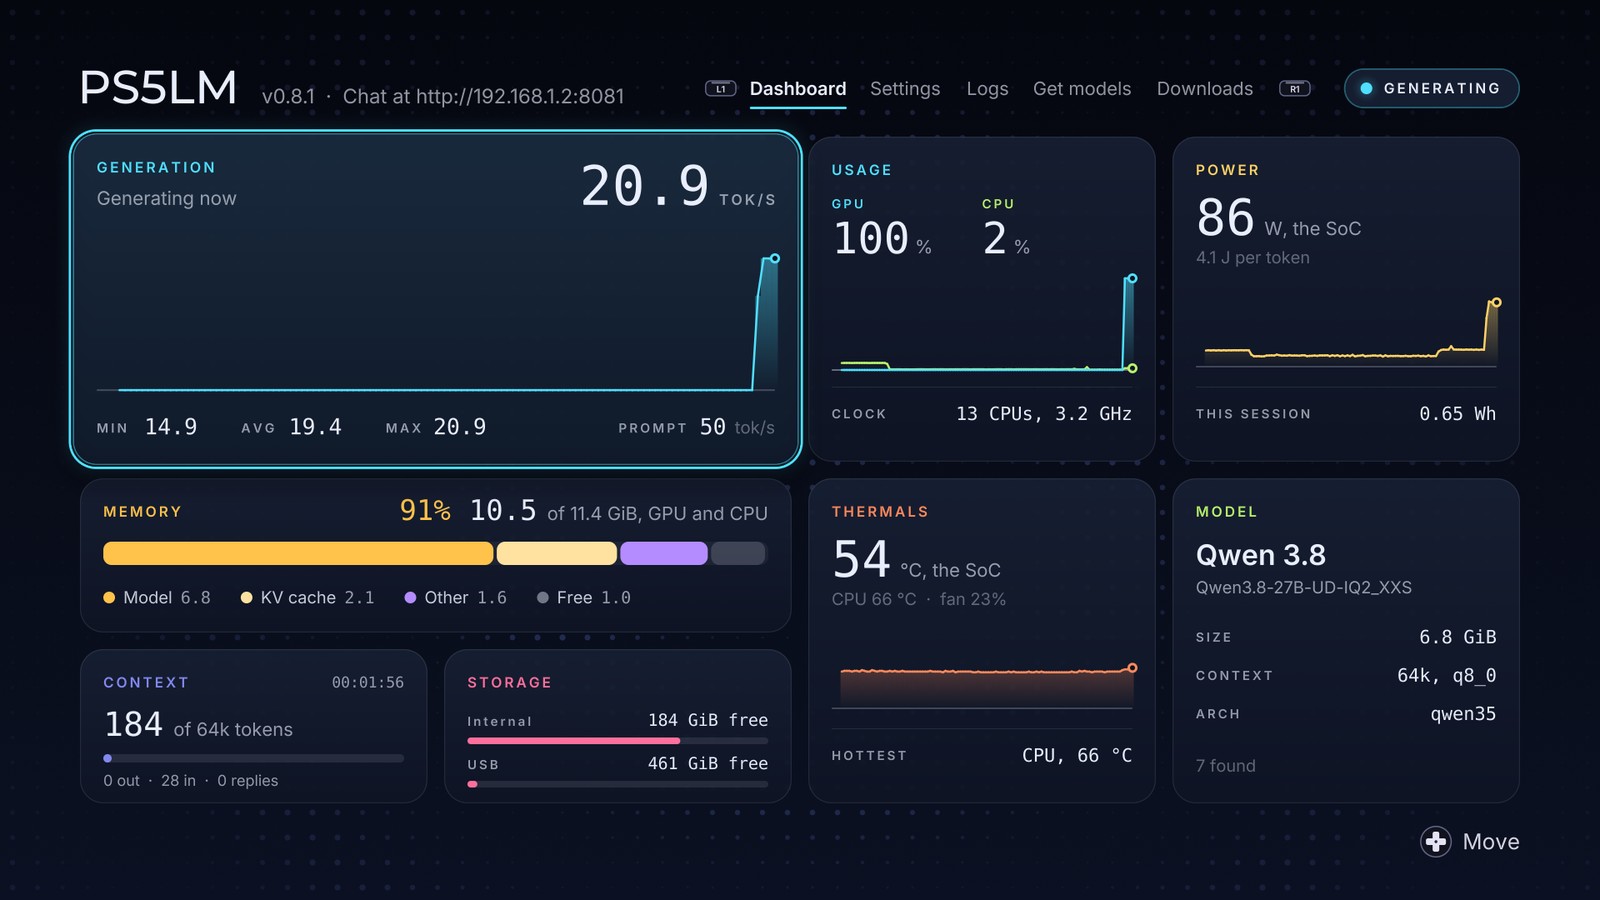
これは、もともとゲームを実行するために使用されていたホストが、クラウド AI サービスに依存せずにローカルの大規模言語モデル サーバーとしても機能できることを意味します。ユーザーは、同じ LAN 内のコンピュータまたは携帯電話を介してホスト上のサービスにアクセスし、モデルと会話できます。ただし、これはソニーが公式に提供する機能ではなく、システムの脆弱性、非公式ソフトウェア、コミュニティ開発の結果に依存する実験的なアプリケーションです。
このプロジェクトは PS5LM と呼ばれ、GitHub 開発者 cobanov によって開始されました。このプロジェクトの核となるアイデアは、新しい人工知能推論フレームワークを最初から書くことではなく、ローカルの大規模モデルを実行するために広く使用されているオープンソース ツール llama.cpp を PS5 プラットフォームに移植し、ホスト オペレーティング システム、メモリ割り当て、GPU コンピューティング インターフェイスの互換性の問題を段階的に解決することです。
PS5 は AMD のカスタム プロセッサを使用しています。 CPU は Zen 2 アーキテクチャを使用し、8 つのコアを備えています。 GPU は AMD RDNA アーキテクチャに基づいています。ホストには 16GB GDDR6 ユニファイド メモリが搭載されており、CPU と GPU はこれらのリソースを共有する必要があります。 PS5 は人工知能推論用に特別に設計されたデバイスではありませんが、その GPU と高帯域幅ビデオ メモリは、ローカル言語モデルを実行するためのハードウェア基盤を提供します。
PS5LM は当初、比較的単純な動作モードを採用し、言語モデルがホスト CPU を通じて推論を実行できるようにし、PS5 独自のブラウザを使用してチャット インターフェイスを提供しました。ユーザーはホスト上にモデルをダウンロードし、DualSense コントローラーとオンスクリーン キーボードを介して質問を入力し、モデルによって生成された回答を表示できます。
この初期のビルドでは、大規模な言語モデルを実行する PS5 の能力が実証されましたが、すぐにパフォーマンスとメモリの制限に遭遇しました。プログラムはペイロードの形式で実行されるため、使用できるメモリはシステム環境によって制限されます。最初は、より小さいモデルのみが安定して実行できます。プロジェクト文書によると、初期バージョンは主にパラメータ サイズが約 0.8B および 2B のモデルをサポートしており、2B モデルの生成速度は 1 秒あたり約 9 トークンです。
PS5 でより大きなモデルを実行したい開発者にとって、単にプログラムを CPU 上で実行させるだけでは十分ではありません。ホストのハードウェア パフォーマンスを最大限に活用するには、推論エンジンが GPU を呼び出し、モデル パラメーター、キャッシュ、その他の実行データを保存するのに十分なメモリ領域を取得できる必要があります。
本当の進歩は GPU アクセラレーションによってもたらされます。開発者はさらに、PS5 にネイティブ アプリケーション実行環境を実装し、コミュニティによって開発されたグラフィックス ドライバーと Vulkan コンピューティング インターフェイスを通じて、llama.cpp がホスト GPU を呼び出してニューラル ネットワーク計算を実行できます。 CPU のみに依存していた以前のソリューションと比較して、この変更により推論速度が向上するだけでなく、プログラムがより大きなモデルを実行するために利用可能なメモリをより多く取得できるようになります。
最新のデモンストレーションでは、PS5 は Alibaba Tongyi Qianwen チームが発売した Qwen 3.8 27B モデルの実行に成功しました。このモデルには 270 億のパラメータがあり、ハイブリッド アテンション アーキテクチャを使用しています。設計の目標は、比較的限られたハードウェア リソースで強力な言語理解、推論、およびコード生成機能を提供することです。
ただし、PS5 は 270 億個のパラメータを完全な精度でメモリに直接ロードするわけではありません。モデルをホストのハードウェア条件に適合させるために、開発者は低ビット量子化テクノロジを使用して、モデル パラメータをより小さな記憶領域に圧縮しました。デモでは IQ2_XXS などの量子化バージョンを使用し、モデル ファイルは数 GB ~ 7 GB 程度で、具体的なサイズは量子化方式によって異なります。
定量化は、大規模なローカル モデルを実行する際の重要なテクノロジーです。通常、モデル パラメーターは高精度のデータ形式を使用して保存されますが、これは大量のメモリを消費します。パラメータをより低いビット幅値に圧縮することで、メモリ要件を大幅に削減し、推論中のデータ転送量を削減できます。その代償として、一部の正確な情報が失われ、モデルの回答品質、推論能力、または特定のタスクのパフォーマンスに影響を与える可能性があります。したがって、270 億のパラメーター モデルを実行できることは、PS5 が同じサイズのモデルを完全な精度で実行できることを意味するものではありません。
開発者が公開したテスト データによると、GPU を使用して推論を実行すると、Qwen 3.8 27B のテキスト生成速度が 1 秒あたり約 20 トークンに達する可能性があります。トークンは、大規模な言語モデルがテキストを処理するための基本単位です。厳密には漢字や英語の単語と同等ではありません。したがって、1 秒あたり 20 個のトークンは、1 秒あたり 20 個の漢字を生成すると単純に理解することはできません。それでも、これは、モデルが軌道に乗り出すことを証明するための単なる技術的なデモンストレーションではなく、インタラクティブな会話がある程度の実用性を持つのに十分な速度です。
同じプロジェクトでは、Qwen モデルに加えて、他のモデルのテスト結果も発表されました。 Gemma 4 E4B は 1 秒あたり約 61 トークンを生成しますが、Llama 3.2 3B は 1 秒あたり約 124 トークンに達します。小規模なモデルではパラメーターが少なく、必要な計算とデータ読み取りが少なくなるため、一般に生成速度が速くなります。
これらの結果は、統合テスト プラットフォームによって検証された業界のベンチマークではなく、特定のソフトウェアおよびハードウェア構成の下で開発者によって公開されたテスト結果と見なされるべきです。モデルが異なれば、パラメーターのスケール、定量化方法、コンテキストの長さ、および計算タスクも異なります。その総合的な能力は、1 秒あたりに生成されるトークンの数のみに基づいて判断することはできません。
このプロジェクトは、PS5 を LAN AI サーバーに変える可能性も示しています。ホスト上で OpenAI API 互換のサービス インターフェイスを実行することにより、他のデバイスは同じネットワーク経由でリクエストを送信し、モデルによって生成された回答を取得できます。このように、ユーザーはコンソールを操作するために常にテレビ画面に向かう必要はなく、コンピューターや携帯電話を介して PS5 上のローカル モデルに電話することもできます。
このアプローチは、ホーム ネットワークにローカル AI サービスを展開したいユーザーにとって魅力的です。モデルがローカルで実行されている場合、原則として日常会話のコンテンツをサードパーティのクラウド AI サービスに送信する必要はなく、ユーザーは呼び出し回数に応じたクラウド推論料金を支払う必要がありません。ただし、実際のプライバシー保護は、インストールされているソフトウェア、ネットワーク構成、およびデバイスが他のデータ送信動作を行うかどうかによって異なります。システムは「ローカルで実行する」だけでは絶対に安全であるとは言えません。
同時に、PS5LM の開発は依然として一連の非公式テクノロジーに依存しています。ユーザーは、関連するクラッキング プログラムを実行し、互換性のあるシステム ファームウェアとペイロード ロード ツールを使用できる PS5 を持っている必要があります。プロジェクト ドキュメントに記載されている適用可能なファームウェアの範囲は 7.00 ~ 13.60 ですが、特定の機能、パフォーマンス、互換性はホスト モデルやソフトウェア バージョンによって異なる場合があります。
コンソールをクラックしても、すべての PS5 ユーザーがプログラムを直接インストールできるわけではありません。 PS5の通常の製品版は、通常のゲームのようにPlayStation StoreからPS5LMをダウンロードして実行することはできません。ユーザーはまず、システムのアクセス許可、非公式プログラムのロード、動作環境などの問題を解決する必要がありますが、ホストクラッキングやソフトウェア開発に慣れていないユーザーにとっては、依然として一定の敷居が高くなります。
さらに、ホスト システムを変更すると、セキュリティと安定性のリスクがもたらされる可能性があり、オンライン サービスの使用にも影響を及ぼし、ソニーの関連サービス利用規約に関わる可能性があります。開発者は、自分が所有するデバイスまたは許可したデバイスでのみ調査を行うことをお勧めします。主に通常のゲームに使用するコンソール ユーザー、特に PlayStation Network に頻繁に接続するユーザーにとって、ローカル AI を実行するためだけにデバイスを性急にハッキングする必要はありません。
ハードウェアの観点から見ると、この実験の重要性は、ゲーム コンソールが質問に答えられるようにすることだけではありません。さらに、消費者レベルのゲーム機器に搭載されている GPU と高速ビデオ メモリも、ソフトウェアを適切に適応させた後、専用の AI コンピューティング機器によって通常完了される作業の一部を引き受けることができることを示しています。
大規模な言語モデルの推論は、多くの場合、メモリ容量と帯域幅に大きく影響されます。モデルがテキストを生成するときは、大量のパラメーターを継続的に読み取り、コンテキスト依存のキャッシュを維持する必要があります。 PS5 のユニファイド メモリ アーキテクチャにより、CPU と GPU は高速メモリ リソースを共有できますが、システム自体もその一部を占有する必要があるため、モデルに利用できるスペースは公称容量の 16GB よりもはるかに少なくなります。
これが、開発者が量子化、メモリ管理、GPU コンピューティング インターフェイスなどの問題を同時に解決する必要がある理由です。十分に強力な GPU を備えているだけでは、モデルがスムーズに実行されるとは限りません。モデル アーキテクチャがサポートされているかどうか、ドライバーが必要な計算操作を実行できるかどうか、システムが推論プログラムに十分なメモリを提供できるかどうかが、すべて最終結果に影響します。
この結果は、ローカル AI ハードウェアの選択に関する興味深い参考情報も提供します。従来、より大規模な言語モデルを自宅で実行したいユーザーは、ディスクリート グラフィック カードを搭載したコンピュータを購入し、メモリ容量とマシン全体のコストに追加料金を支払う必要があることがよくありました。 PS5にはすでに比較的強力なGPUと高速メモリが搭載されているため、開発者らは専用のAIワークステーションを購入しなくても既存のゲームハードウェアを再利用できることを証明したいと考えている。
しかし、これは PS5 が AI コンピューターを完全に置き換えることができるという意味ではありません。そのハードウェア リソースは、固定構成、システム フットプリント、非公式ソフトウェア環境によって依然として制限されています。大容量のグラフィックス メモリ、成熟したドライバ、豊富な開発ツールを備えたコンピュータと比較して、PS5 は大規模なモデルを実行するためにより多くの基礎的な適応作業が必要であり、ユーザーは通常の AI コンピュータのようにグラフィックス カードを自由にアップグレードしたり、グラフィックス メモリを拡張したりすることができません。
実用的な観点から見ると、このタイプのプロジェクトは現在、テクノロジー愛好家、オープンソース開発者、ローカル AI に興味のあるユーザーがモデル推論、GPU コンピューティング、組み込みオペレーティング環境を研究するのに適しています。実稼働レベルの AI サービスを安定して実行する必要がある企業には、専用の GPU サーバーまたは成熟したソフトウェア スタックによって最適化されたコンピューターの方がさらに適しています。
PS5LM の開発は、オープンソース AI エコシステムのトレンドも反映しています。モデル推論フレームワークとオープンウェイト モデルにより、人工知能を実行するための敷居が徐々に下がってきましたが、コミュニティの開発者はこれらのツールをさまざまなハードウェア プラットフォームに移植しようと試み続けています。以前は、ゲーム コンソールは主にクローズドなエンターテイメント デバイスとして見なされていました。現在では、クラッキングおよびリバース エンジニアリング コミュニティの努力のおかげで、GPU コンピューティングやネイティブ人工知能アプリケーションを探索するためのプラットフォームにもなっています。
一般に、これは、クラックされた PS5 で 270 億個のパラメータを持つ大規模な言語モデルを 1 秒あたり約 20 トークンの速度で実行させるという代表的な技術的試みです。これは、ゲーム コンソール ハードウェアの潜在的な使用法を示し、また、ソフトウェアの適応とモデル圧縮を通じて、一定規模の言語モデルを非従来型 AI デバイス上で実行できることも証明します。ただし、この成果は依然としてクラック環境に依存したコミュニティプロジェクトであり、一般ユーザーが複雑な操作なしで利用できる公式機能とはまだかなりの距離がある。
コメント