
要約:
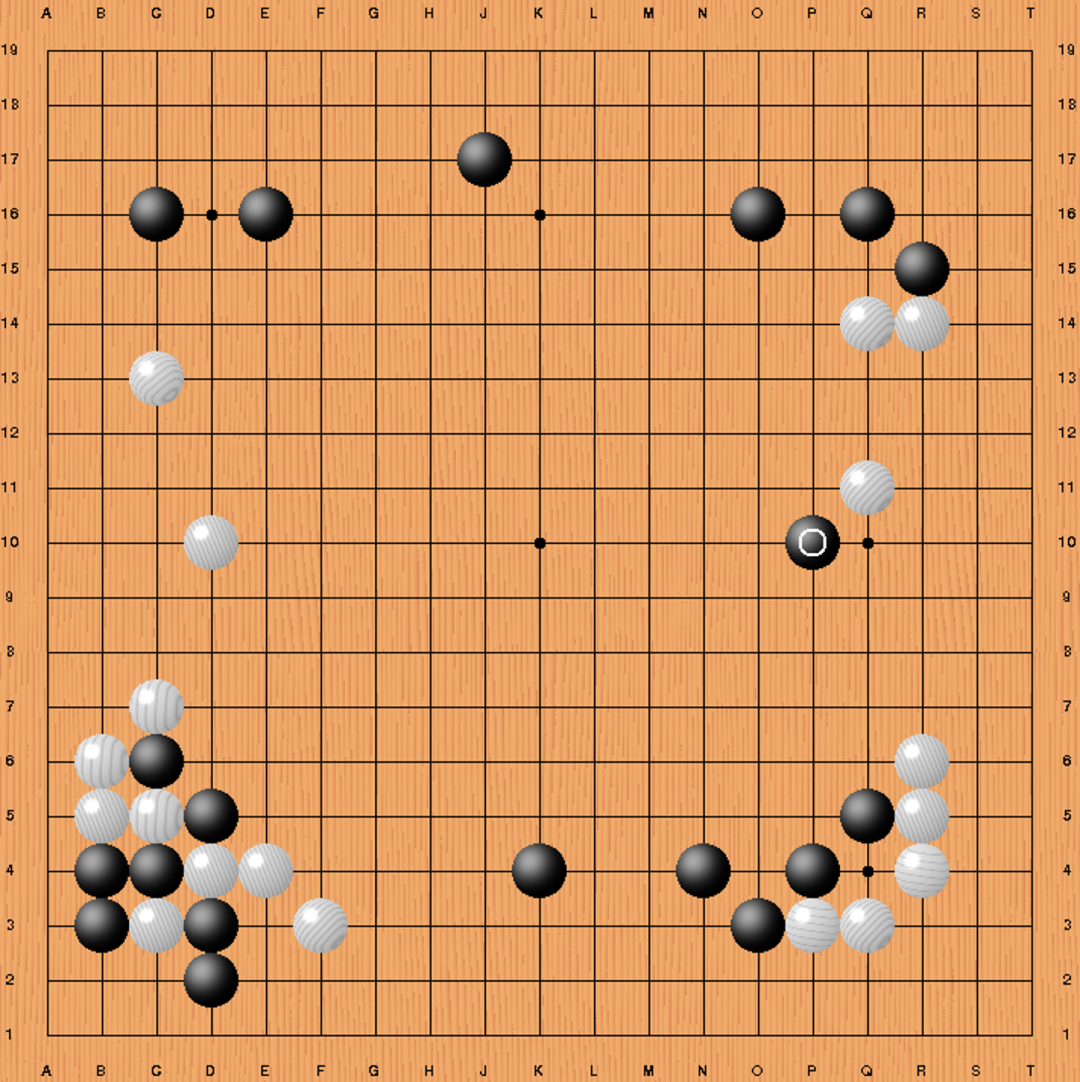
2016 年 3 月、フォーシーズンズ ホテル ソウル。人間対マシンの戦いの第 2 ゲームの途中で、AlphaGo は 5 番目のラインに黒点を落としました。現場の解説者も絶句し、プロ棋士の常識ではフリースローに近い手だったため、プログラムのバグを疑う人もいた。
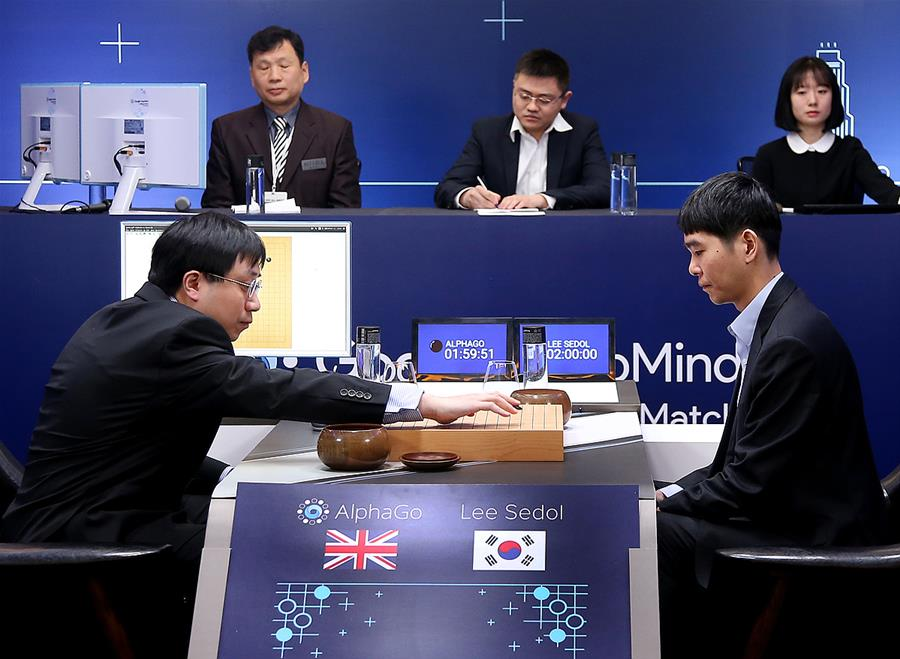
その後のストーリーは誰もが知っています。 AlphaGoはその試合に勝っただけでなく、合計スコア4対1でイ・セドルを破った。対局後、イ・セドルはよく引用される言葉を述べました。「当初、AlphaGo は確率計算に基づいた単なる機械だと思っていました。しかし、あの手を見て考えが変わりました。AlphaGo はクリエイティブでなければなりません。」
これが有名な手 37 です。
10 年後、AlphaGo を開発した男は立ち上がり、こう言いました。「今日の AI には、あのチェス ゲームが依存する機能はありません。」
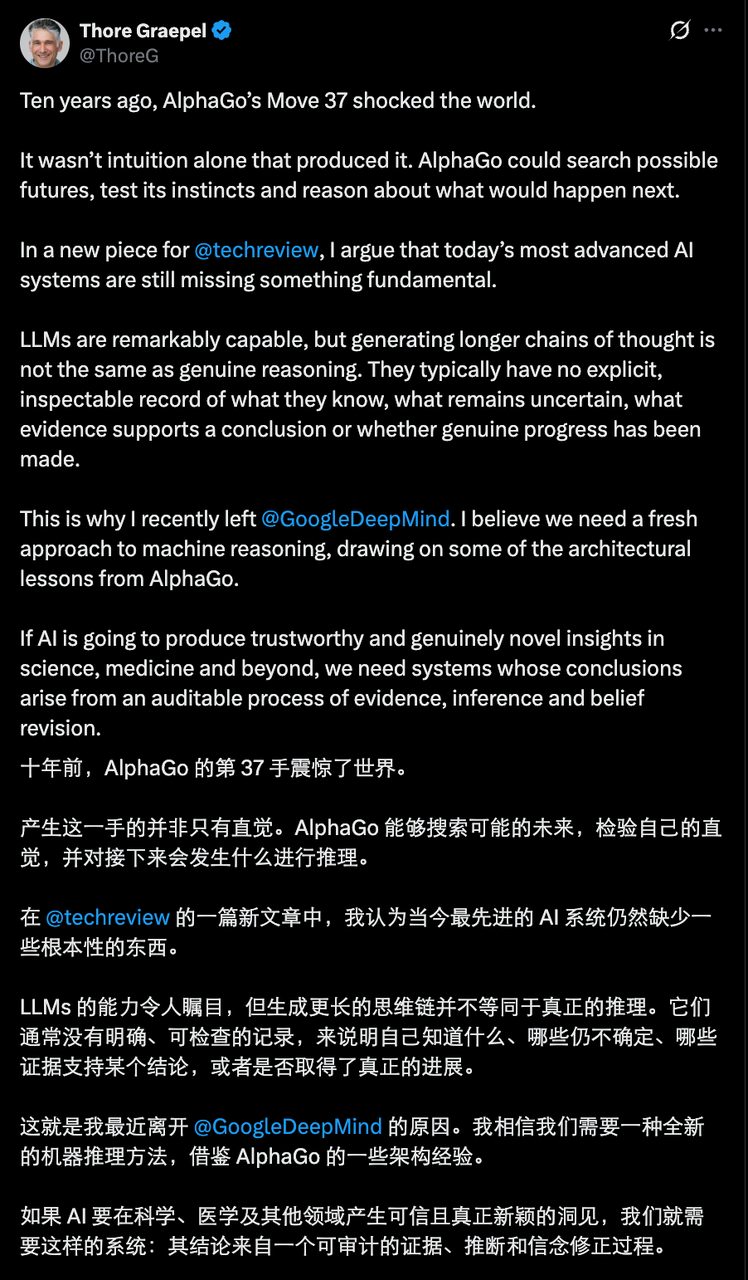
これを言ったのは、AlphaGo の中心的な著者の 1 人であり、機械学習の研究に長年携わってきた Thore Graepel です。最近、彼は興味深い決断を下しました。それは、マシンに真の推論機能を装備するという、より重要だと思うことを行うために、Google DeepMind を辞めてビジネスを始めるというものでした。
この痛切な指摘は、彼が最近 MIT Technology Review に掲載した記事から来ています。記事のタイトルは非常に単純で、「騙されるな - LLM は推論できない」というものです。この記事を読んだチューリング賞受賞者のヤン・ルカン氏は感謝の意を表し、「本当の推論には検索が必要だが、LLM にはその能力がない」と強調した。
なぜトール・グライペルはそんなことを言ったのでしょうか?この記事に書かれている内容を見てみましょう。
第 37 手は「ひらめき」ではありませんでした。
それは推論の産物です
多くの人が 37 番目の手を「機械の直感による神話的な瞬間」と表現します。稲妻の閃光の中で、AI は人類のチェスの千年の歴史を超える見事な手を打ちました。グレーペル氏は、これがAlphaGoに関する最大の誤解であると述べた。
これを理解するには、まず AlphaGo の内部構造を分解する必要があります。これは 2 つのシステムで構成されています。1 つはポリシー ネットワークで、人間の膨大なチェスの記録から学習して「マスターがこの状況でどのようにプレイするか」を予測します。これは直感的な部分です。もう 1 つは検索メカニズムで、特定のチェスの手が「人間によって指されたように見える」かどうかは気にしませんが、各候補の局面が導く未来を推測するために数千の分岐を含むゲーム ツリーを明示的に構築します。
重要な点は、戦略ネットワークの観点からは、37 の手目は目立たないということです。人間のプロのチェス プレイヤーがこの手を打つ確率は、わずか 10,000 分の 1 程度です。自分の直感だけに耳を傾けるなら、この手は決して選ばれないでしょう。この「信じられない」行動がより良い結末につながることを、綿密な計算の末に発見したのは検索メカニズムでした。
Graepel は、カーネマンの有名なフレームワークを借用してこれを説明しています。人間の思考は 2 つのモードに分けられます。システム 1 は高速、直感的、そして楽です。システム 2 はゆっくりと段階的に行われ、慎重に評価されます。 AlphaGo は、マシン上でこれら 2 つのモードを組み合わせた珍しい組み合わせです。ニューラル ネットワークは、「この手にはチャンスがある」と「この状況では勝てる」という直感を提供し、検索メカニズムは、将来の攻撃と防御の変更においてこれらの直感をテストする役割を果たします。半分もなければ機能しません。直感だけでは 37 手を打つことはできません。暴力的な探索だけでは囲碁の天文学的な可能性を排除することはできないだろう。
ここには、見落とされがちな別の比較があります。ディープ ブルーは、1 秒あたり 2 億のチェスの局面を評価し、6 ~ 8 歩先を読むために人間によってハードコーディングされたルールに依存して、1997 年にカスパロフを破りました。 Go の複雑さはまったく別のレベルにあります。駒の価値は、数十ラウンド後の勢いとフィールドの成長と衰退によって決まります。たとえすべての変化のうちごく一部しか計算されなかったとしても、スーパーコンピューターはそれを何十億年にもわたって計算する必要があります。したがって、AlphaGoは「一目で状況を明確に見る」ことを学ばなければならず、さらには人間が思いつかないような手を生み出すこともできます。重要なコンピューティング能力を粉砕しても勝利は得られません。
大規模な言語モデル:
極限までトレーニングされたシステム 1
今日の AI を見てみましょう。
大規模な言語モデルの動作原理は、次のトークンを何度も予測することです。これは本質的にシステム 1 が動作している状態です。人間がこれまでに書いたほぼすべての分野で、高速かつ連想的で、驚くべきパターン補完が可能ですが、「答える前に考える」部分はありません。
ChatGPT が誕生してから間もなく、業界は言語の流暢さだけでは真の有用性をサポートできないことに気づきました。誰もが解決策をよく知っています。つまり、モデルに答えを急がせないようにし、最初に中間ステップを生成し、問題を分解し、中間結果をもたらす、つまり思考の連鎖です。
思考回路の改善は、特に数学とコーディングにおいて顕著です。しかし、グレーペル氏は、興奮によって簡単に曖昧になってしまう事実を指摘しました。これらの中間的な推論ステップは依然として「次のトークンを予測する」プロセスと同じであり、最終的な答えを与える前に少し長く反復されるだけです。 AlphaGo の検索のような真に独立した推論メカニズムは導入されていません。直感は鍛えられますが、それが賢明になるわけではありません。
彼はさらに、チャットボットの動作が「科学者によって認識されている種類の推論」に達していない理由を説明するために 3 つの欠点を挙げました。
第一に、モデルには、明確で継続的に更新され、検査可能な認知状態がありません。現時点でどのような仮説を検討しているのか、さまざまな説明にどの程度の信頼を置いているのか、どのような証拠を検討しているのか、そしてどのような疑問が未解決のままなのか。これらは、新しい情報が入ってくるたびに体系的に改訂される必要がありますが、モデル内にはそのような「オープンな台帳」はありません。
第二に、このモデルでは「何を知るか」と「知識の使い方」を分離することができません。知識と推論はニューラル ネットワークの重みに密接に絡み合っており、独立して明示的に表現された信念体系は存在しません。
3 番目の、そして最も微妙な点です。思考連鎖は思慮深い熟慮のように見えますが、研究によると、モデルは多くの場合、事後に作成されることが示されています。答えは一方の道を歩むことで得られますが、報告されるのは別の道です。 「もっともらしい話」と「実際にあった推理」は別物です。
推論が正しいか間違っているか
それはそんなに重要ですか?
ただおしゃべりしているだけなら、その推論が正しいか間違っているかは問題ではないかもしれません。しかし、医学、工学、科学研究など、私たちが本当に関心を持っている一か八かの分野では、システムがどのように到達するかと同じくらい重要なのは、システムが何を到達するかです。診断や治療の誤りなど、何か問題が発生した場合、その誤りがどこにあるのかを正確に特定できる必要があります。推論プロセスに問題があるのか、無効な証拠を受け入れているのか、それとも間違った仮定を立てているのか。事後的に話をでっち上げることしかできないシステムは、そのようなシナリオでは信頼できず、責任を負うこともできません。
まさにこれが、Graepel が DeepMind を去った理由です。彼は、新しい機械推論の道が必要であると信じており、そのインスピレーションは 10 年前の AlphaGo から来ています。
AlphaGo は、現在の状況に関するすべての知識の記録を常に維持しています。これがゲーム ツリーです。ツリーには、考慮されたすべての変更、考えられるすべての将来が含まれており、あらゆる動きとあらゆる状況がニューラル ネットワークの判断によってマークされます。推理が進むにつれてツリーを継続的に更新し、最終的にツリー内の情報に基づいて手を決定します。
Graepel は、同じことが一般的な推論システムにも当てはまると考えています。つまり、何が確認され、何が疑問で、何が除外され、どの疑問が未解決のままであるかを明確に表現する認知状態を維持するということです。そして「推論」とは、この認知状態を変える一連の「行動」であり、結論を導き出し、問題を解体し、そして最も重要なことに、次にどのような質問をするか、どのような計算を行うか、どのような実験を実行するかを決定することです。
もちろん、オープンワールドでの推理はチェスよりもはるかに困難です。碁盤上の状態は完全に可視化されており、ルールは固定されています。現実の世界では、現在の状況は部分的にしか知られておらず、利用可能なアクションは多数かつ複雑で、アクションの結果はランダム性に満ちているか、まったく未知であることさえあります。
しかし、良いニュースは、長年にわたる LLM およびその他のニューラル モデルの進歩が、そのための部分を提供しただけであるということです。LLM は、既知の情報と利用可能なリソースに基づいて問題を解決する道筋を提案できます。 API やコードを通じてツールと対話できます。結論が既存の証拠によって裏付けられているかどうかを評価するのに役立ちます。最も重要なことは、システム内に独立した「審判者」が存在し、「このステップによってどの程度の不確実性が解決されるか」に基づいて各推論の動きを評価し、証拠によって裏付けられた場合にのみ信念を更新する必要があることです。ルールが確立されると、システムは認定された知識を蓄積し、過去の推論経験から学習し、独自の推論戦略を改善できます。
グレーペルはこの絵に、ステロイドに関する科学的手法という生き生きとした表現を与えました。目標はただ 1 つ、精査に耐えられる知識を生み出すことです。
大規模システム 1、
システム 2 は自動的に拡張されません
記事の最後で、彼は自分の態度を明確にしました。信頼できるマシン インテリジェンスは、システム 1 を大きくすることでは実現できません。スケールは直感を研ぎ澄ますが、賢明さは研ぎ澄まされません。
手番 37 が重要である理由は、マシンがポジションを守り、起こり得る将来を比較検討し、マシン自身の「直感」ですらおそらく拒否するであろう手を選択するためです。
人類社会は、創薬、新素材、気候、医療診断の分野で、そのような「神の手」をさらに必要としています。そこのチェス盤は囲碁とはまったく似ていませんでしたし、誰も私たちにルールを渡してくれませんでした。このような洞察は、真に推論するシステムからのみ得られます。つまり、事後的にでっち上げた説得力のあるストーリーからではなく、監査可能な証拠、推論、信念の修正の連鎖から導き出される結論です。
10 年前、AlphaGo はその 37 番目の手を使って、機械は人間の直感を超えることができると世界に伝えました。
10 年後、その作成者の 1 人が私たちにこう言いました。滑らかな言葉に騙されないでください。これまでのところ、LLM にはそのような本当の飛躍は再び起こっていません。
LLM は推論できないと言いましたね。
それは耐えられますか?
この意見記事が公開された後、X に関してかなりの論争を巻き起こしました。
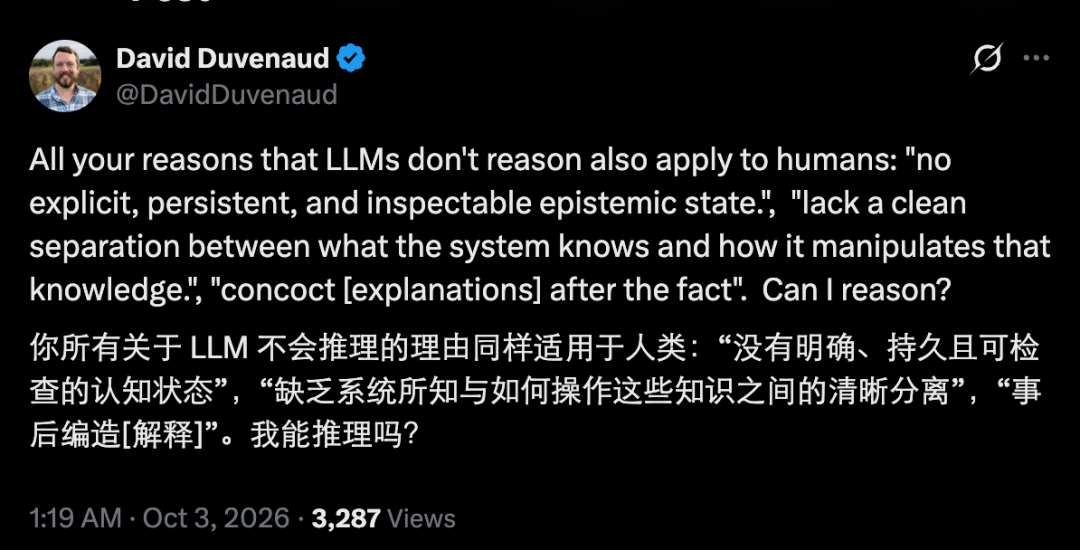
最も厳しい質問は、トロント大学教授の David Duvenaud 氏 (ニューラル ODE に関する NeurIPS の最高の論文の著者の 1 人) からのものでした。同氏は次のように述べた。LLMに対するグレーペル氏の3つの罪状(確認可能な認知状態がないこと、知識と推論の分離がないこと、事後の説明の捏造)は、人間にも等しく正当である。 「この基準によれば、私は推論が得意だと考えられますか?」
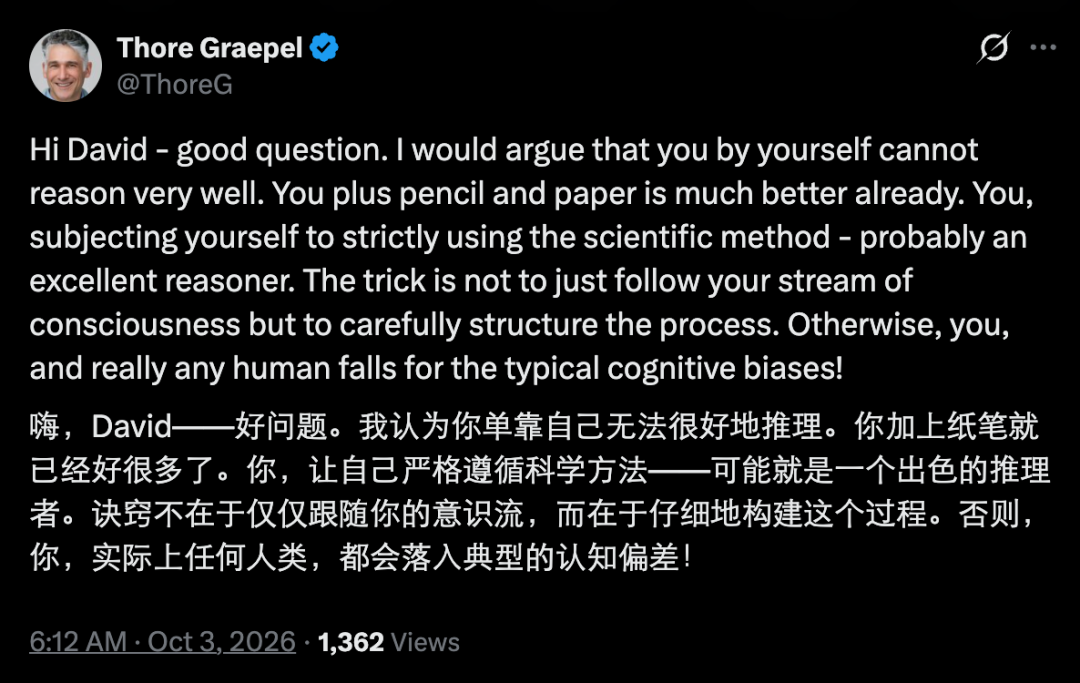
Graepel 氏は次のように答えました。自分だけでは十分に推論することはできません。紙とペンが与えられれば、もっと良いでしょう。そして、科学的手法に厳密に従うように求められれば、あなたは優れた推論者とみなされます。秘訣は決して意識の流れに従うことではなく、プロセスを構造化することです。そうしないと、誰も認知バイアスから逃れることはできません。
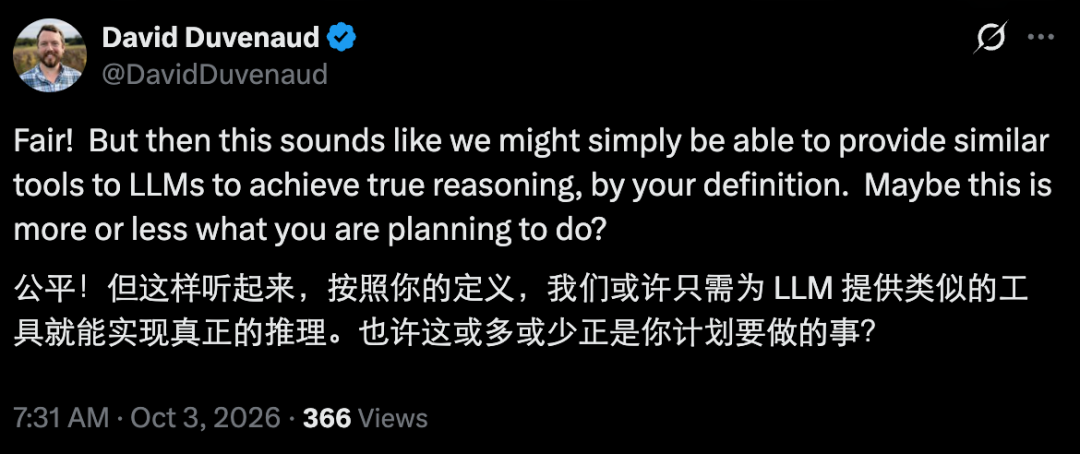
Duvenaud は、この文の意味をすぐに理解しました。「LLM に同様のツールを装備する限り、あなたの定義に従って実際の推論を達成できるように思えますが、これはあなたの意図ではないでしょうか?」
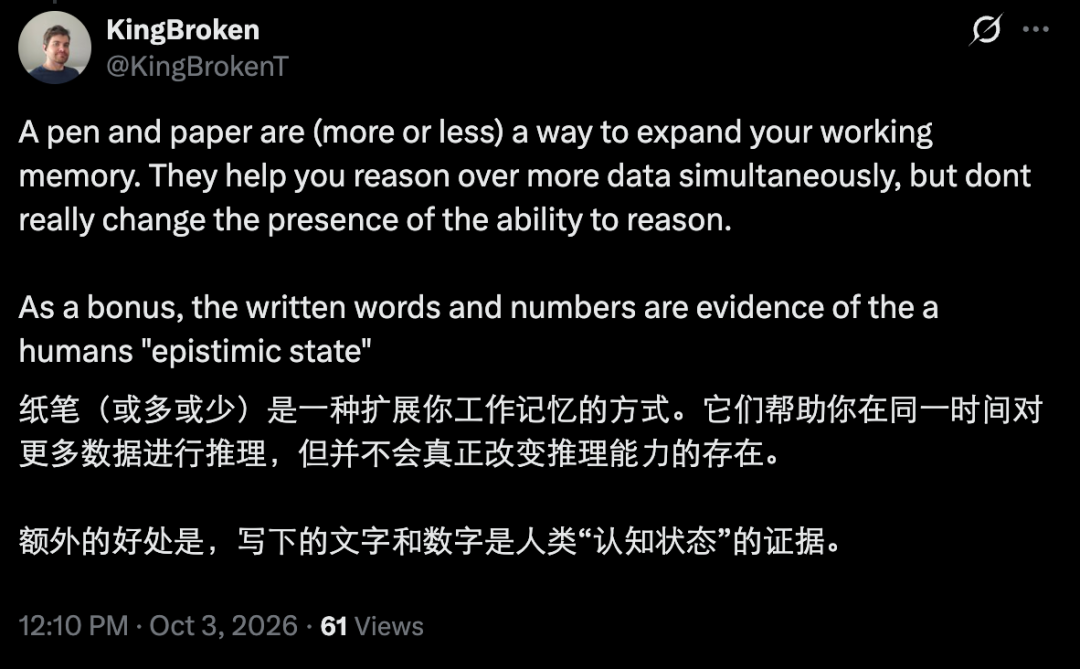
Graepel の「紙と鉛筆による強化理論」も他のネチズンからの疑問を引き起こしました。ネット民のキングブローケン氏は、紙とペンは本質的に作業記憶のプラグインであると指摘した。これにより、同時により多くのデータについて推論できるようになりますが、「何もないところから」推論する能力の存在は変わりません。しかし、これにはさらなる利点もあります。書かれた文字や数字は、偶然にも人間の「認知状態」のチェック可能な証拠となるのです。
その直後、ネチズンのダニエル グラントはより鋭い質問をしました。これによると、人間の推論方法は「既存のモデル + プラグイン システム」と同等であるため、両方よりも強力な内部推論機能を備えたモデルを構築していますか?それとも何かニュアンスが欠けているのでしょうか?
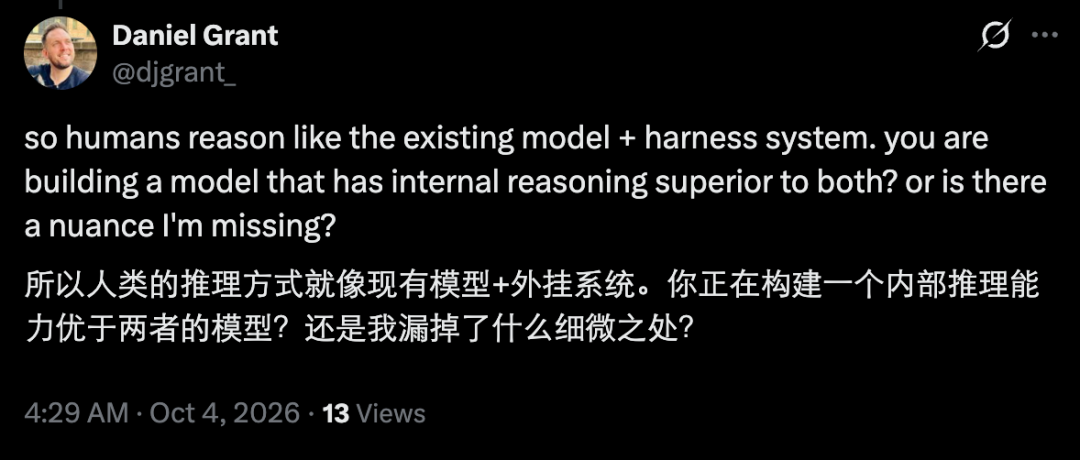
Graepel はこれらの問い合わせにまだ回答していません。
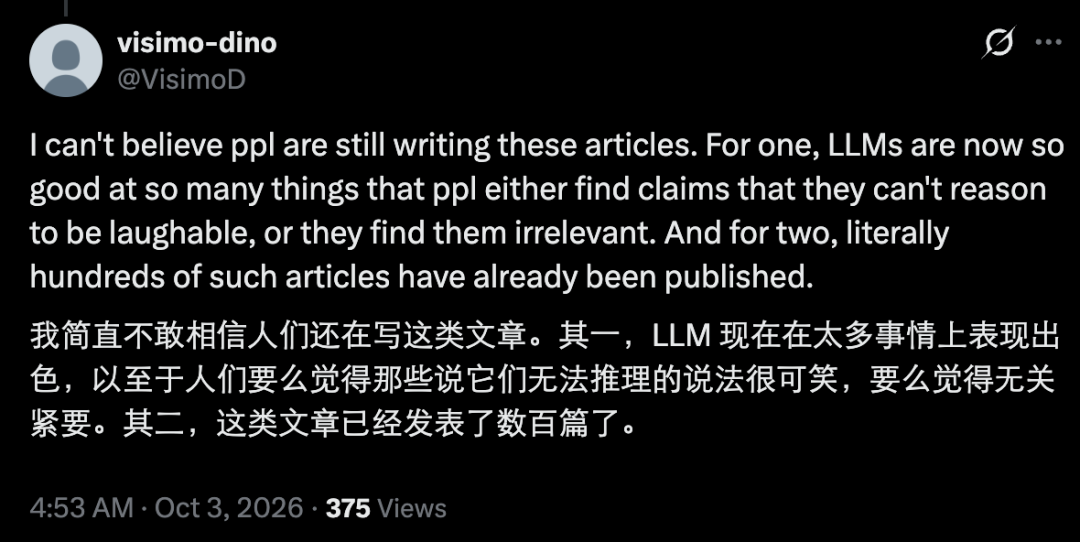
別の声は、この議論は不必要だと感じました。ネチズンのvisimo-dinoは、「まだこの種の記事を書いている人がいるなんて信じられない」と率直に語った。LLMはすでにあまりにも多くの分野で好成績を収めており、「推論できない」という発言はばかばかしいか無関係であり、同様の記事が何百件も公開されている。
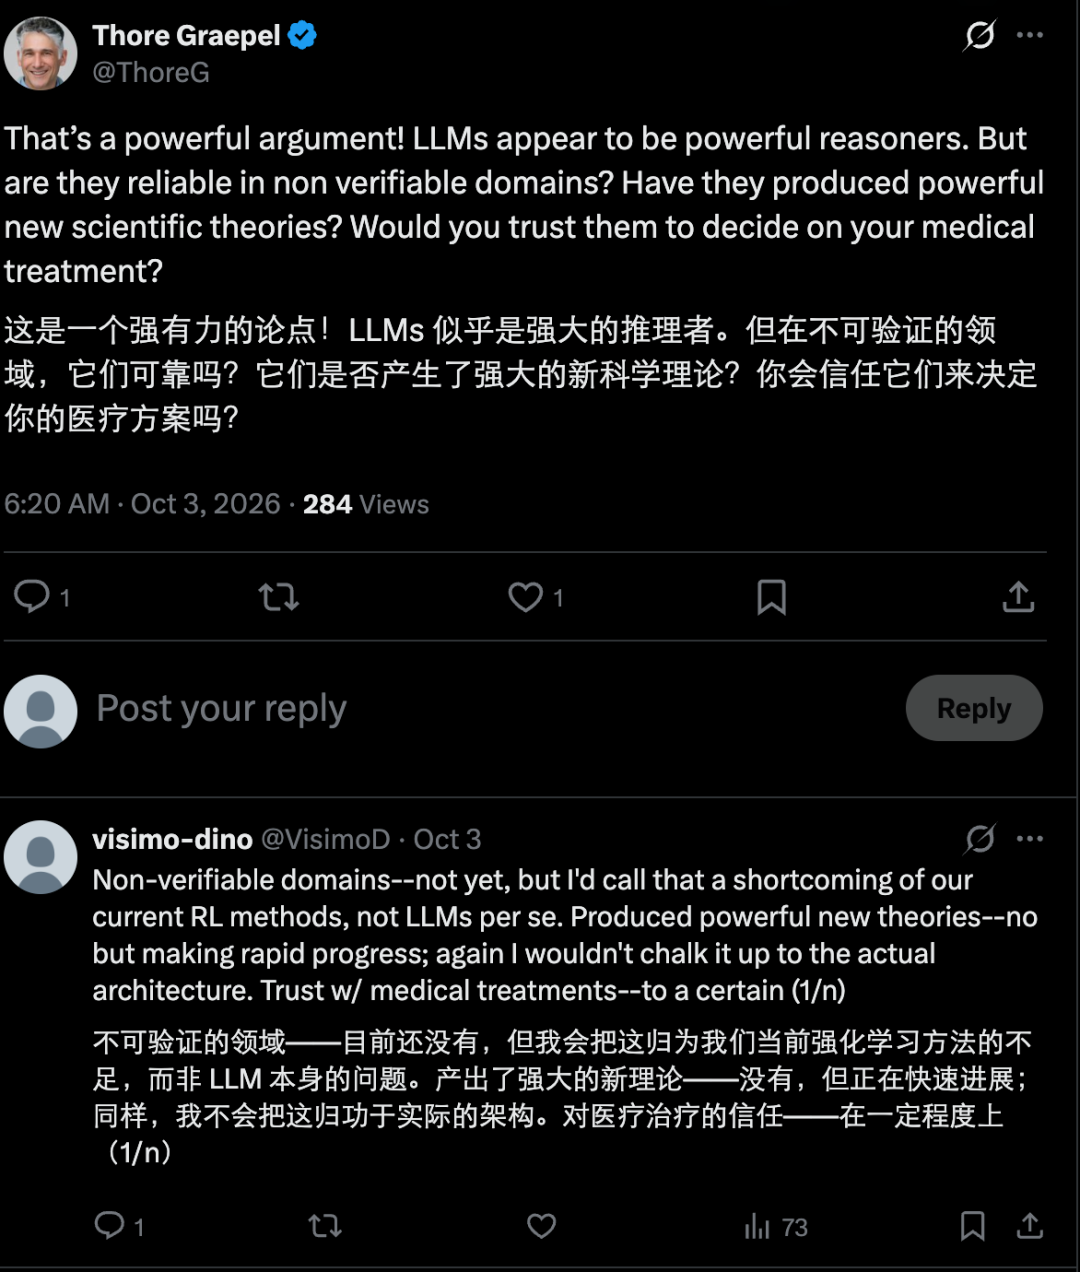
Graepel 氏はこれについては詳しく述べず、次の 3 つの質問を投げ返すだけでした: 検証できない領域でも信頼できるか?それは強力な新しい科学理論を生み出しましたか?それがあなたの治療を決定づける勇気がありますか?相手は率直に「まだ」と認めましたが、LLM アーキテクチャ自体ではなく、既存の強化学習手法を非難しました。これは、時間が経てば解決されるということを意味しています。おそらく、これが 2 つのグループの本当の違いです。一方は、足りないものは時間であると考えており、もう一方は、足りないものは構造であると考えています。
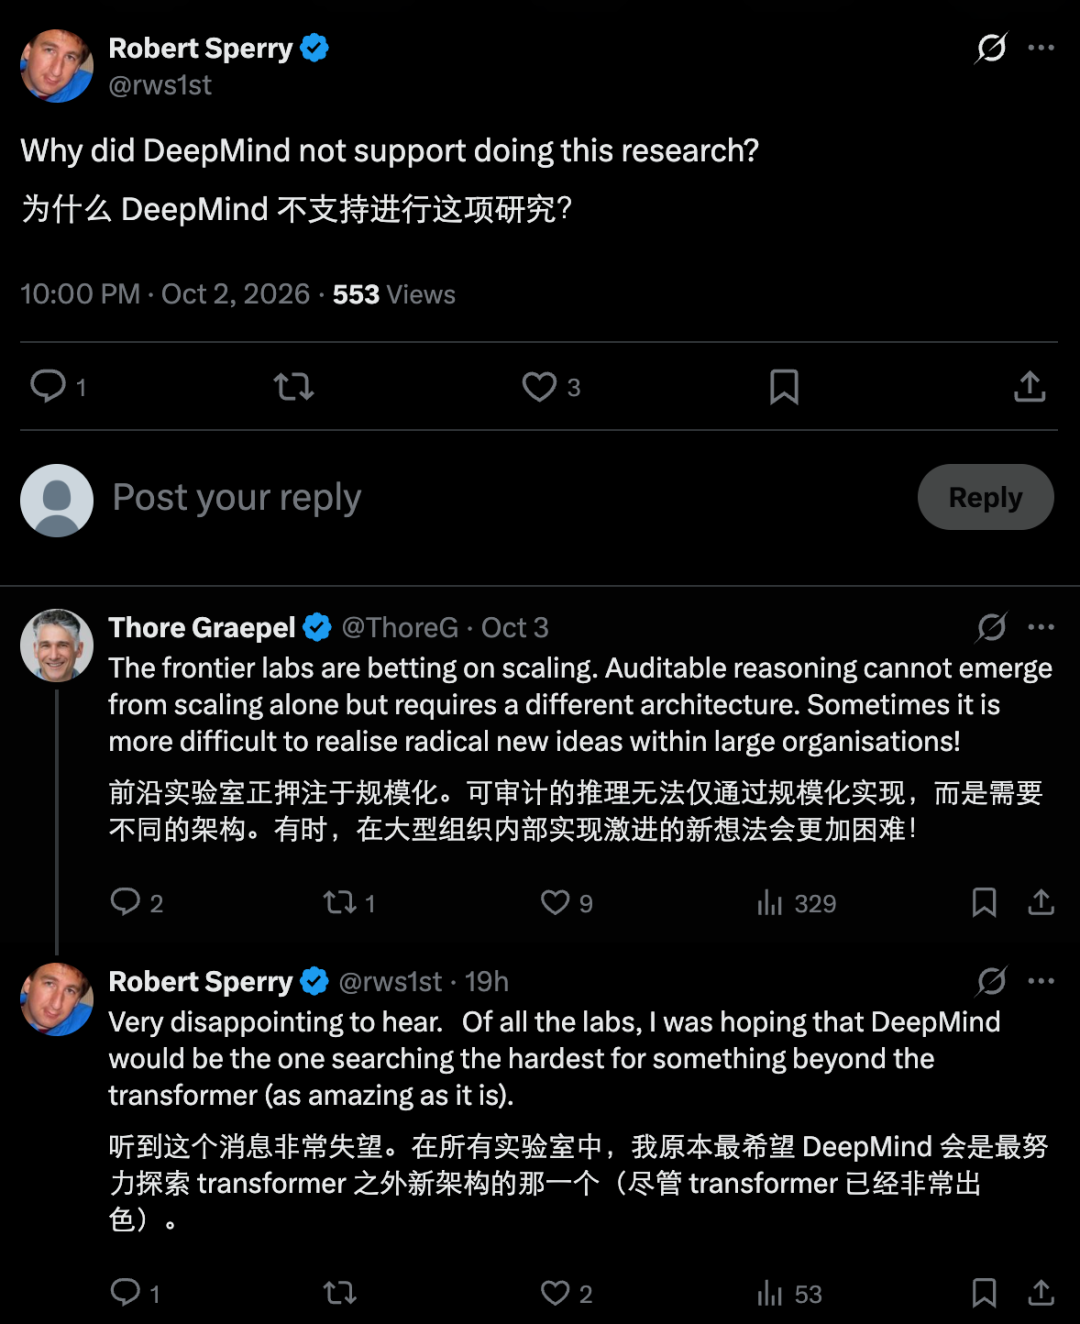
別のコメントでは、多くの人が考えていることを尋ねました。「なぜ DeepMind はこの研究をサポートしないのですか?」 Graepel 氏の答えは単純です。最先端の研究室はスケーリングに賭けており、スケーリングだけでは監査可能な推論は生まれません。別のアーキテクチャが必要です。 「時には、急進的な新しいアイデアは、大規模な組織内で実装することがより困難になることがあります。」質問者ロバート・スペリーの失望は明白でした。彼は、すべての研究室の中で、Transformer を超える答えを見つけるために最も熱心に取り組んでいるのは DeepMind であると期待していました。
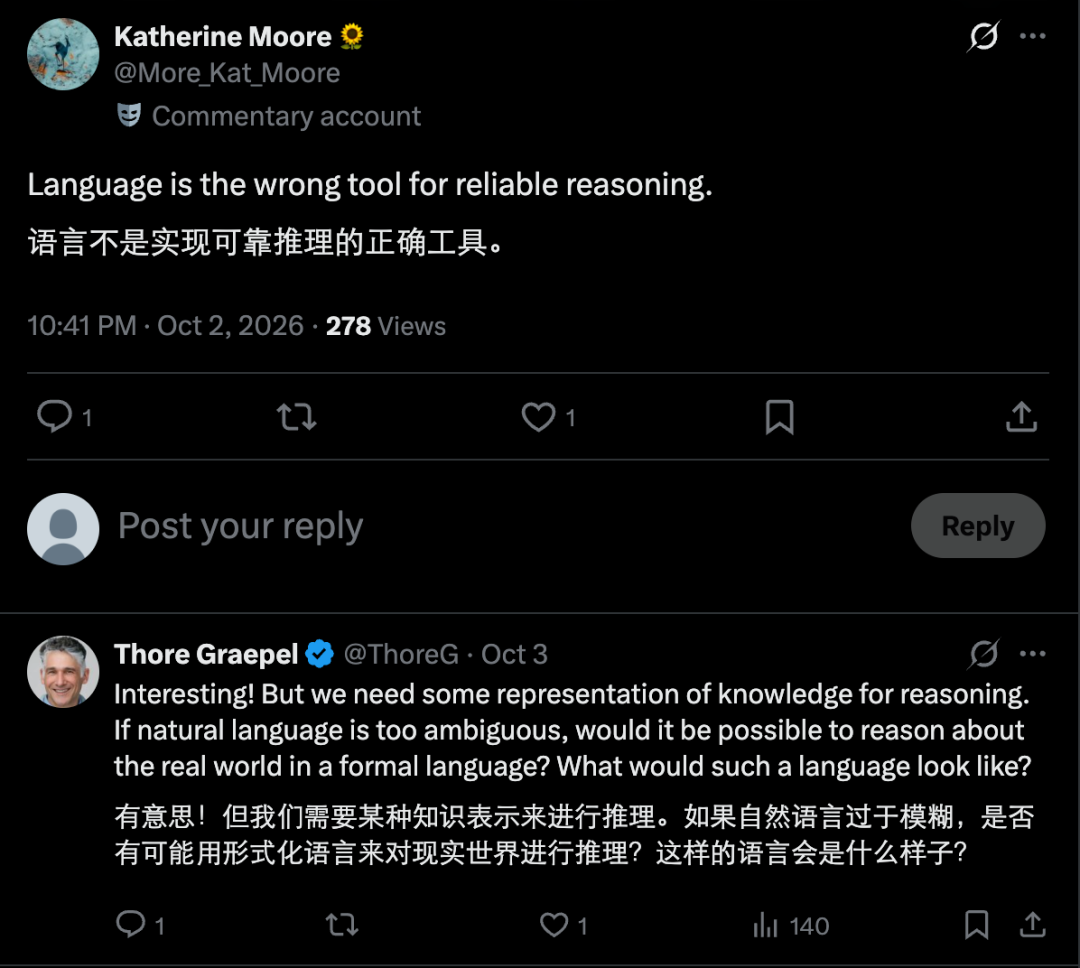
もっと根本的なところを指摘する人もいます。コメンテーターのキャサリン・ムーアは、「言語自体が間違ったツールであり、それを使って信頼できる推論を行うことはできない」という一文だけを残した。グレーペルはこのより急進的な立場を真剣に受け止め、推論にはある種の知識表現が必要であるという未解決の疑問を提起しました。自然言語が曖昧すぎる場合、形式言語を使用して現実世界を推論できるでしょうか?そのような言語はどのようなものになるでしょうか? 。答えはなかったが、起業する際にこの疑問に答える人もいるかもしれない。
コメント