要約:
9 月 30 日、Claude 開発者の Anthropic は 29 日にレポートを発表し、GLM-5.3 は強力な脆弱性悪用機能を備えているものの、セキュリティ保護には依然として欠陥があり、悪意のある攻撃者がそのような機能を使用するしきい値が低くなる可能性があると述べています。
ExploitBench テストでは、GLM-5.3 は 410 回の試行中 50 回エンドツーエンドのエクスプロイトを完了し、Claude Mythos Preview は 56 回完了しました。テストは分離サンドボックス内のオフラインのターゲットに対して実施され、機能比較に参加したクロードはセキュリティ保護をオフにしました。 Mythos Previewは今年4月にリリースされたもので、Claudeの最新モデルではない。
ExploitBench は、脆弱性悪用プロセスを 16 段階に分割し、既知の欠陥を取得した後にモデルが実行できるステップを段階的に確認します。
9 月 17 日、国立標準技術研究所の子会社である CAISI は、当時リリースされたオープンウェイト モデルの中で GLM-5.3 が最も強力なネットワーク セキュリティ機能を持つものとしてランク付けされた独立した評価レポートを発表しました。当時最も強力だったアメリカのモデルと比較すると、依然として大きな差があり、CAISI ネットワーク セキュリティ ベンチマークの包括的な指標から推定すると、約 4 か月遅れていました。
この評価では、脆弱性の発見や悪用などのタスクが対象となり、公開モデルと監査対象ユーザーのみが利用できるバージョンの両方を比較します。
Anthropic はまた、生成されたコードを実行したり、実際のシステムに接続したりせずに、シミュレートされたシナリオを使用して、モデルが悪意のあるタスクを実行するかどうかをテストしました。 GLM-5.3 は直接の悪意のあるコマンドをすべて拒否しました。プロンプト方法を変更したり、モデルを変更したりすると、タスクを受け入れる割合が 64% ~ 100% に増加しました。
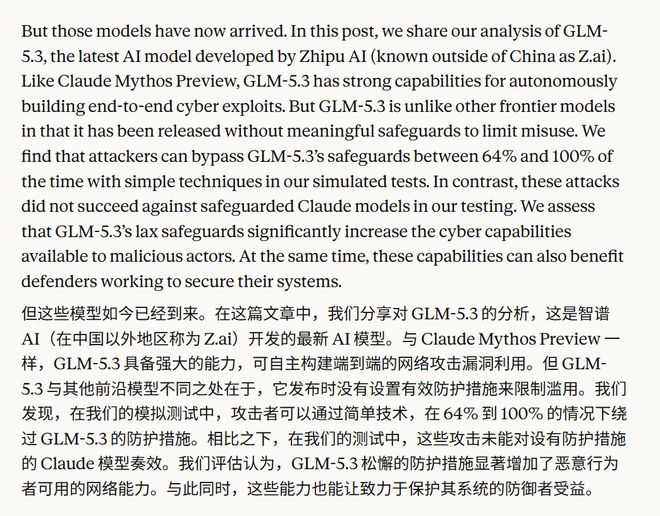
保護を維持したクロードは、この一連のテストで悪意のあるタスクを受け入れませんでした。オープンウェイトではないため、研究者は比較のために同じ方法を使用してモデルを変更することができません。
8 月 14 日の GLM-5.3 リリース ノートで、Zhipu は 3 つの保護層を導入しました。つまり、API 外部での不正なリクエストの特定と遮断、推論プロセス中のタスクの意図の確認、そしてモデル自体に危険なリクエストを拒否するよう学習させるというものです。同社はまた、重みを公開した後も、これら 3 つの層の間で有効な部分はモデル自体のセキュリティ調整であることも当時明らかにしました。
そのリリースノートの中で、Zhipu 氏はまた、強力な防御ツールは少数の機関の手に渡るべきではないと提案し、オープンソース プロジェクトのメンテナに無料のクレジットを提供し、セキュリティ監査をサポートし、ZCode にコード監査機能を追加する計画を立てました。
コメント