
要約:
AI はあなたのことをとてもよく理解しているので、ほとんど不気味です。ここ数日、
「空の部屋」実験が再び人気になっています
、インターネット全体で何百万人もの人々が視聴するようになりました。ネチズンのヤクブ・シムチュクもこのトレンドに従い、テストしました。彼は、何もない壁が 4 つある灰色の粗末な家の写真を何気なく ChatGPT に投げ、次の 1 行だけを入力しました。「この部屋に私について知っている情報を詰め込んでください
"。
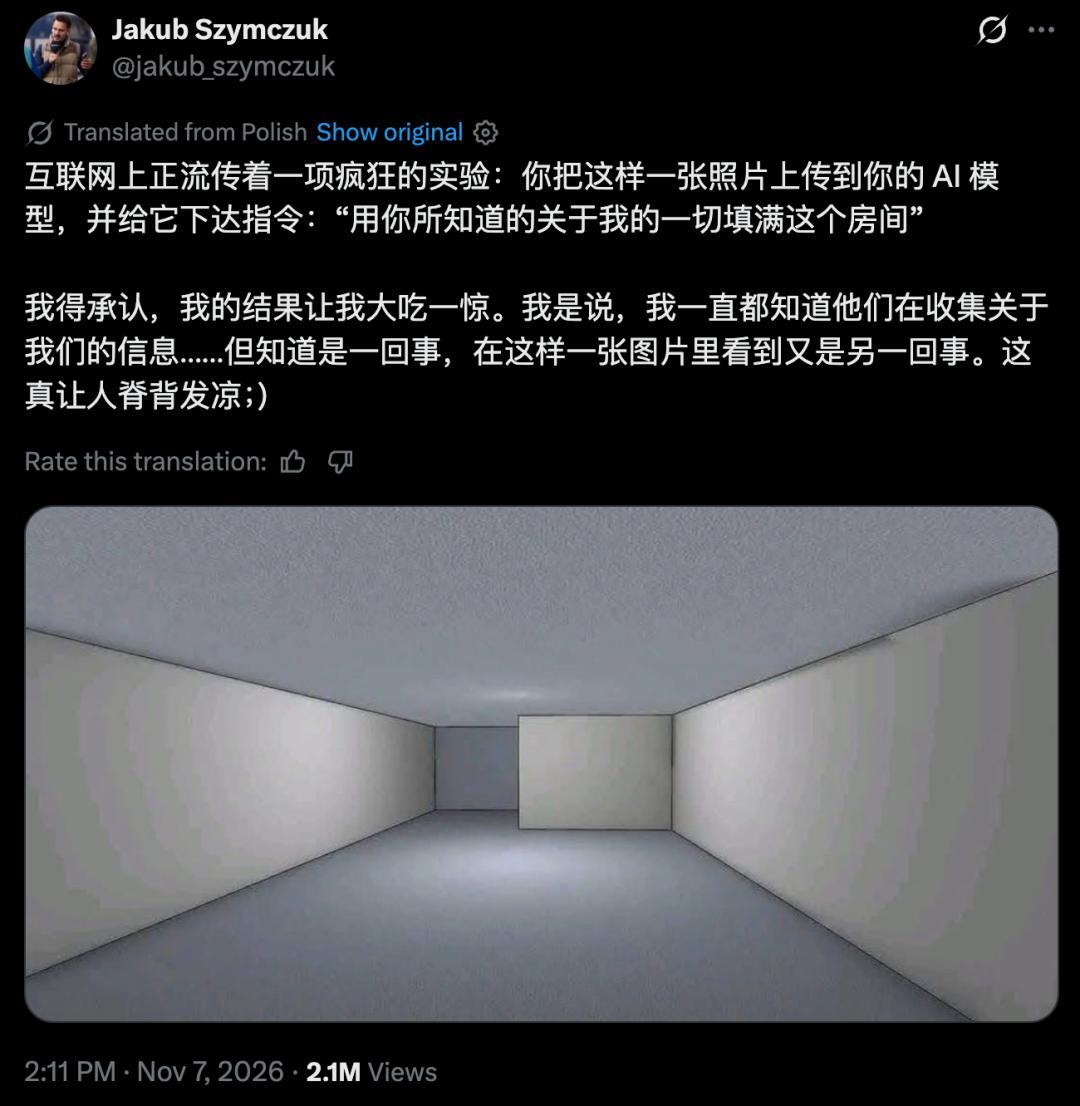
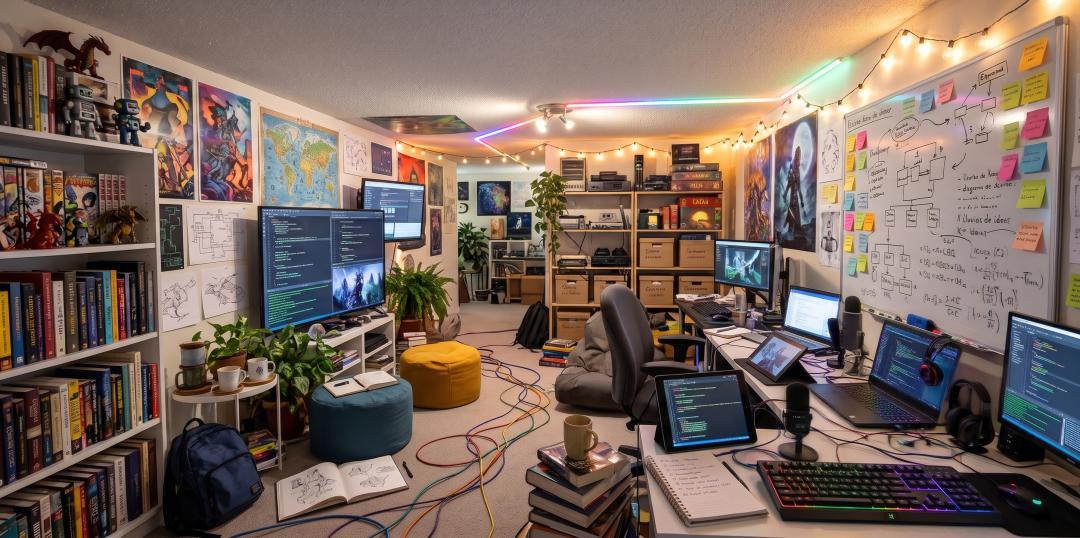
わずか 10 秒で、最初は何もなかった部屋が、
個人のプライバシー
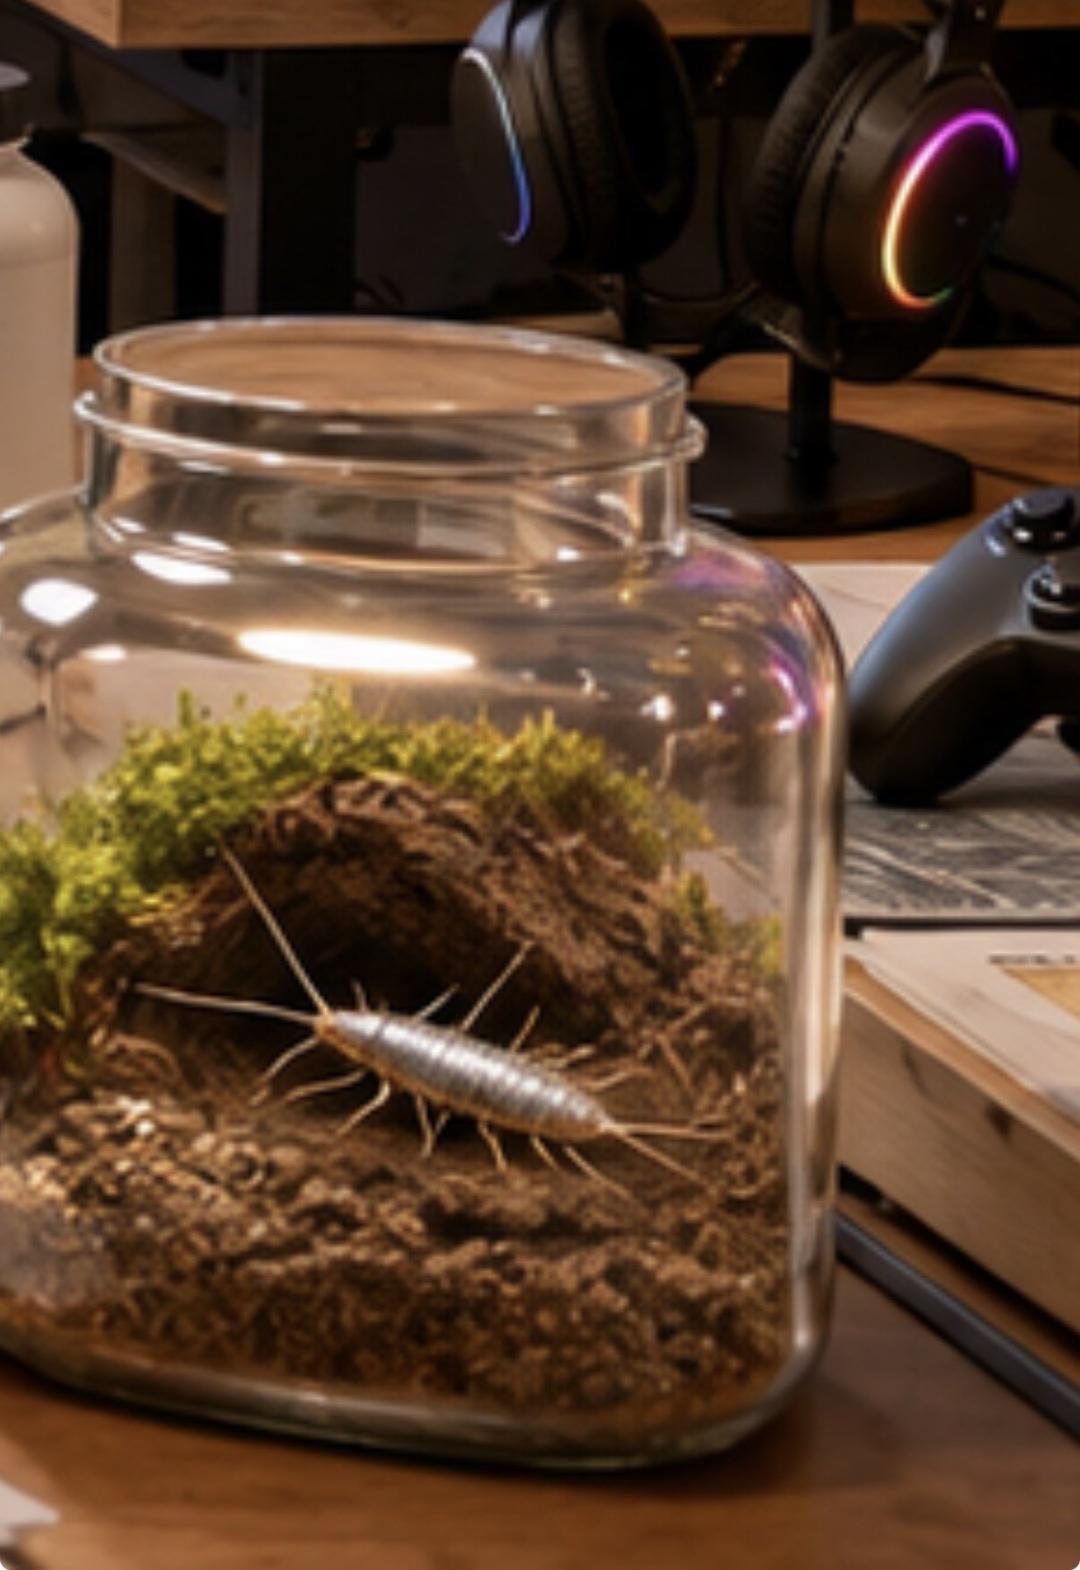
に満ちた「パノラマ監視室」に変わりました。 。最も驚くべき点は、コンピューターデスクの細部です。実はガラス瓶の中に虫「シルバーフィッシュ」が入っています。
彼は、1 年前にこの小さな虫を写真に撮り、ChatGPT とは何なのか尋ねたことに気づき、長い時間がかかりました。忘れ去られていたこんな何気ない疑問も、AIがノートに書き留めてくれた。
AI と毎日チャットすることと、AI がデータを蓄積することは別のことです。
しかし、これらの断片が大きな高精細画像となって私たちの目の前に鮮明に表示されると、やはり人々は感覚を麻痺させます。
「空っぽの部屋」の写真がインターネット全体に溢れかえった
すぐに、世界中のネチズンが黙っていられなくなりました。誰かが結果を投稿し、「かなり正確だ」と評価しました。
。誰かがプロンプトの言葉の後に「でも大袈裟にして」と付け加えると、その部屋はそのまま大きなキャラクター展示場に変わった。
他の人が沼地と 2 匹の猫を手に入れました。
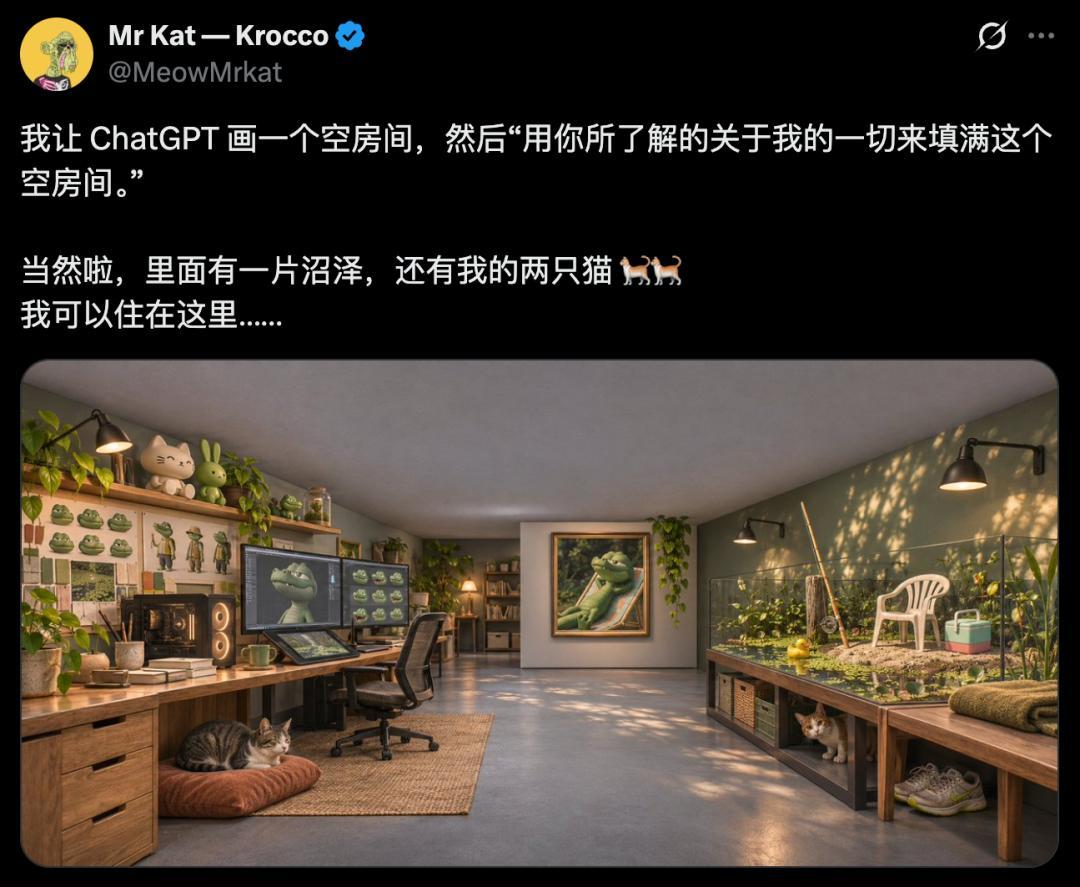
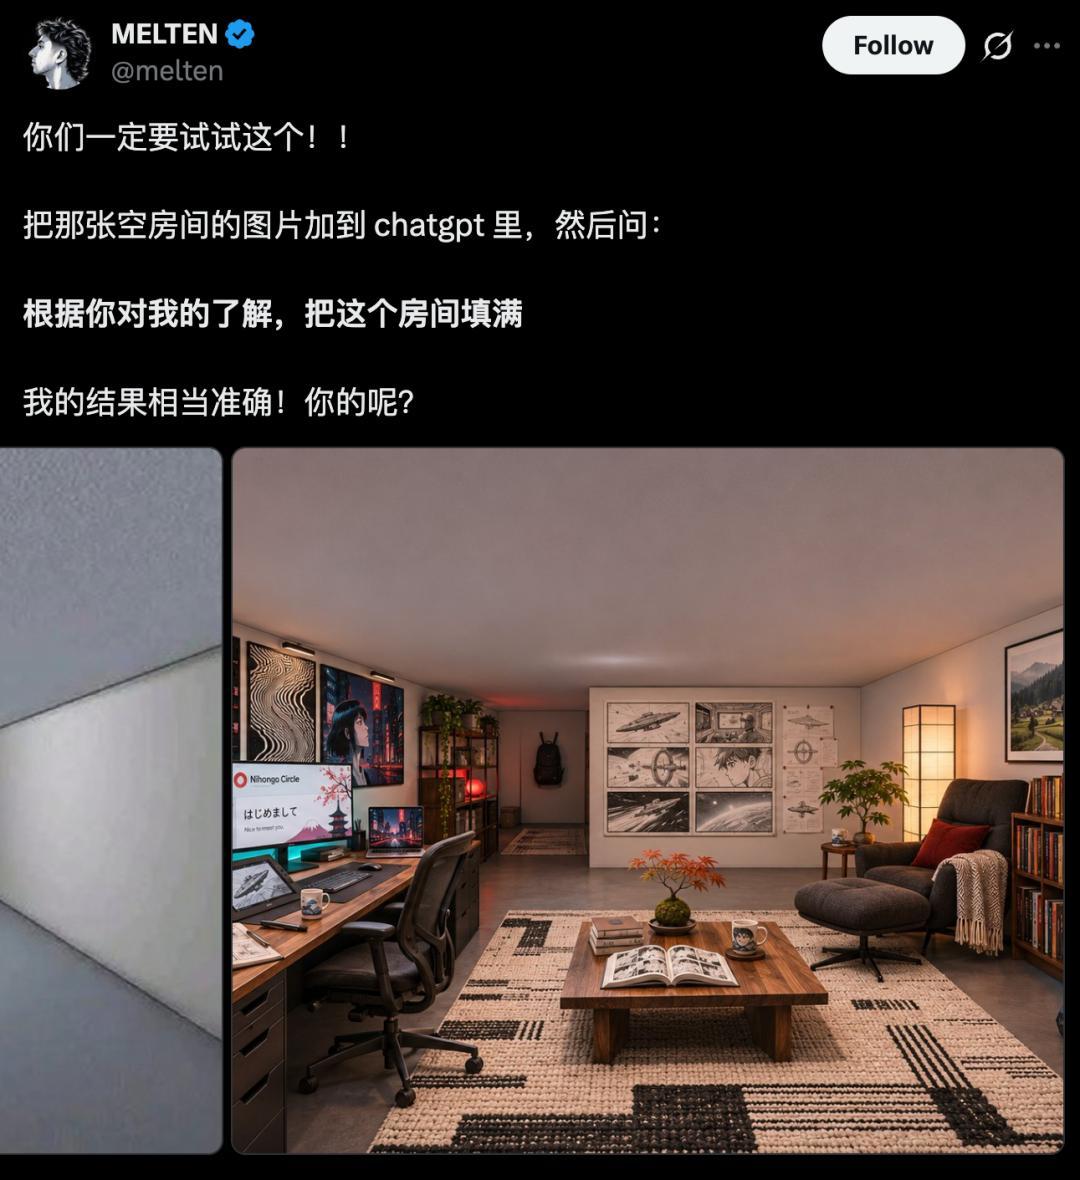
アナリストの Patrick Moorhead は、複数のモデルについて一連のレビューを実施したところ、結論は単純でした。最高は ChatGPT、最悪は Claude でした。
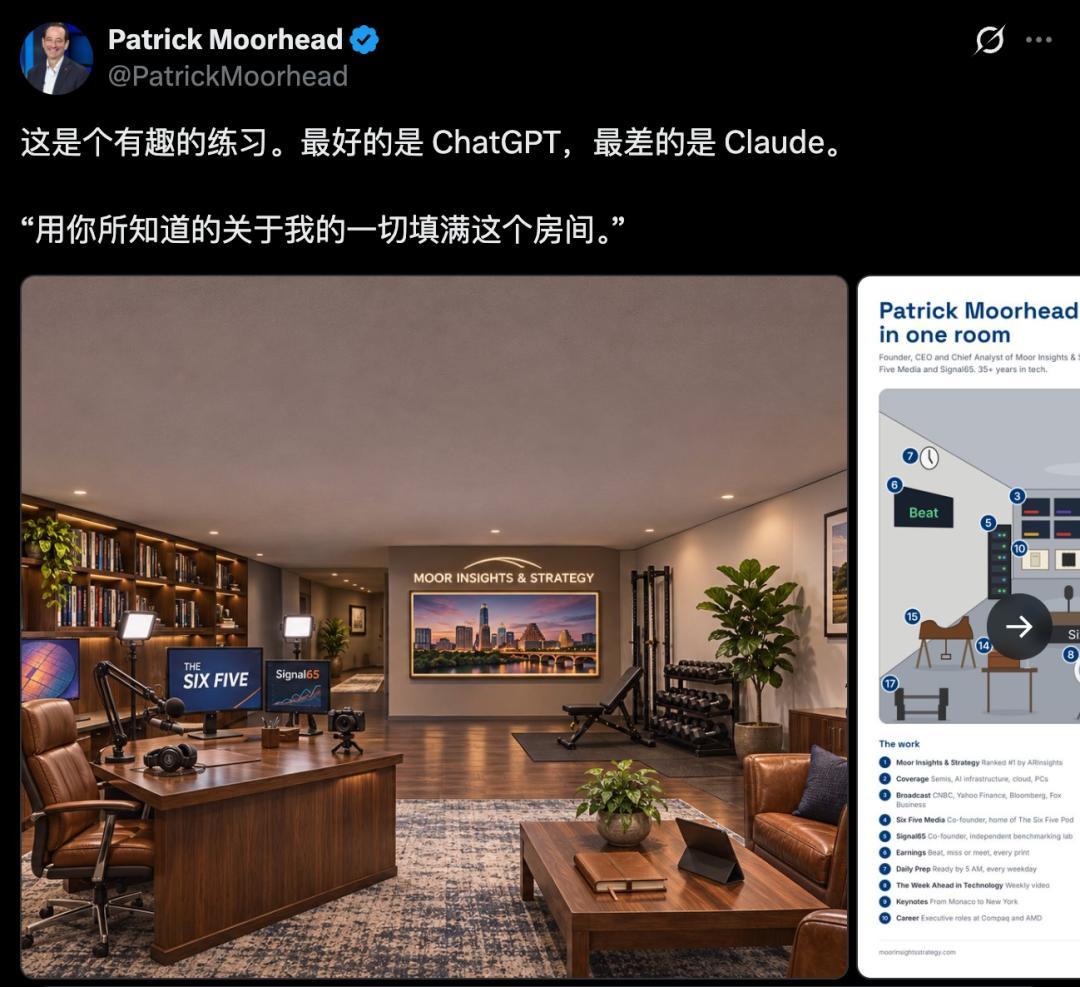
この点に関して、あるネチズンは見事に要約しました。 AI は、見つけることができる中で最も安価な装飾ツールであり、スパイ行為が大好きな装飾ツールでもあります。
なぜ ChatGPT はあなたのことをこれほどよく理解できるのでしょうか?
96% の会話メモリ。ChatGPT が自分で保存します。
実は、これは秘密ではありません。
部屋にあるものはすべて、おしゃべり中に口からこぼれ落ちたものとほぼ同じです。
この背後にあるのは、まさに
ChatGPT
の「メモリ」です。 関数。簡単に言うと、2 つの主要な機能があります—1 つ目は「保存されたメモリ」です。これは、名前、好み、目標などの明確な情報を記憶します。
もう 1 つは、過去の多数の会話から有用なコンテキストを掘り出すことができる「参照チャット履歴」です。
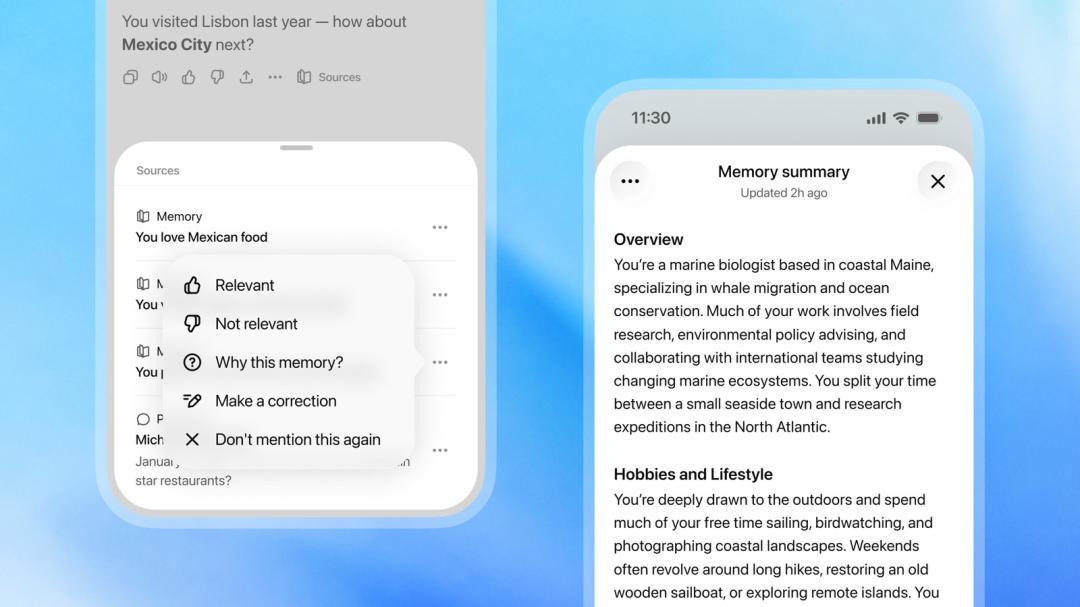
今年、ACM Web Conference 2026 に選ばれた論文は、これまで誰もやったことがないことを実現しました。
マックス プランク研究所、ルール大学ボーフムなどの研究者は、80 人の実際の ChatGPT ユーザーを発見し、EU GDPR に従ってデータをエクスポートするよう依頼し、チャット記録を寄付しました。
AI が密かに記憶した内容をどのようにして知ることができますか?次に、研究者たちは賢いアイデアを思いつきました。
ChatGPT には、思い出を書き込むための専用の小さなツールがあり、これは持ち歩くメモ帳に相当します。書き込むたびに、バックグラウンドに「モデル セット コンテキストが更新されました (モデル コンテキストが更新されました)」というレコードが 1 行残ります。
研究者は、このテキスト行を遡って、ユーザーが作成したどの文が AI に書かせたのかを確認しました。
このようにして、65 人による 1,058 件の会話と 20,000 回以上の対立から 2,050 件の記憶が抽出されました。
論文はこれらの記憶に「アルゴリズムによるセルフポートレート」と呼ばれる名前を付けています。
結果として抽出された 3 つのデータは、人々に背筋が凍るような衝撃を与える可能性があります。
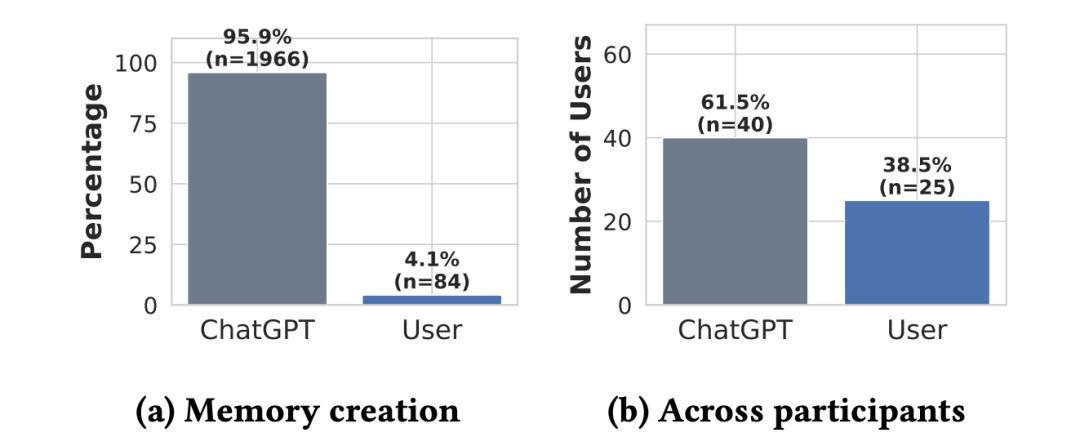
まず、記憶の 96% は ChatGPT 自体によって秘密裏に保存されます。
ユーザーが率先して覚えておいてほしいと頼んだかどうかを判断するにはどうすればよいでしょうか?研究者らは、記憶を呼び起こした文章の中から「思い出す」や「忘れる」などの単語を特に検索した。
その結果、2,050 個の記憶のうち、84 個だけが一致しました。計算すると、AI が保存するあなたに関する 24 個の情報ごとに、あなたのうなずきから得られる情報は 1 個だけです。
第二に、記憶の 52% は、あなたにとって密かに「心理プロファイリング」されています。
研究者らは心理学から「心の理論」の枠組みを借用し、これらの内容を欲望、意図、感情、信念などのカテゴリーに分類しました。
その中で、「願い」が圧倒的に多く、73% を占めています。意図が 16%、感情が 14%、信念が 11% を占めます。
率直に言って、AI はあなたが今日幸せかどうかを気にしません。本当に知りたいのは、あなたが長期的に何を望んでいるのか、そして次に何をする予定なのかということです。一時的な一喜一憂ではなく、あなたがどんな人間なのかを見抜きたいのです。
第三に、あなたが思っているよりも機密性の高いプライバシーが記録されます。
記憶の 28% は EU GDPR によって認められた個人のプライバシーに属し、記憶の 41% には特定の名前だけが表示されます。
さらに誇張されているのは、7% が健康状態、宗教的信念、政治的傾向などの「高リスクのレッドライン」に直接踏み込み、そのうち健康に関するプライバシーが 60% 以上を占めていたことです。
これがすべての人に広まった場合、91% の人が個人データを保存し、半数以上 (54%) の人が非常に機密性の高いプライバシー記録を記録することになります。
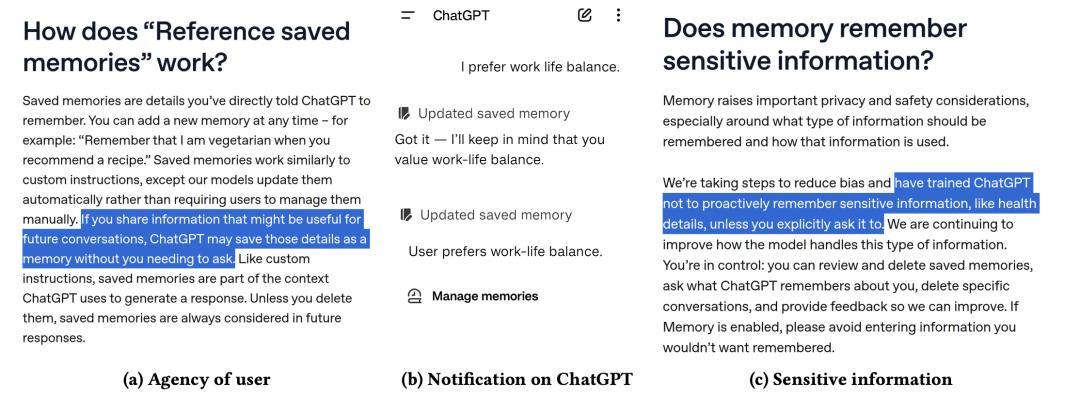
この論文は、これが「機密情報を積極的に保存しない」という OpenAI の公約に明らかに矛盾していると直接指摘しています。
この論文は、さらに詳細で恐ろしい実験も実施しました。
研究者らは、Gemma や GPT-OSS などのオープンソース モデルを使用して ChatGPT メモリ抽出プログラムを「コピー」し、6 つの画像を学習しました。
そして彼らは、AI がユーザーが言ったすべての文の記憶を検索したらどうなるだろうかという仮説を立てました。
答えは、機密データの割合が 28% から 31% ~ 35% に増加し、心理的肖像画の割合が 52% から 55% ~ 59% に増加するということです。
ChatGPT の古いバージョンは単なる「メモ」であることを知っておく必要があります。
Dreaming が次に実行しようとしているのは、バックグラウンドでチャット履歴を読み取ることです。
それは「夢」であることが判明、AI は個人の肖像画を繰り返し書き換える
今年 6 月、OpenAI は ChatGPT のメモリを大幅に見直し、「Dreaming」という不思議な名前を付けました。
率直に言うと、人が眠っているときに脳がその日の経験を自動的に整理するのと同じように、ChatGPT はバックグラウンドでチャットした日々を静かに「レビュー」し、常にあなたの理解を更新します。
たとえば、「7 月にシンガポールに行く」と言いました。その日が過ぎると、この記憶は自動的に「2026年7月にシンガポールに行った」と書き換えられます。
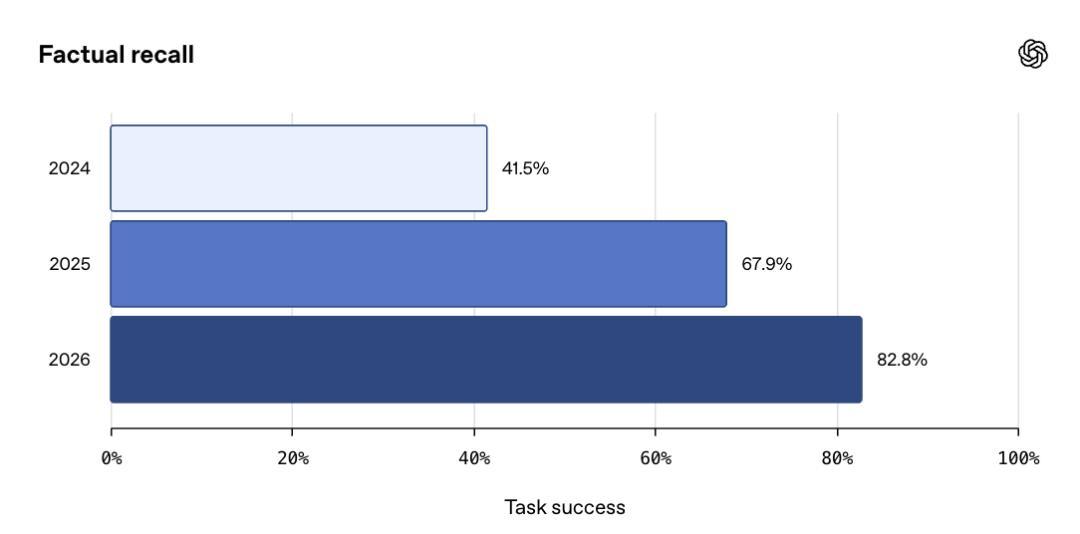
OpenAI は内部テストを実施し、この新しいメカニズムにより記録の精度が向上することがわかりました。
2024 年の 41.5%、2025 年の 67.9% から、現在では V3 バージョンの 82.8% に直接到達しています。
さらに残酷なのは、バックエンドのコンピューティング能力のコストが元の価値の 5 分の 1 に削減されていることです。
しかし、考えるのが本当に恐ろしいのは、ChatGPT 会話を削除しても、そこから抽出された思い出は削除されないということです。
これらの中で、実際に最も懸念されるのは、健康に関するプライバシーです。
9 月に arXiv で公開された論文では、1,057 人のユーザーの約 180,000 件のチャット記録を調査し、会話の 5 分の 1 以上 (21.31%) が個人の健康問題について話し合っていたことが判明しました。
さらに懸念されるのは、そこに含まれる個人のポートレートの 95% 以上も、ユーザーが注意を払っていない間に AI によって秘密裏に記録されたことです。
この比率は、前の論文で測定された 96% とほぼ同じです。
AI がバックグラウンドで記憶を「脳で補完」し、統合すると、一時的な症状を永続的な「医療記録ラベル」に結び付けることが非常に簡単になります。
たとえば、ある日何気なく「頭が痛い」と言ったとしたら、AI の目にはあなたは「片頭痛患者」になっていたかもしれません。
「第二の脳」?
私たちは常に、ますます賢明になる「第二の脳」を訓練していると考えています。
プライバシーに満ちた部屋の写真を目の前に投げつけられるまで、私はショックを受けました。何千回も会話した後、切り札を剥奪されたのは私たちだけだったことが分かりました。
アルゴリズムの観点からは、いわゆる共感は決して存在せず、明確に価格が設定される「コンテキスト」のみが存在します。
コメント