要約:
Google は本日、ネイティブ エンドツーエンド音声インタラクションの分野における最新の画期的な進歩を正式に発表し、難しいタスク向けにカスタマイズされた新世代のリアルタイム音声大型モデル Gemini 3.8 Live および Gemini 3.8 Live Extended Thinking を発売しました。
これら 2 つのモデルは、Google のネイティブ オーディオ間テクノロジ システムにおける大きな進歩を表しています。これらは、リアルタイムの会話の遅延と自然さを新たな高みに押し上げるだけでなく、低遅延の音声ストリームで初めて詳細なマルチステップ推論機能を実現し、複雑なプロフェッショナル シナリオにおける音声 AI のアプリケーション パラダイムを完全に変えます。
以前の主流の音声インタラクション アーキテクチャでは、AI システムは通常、「迅速な応答の浅い対話」と「長期的な深い思考」の間で妥協する必要がありました。困難な問題に直面すると、ユーザーは長時間黙って待つ必要があることがよくありました。 Google が発表した Gemini 3.8 Live は、超高速の会話と毎日のストリーミング インタラクション エクスペリエンスの最適化に重点を置いています。より繊細なイントネーションの変動、自然な中断、状況理解機能を備えた、非常にスムーズで人間レベルのリアルタイム音声コミュニケーションをユーザーに提供できます。 Gemini 3.8 Live Extended Thinking は、これをベースにして発売され、非常に複雑なビジネス フロー向けに根本的にアップグレードされました。このモデルは、AI にバックグラウンドで「話すように考える」 (Think as it speech) 能力を与え、システムがリアルタイムの一貫した対話を維持しながら、バックグラウンドで複雑な複数ステップのロジックの分解、コードのデバッグ、または技術的診断を同時に実行できるようにし、難しい問題に遭遇したときに会話のリズムを突然中断する必要がありません。
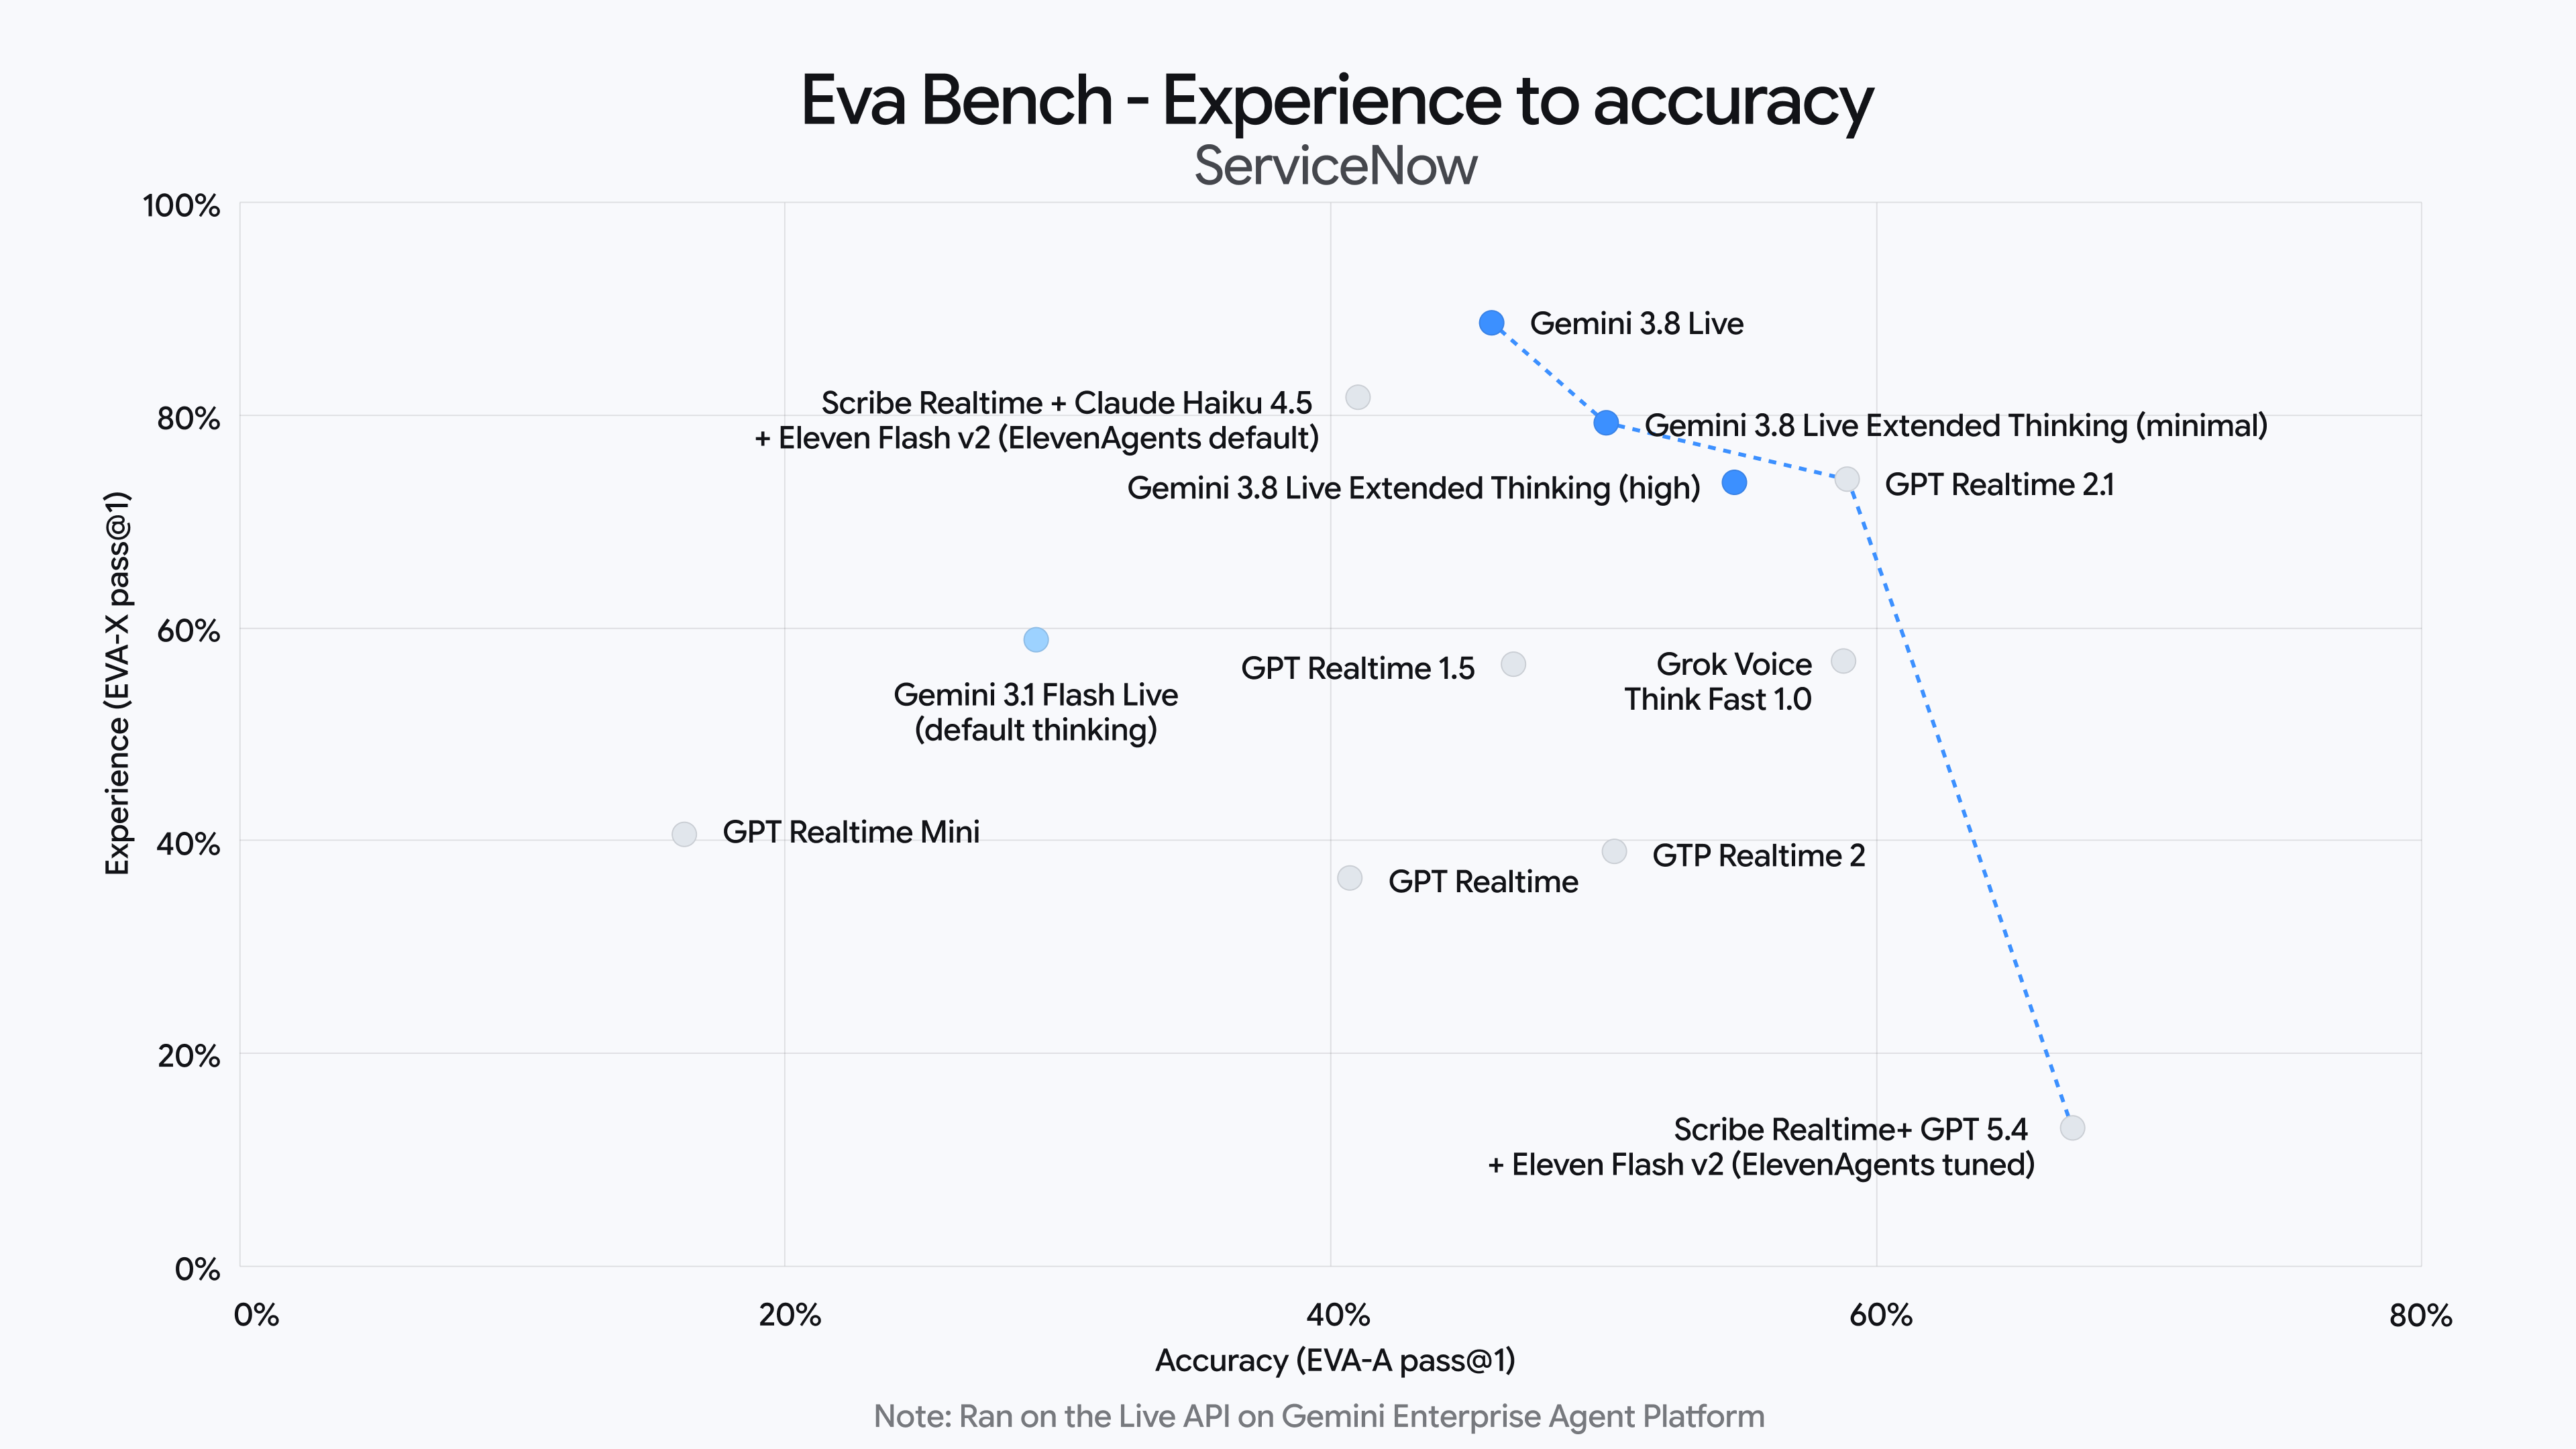
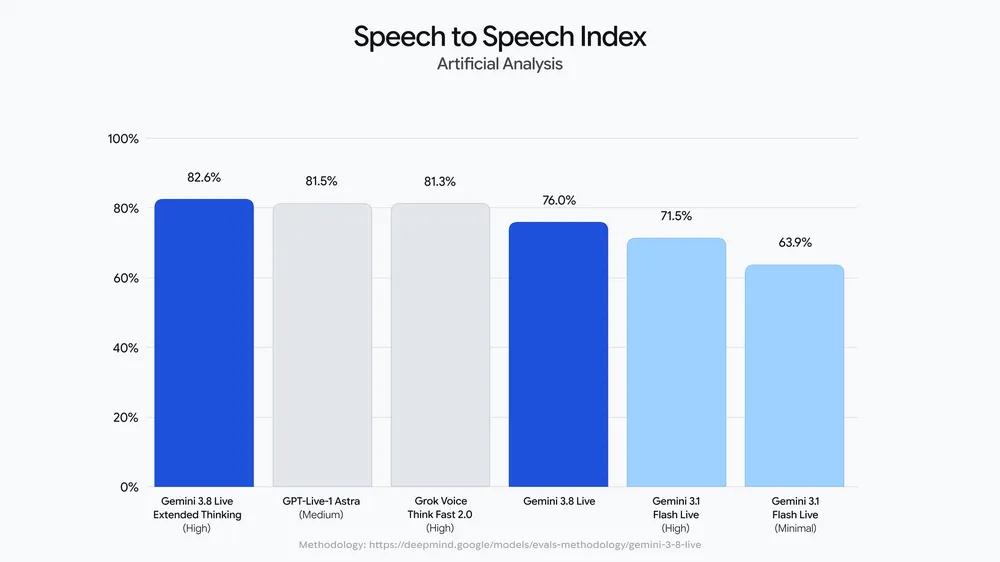
実用化の観点からは、新世代の Live シリーズ モデルは、音声アシスタントのサービスの境界を大幅に拡大します。 Gemini 3.8 Live および拡張推論バージョンは、日常の自然な会話に加えて、リアルタイム ステップのトラブルシューティング、複雑な数学的導出、リアルタイムの外国語同時指導、マルチタスク ストリーミング命令の実行など、高度な知的要求を伴うシナリオにおいて、以前のバージョンよりも大幅に優れたパフォーマンスを示し、複数のマルチモーダルおよび音声推論業界のベンチマークで 1 位にランクされています。
Google は、開発者および企業ユーザー向けに、今後、Gemini API および Google AI Studio を介して、関連するモデル機能に正式にアクセスできるようになると発表しました。開発者は、この極めて低遅延のネイティブ オーディオ API インターフェイスを直接呼び出して、インテリジェント ハードウェア、カスタマー サービス、リアルタイム プログラミング支援、コラボレーション オフィスなどの製品形式で高次推論機能を備えた次世代の全二重音声エージェント サービスを迅速に構築できます。
コメント