
要約:
Google は、新世代の人工知能ワールド モデルである Genie 4 を 10 月 27 日にリリースしました。これにより、AI が生成したインタラクティブ環境のリアリズムがさらに向上し、リアルタイムでシーンを変更し、オーディオを自動的に生成する機能が追加されました。主に静止画やビデオを出力する従来の画像生成モデルとは異なり、Genie 4 はユーザーが参加して対話できる仮想世界を作成できます。関連技術は、ゲーム開発、映画・テレビ制作、ロボット訓練などの分野への応用が期待されています。
Genie 4 では、今回主に 4 つのアップグレードが行われます。より現実的な仮想環境の生成、ユーザーが自然言語プロンプトを通じてリアルタイムでシーンを変更できるようにすること、生成された世界に音声を自動的に追加すること、シミュレーション プロセスを支援するための Google Gemini 3.8 Flash モデルの使用です。さらに、新しいモデルは最大約 2 分間のインタラクティブ エクスペリエンスを生成できます。これは、前世代の Genie 3 でサポートされていた長さの 2 倍です。
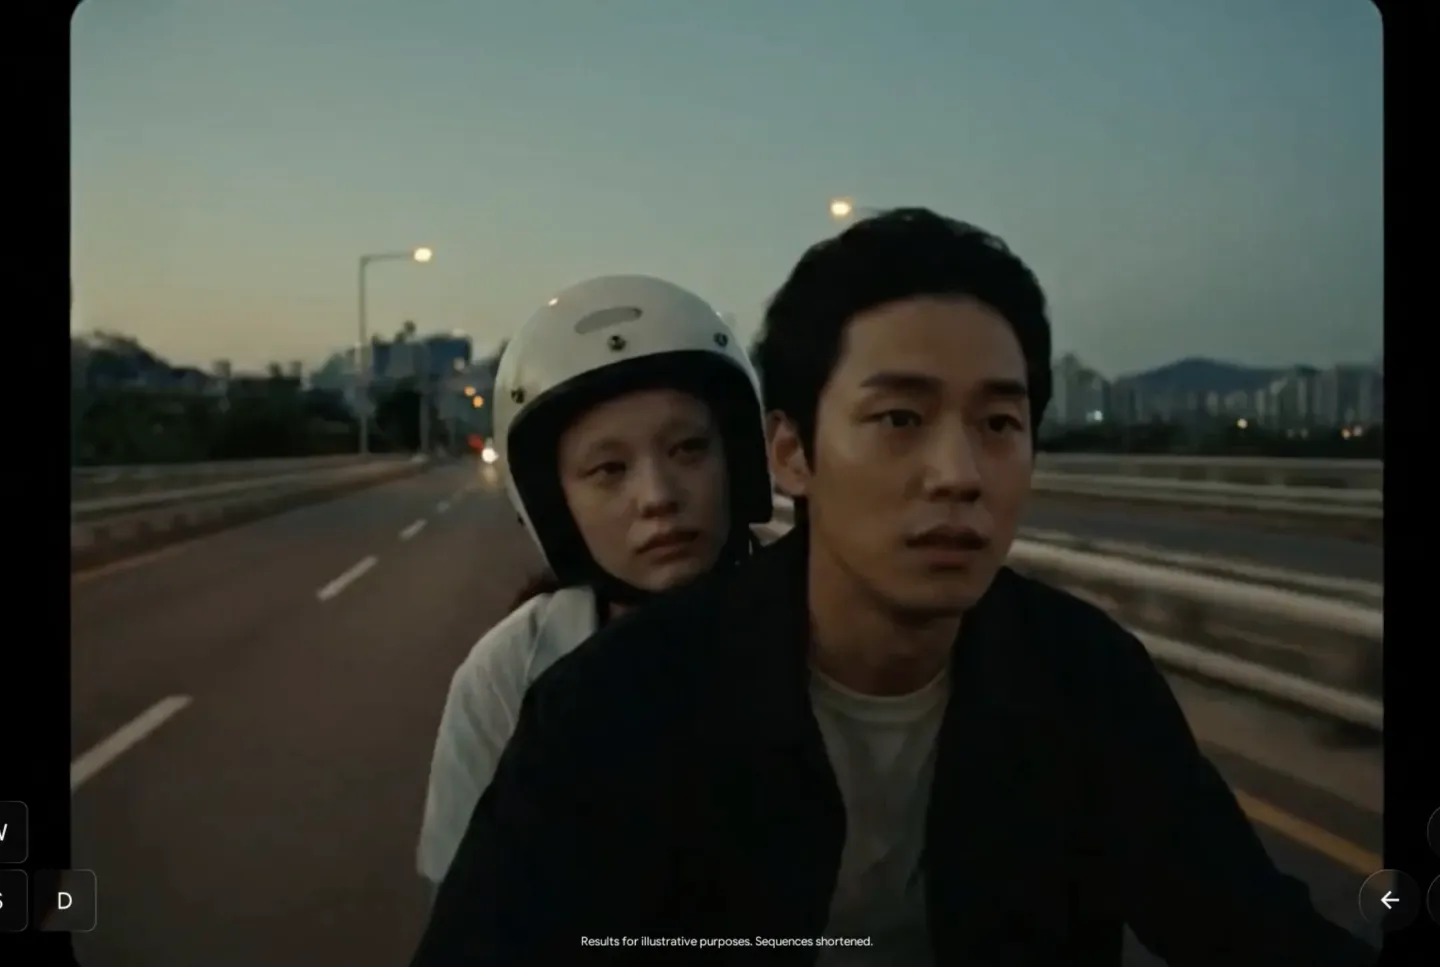
世界モデルは、近年の人工知能研究の重要な方向性の 1 つです。従来の生成 AI は通常、テキスト プロンプトに基づいて画像、ビデオ、その他のコンテンツを生成しますが、ワールド モデルはさらに一歩進んで、環境内の空間関係、オブジェクトの移動パターン、アクションと結果の関係を学習しようとします。モデルによって生成されたコンテンツは、ユーザーがただ見るだけではなく、ユーザーの操作に応じて変化し続けます。
たとえば、AI によって生成された仮想環境では、ユーザーはキャラクターを制御して移動したり、視点を変更したり、シーン内のオブジェクトと対話したりできます。モデルは、これらの操作に基づいて後続のイメージを継続的に生成し、環境の一貫性を可能な限り維持する必要があります。このような機能は、ゲーム、ロボット シミュレーション、複雑な環境でのトレーニングに潜在的な価値をもたらします。
Genie 4 の重要な改善点は、ユーザーが体験中に自然言語の指示を通じて仮想世界を変更できることです。現在のシーンを終了し、プロンプト ワードを書き換えて最初から生成する代わりに、ユーザーは環境内の特定の要素を変更するようにモデルに直接要求して、シーン デザインを迅速に調整できます。
この機能は、ゲーム開発者や映画、テレビの制作チームにとって特に役立つ可能性があります。制作に正式に多くのリソースを投資する前に、クリエイターは AI を使用して予備的なシーン プロトタイプを生成し、さまざまな環境レイアウト、ビジュアル スタイル、インタラクション方法を試し、どのソリューションがさらなる開発に値するかを判断できます。
映画制作の場合、このタイプのテクノロジーはプレビジュアル プレビューにも使用される場合があります。制作チームは、実際のセットをすぐに構築したり、複雑な 3D アセットを作成したりすることなく、仮想セットを迅速に構築して、カメラの動き、キャラクターのパス、環境効果を探索できます。
Genie 4 にはオーディオ生成機能も追加されています。以前のワールド モデルは主に視覚環境とインタラクション プロセスに焦点を当てていましたが、新しいモデルでは生成されたシーンにサウンドを追加できるため、仮想体験がより完全なものになります。オーディオは環境の雰囲気をシミュレートするのに役立ち、ゲームのプロトタイプに予備的な音響効果を提供することもあります。
ただし、オーディオの自動生成は、このモデルがプロのサウンドエフェクト制作を完全に置き換えることができるという意味ではありません。リズム、空間配置、キャラクターの対話、サウンドとアクションの同期関係を正確に制御する必要があるプロジェクトの場合、さらなる手動調整と専門ツールのサポートが依然として必要です。
Google はまた、Genie 4 をロボットのトレーニング シナリオの作成に使用できるとも述べました。ロボットは現実世界で動作を学習およびテストしますが、これには多くの場合、設備コスト、現場の制約、潜在的な安全上のリスクが伴います。インタラクティブな模擬環境をワールド モデルから生成できれば、研究者はロボットが仮想シーンでどのように移動し、物体をつかみ、さまざまな環境条件に反応するかをテストできます。
このタイプのシミュレーション機能の鍵は、仮想シーンを現実的に見せるだけでなく、オブジェクトの空間関係、動作パターン、動作の結果をできるだけ正確に表現することです。シミュレートされた環境が現実世界の物理的制約をより確実に反映できる場合にのみ、仮想環境でロボットによって学習された戦略が実際のデバイスに転送される可能性が高くなります。
技術的なアーキテクチャの点では、Genie 4 は Gemini 3.8 フラッシュを使用してシミュレーション プロセスを支援します。 Google は、このモデルの機能を利用して、生成された環境における論理的一貫性とインタラクティブなパフォーマンスを向上させたいと考えています。ただし、同社はこのレポートで詳細な技術指標を十分に開示していないため、前世代モデルと比較した全体的なパフォーマンスの向上を正確に測定することはまだ不可能です。
ビルド時間の延長も、このアップデートの重要な変更点です。 Genie 3 では約 1 分間続くインタラクティブなエクスペリエンスが生成されましたが、Genie 4 ではこの時間が約 2 分間に延長されました。完全なゲームや複雑なシミュレーションでは 2 分はまだかなり制限されていますが、ラピッド プロトタイピングや短いインタラクティブ エクスペリエンスを検討するための余地はすでに十分にあります。
同時に、Google は、シミュレーションの期間が延長されると、依然として仮想環境で不整合が発生する可能性があることも認めました。たとえば、シーン内の詳細は徐々に変化する可能性があり、一部のオブジェクトは元の位置と状態を常に維持するとは限りません。これには、ワールド モデルの核となる問題が伴います。モデルは、妥当に見える次のフレームを生成する必要があるだけでなく、長期間にわたって安定した継続的な環境を維持する必要もあります。
ユーザーがシーンを離れた後にオブジェクトが消えたり、シーンに再入場したときに突然位置が変わったりすると、画像自体が十分にリアルであっても、エクスペリエンス全体が信頼性に欠けるように見えます。したがって、オブジェクトの永続性、空間メモリ、および長期的な状態の一貫性は、依然としてワールド モデルで改善し続ける必要がある重要な機能です。
リリース スケジュールに関しては、Genie 4 は現在、リサーチ プレビューの形式で選ばれたテスターに公開されています。 Googleは、将来的にはGoogle AI Ultra加入者向けに提供を開始すると述べ、ユーザーがProject Genieを通じて新モデルの体験を申し込むことができる待機リストを開設したと述べた。
現時点では、新モデルが前世代の Genie 3 と比較してどれだけ進歩したかを独自に判断することは不可能です。現段階での公開デモンストレーションは主に Google 関係者によるものです。実際のユーザー エクスペリエンス、長期的なインタラクション パフォーマンス、複雑なシナリオにおけるモデルの安定性は、後続のテストで検証する必要があります。
業界の発展方向の観点から見ると、Genie 4 は、生成人工知能がコンテンツ作成から環境シミュレーションやインタラクティブな体験にまで拡大していることを表しています。将来の AI システムは、プロンプトに基づいて画像やビデオを生成するだけでなく、探索、変更、対話できる仮想空間を直接構築する可能性があります。
しかし、このテクノロジーがゲーム開発、ロボット トレーニング、映画やテレビの制作において本当に実用的なツールになるためには、長期的な一貫性、物理シミュレーションの精度、インタラクティブな応答速度、制作コストなどの問題を解決する必要があります。 Genie 4 は現在、従来のゲーム エンジンやプロ仕様の 3D 制作ツールに代わる成熟した製品というよりは、この方向における重要な実験的進歩に近いものとなっています。
Project Genie で Genie 4 へのアクセスをリクエストします:
https://docs.google.com/forms/d/e/1FAIpQLSeD73fWVFVUXII27wIaSjdCZCesuGEb5-iZaBSTUpjkX98S0g/viewform?usp=send_form
コメント