
要約:
同様に、10 個のプログラミング タスクをすべて正しく実行する場合、DeepSeek の新しいバージョンのコストは Claude Opus 5.5 の 40% 未満であり、各タスクの平均待ち時間は 2 分長くなりました。
10 月 17 日に、DeepSeek は V4.1-Flash-1017 をリリースしましたが、価格は変更されませんでした。リリース後、開発者はすでにこれを使用してゲームを作成し、Web ページを構築し、コードを変更しています。
実際のレベルをテストするために、開発者の Ibragim Badertdinov は日々の業務から 10 のタスクを選択し、DeepSeek V4.1-Flash-1017 の高推論ギアと Opus 5.5 および GPT-6 Astra の低ギアを使用して、同じプログラミング ツール セットで異なるモデルを 3 回実行しました。
実際のテストの後、3 つのモデルはすべてテストに合格しましたが、請求と時間がかかることで差はさらに広がりました。DeepSeek はタスクあたり平均 0.045 米ドルしか費やさず、Opus の 0.1168 米ドルや GPT-6 Astra の約 0.26 米ドルよりもはるかに低かったです。ただし、Opus と GPT は完了するまでにそれぞれ 37 秒と 55 秒しかかかりませんでしたが、DeepSeek は 2 分 38 秒かかりました。
これら 10 個のタスクはすべて小規模です。完全なプロジェクトとして、DeepSeek、GPT、および Claude の間のギャップは、もう少し待つだけの問題でしょうか?
01 の 10 問すべてに合格しました。DeepSeek はお金を節約し、Opus は時間を節約しました。
Ibragim が選んだトピックは、Python と TypeScript を使用した、データ処理、バックエンド、フロントエンド、デプロイメントを含むエージェントの使用に関する彼自身の約 3 か月の記録から来ています。彼は通常 1 時間以内に完了できるタスクを選択し、それらに自動チェック プログラムを追加しました。
彼が開示した単純化された例は、データのバッチをローカル データ テーブルにインポートすることです。インポートを成功させるだけでなく、プログラムは重複レコードをスキップし、矛盾する数値を拒否し、不満足なデータを報告する必要もあります。古いデータを置き換える場合、書き込み途中で元のコンテンツを破壊することはできません。テストでは、空の入力、データの競合、元のファイルの破損などがチェックされます。
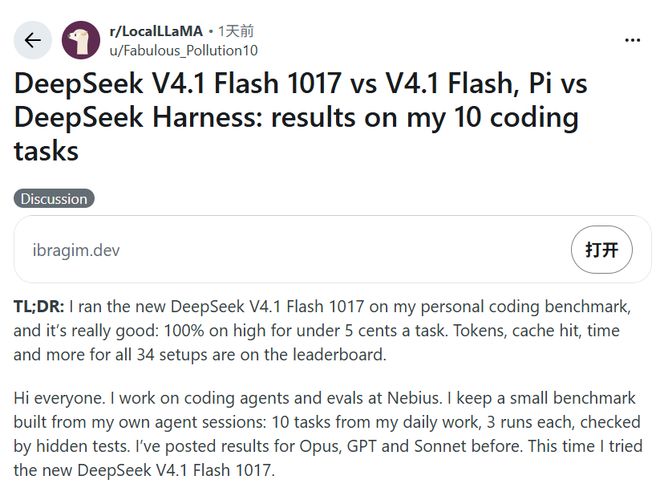
3 つのモデルはすべてこれらのチェックに合格しましたが、DeepSeek はさらに多くの手順を実行しました。
また、Pi プログラミング ツール上で実行すると、DeepSeek はタスクあたり平均 15.3 ステップ、Opus は 3.7 ステップ、GPT-6 Astra は 6.5 ステップかかります。 DeepSeekの総トークン使用量は約547,000、Opusの総トークン使用量は約31,000です。たくさん使いますが、請求額は上がりません。 Ibragim 氏は、DeepSeek のほぼすべての入力がキャッシュにヒットし、記録されたキャッシュ ヒット率は 97.9% に達したと説明しました。 547,000 トークンは、モデルによって新たに書き込まれたものではありません。このような長い応答には、複数回の通話で繰り返し送信された内容が含まれていました。安価なキャッシュされた入力により、このテストのコストはテストあたり 5 セント未満に抑えられました。
ユーザーにとって、この 2 分間が何らかの影響を与えるかどうかは、画面の前で待っているかどうかによって決まります。タスクを引き継いで他のことをした後は、待つのが妨げになることはありません。結果を確認した後すぐに次の変更ラウンドを実行したい場合は、この一連のテストにおける Opus と GPT の速度の方が便利です。ここで比較されるのは、ChatGPT または Claude サブスクリプション パッケージの月額料金ではなく、API を通じてタスクを完了するコストです。
新しいバージョンは、以前のバージョンと比較して改善されています。 Ibragim は以前、9 月バージョンの Flash の最も高い推論設定をテストに使用し、30 回の実行中 28 回合格し、各テストの平均時間は 4 分 30 秒でした。今回は新バージョンのハイエンド設定を使用し、全30回を通過し、タイムは2分38秒に短縮された。
02 BMW を $0.38 で作りましたが、通常の Web ページを実行するのに 40 分かかりました
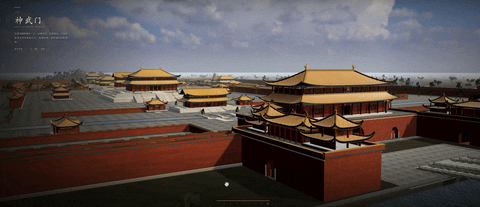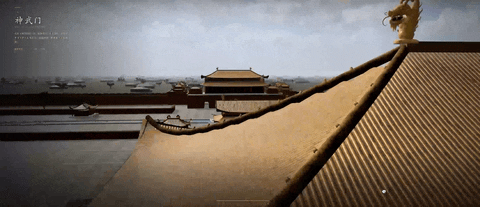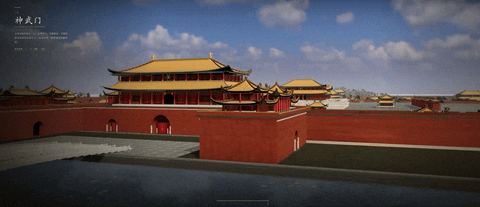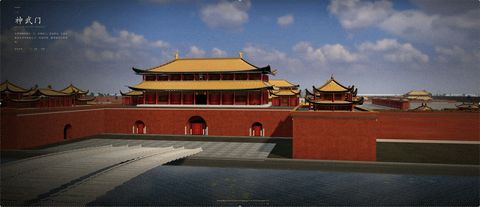
今回 DeepSeek が示したいのは、単に関数を埋めることではありません。公式に公開された事例には、紫禁城の 3D シーン、Web レーシング ゲーム、Godot で制作された「Portal 2」再現デモなどがあります。同社によると、新バージョンでは自己フィードバックによる強化学習により、プロジェクトをゼロから完成させる能力が向上したという。
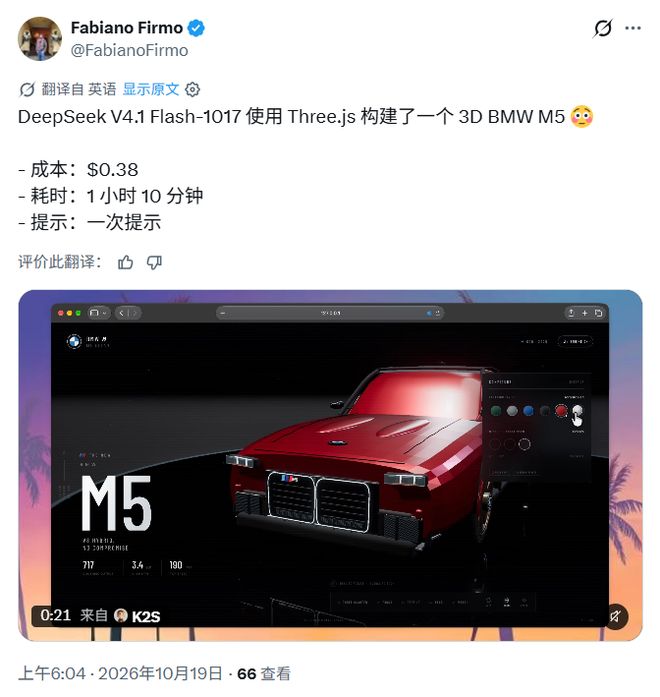
開発者の Fabiano Firmo は、Three.js を使用して BMW M5 の 3D モデルを作成するように依頼しました。彼が投稿した写真では、表示ページに赤い車が表示され、その横に色のオプションが表示されています。
彼によると、今回彼が出したリマインダーは 1 つだけで、費用は 0.38 ドル、所要時間は 1 時間 10 分でした。
一部のユーザーは、車がフィールドでサッカーをする「ロケット リーグ」に似たゲームをデモしました。 X ユーザーの Markets & Mayhem は、物理効果は正常に動作し、プレイ可能ですが、まだ改良の必要があるとコメントしました。最初に Web ページやゲームのプロトタイプを作成したい人にとっては、試験のスコアをモデル化するよりも、これらのデモの方が用途が分かりやすいです。
ただし、3D の車を見るために 1 時間以上待つことをいとわないからといって、通常の Web ページを作成するためにそれほど長く待つことをいとわないという意味ではありません。
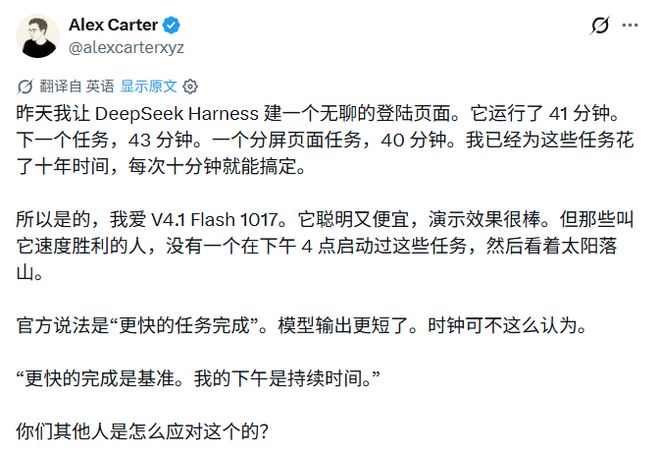
開発者の Alex Carter 氏は、DeepSeek Harness に通常のランディング ページの作成を依頼したが、実行に 41 分かかったと述べました。次の 2 つの Web ページ タスクにはそれぞれさらに 43 分と 40 分かかりました。彼は、このモデルはスマートで、安価で、見栄えも良いと考えていましたが、このページは何年もかけて作成したもので、通常は 10 分で完成します。
開発者の unbug も同様の感覚を持っています。モデルはよりスマートになりましたが、考えすぎると行動が遅れがちです。別のユーザー Elshayib 氏は、彼の苦情は 1 秒あたりに出力される単語数に関するものではなく、モデルが行動するまでに考えるのに時間がかかりすぎることだと強調しました。
API プラットフォーム OmniaKey のテストでは、この長い推論出力が記録されました。新しいバージョンの Flash では、Python の演算ルールに従って式を計算するプログラムを作成する必要があり、既製の解析ツールを呼び出すことはできません。モデルが 30 の検査ユースケースすべてに合格するのに約 88 秒かかりました。出力された約 20,700 個のトークンのうち、約 19,700 個がコンテンツと見なされます。
しかし、Flash はすべてのタスクに対して遅いわけではありません。 OmniaKey の別のテストでは、ドイツ語と英語が混在した請求書メールから 10 個のフィールドを抽出し、5.2 秒ですべてのフィールドに正しく回答しました。 2 つの都市の天気と時刻をクエリするツール呼び出しは 2.6 秒で完了しました。 OmniaKey 自体がモデル API を販売しており、この一連のテストはそれぞれ 1 回だけ実行されます。
BMW のモデリングとランディング ページのこれらの例は、同じトピックに関する 3 つのモデルの比較ではありません。 deepSeek の完成品がどのようなものであるか、その後何回改訂されるかについては、同じ要件の下で GPT や Claude と比較する必要があります。
03 ギアを下げた後、1 分速くなりましたが、さらに 3 回失敗しました
推論設定を高くすると時間がかかるので、低くするとどうなりますか?イブラギム氏もそれをテストした。
Pi では、DeepSeek の新しいバージョンが低い設定に調整された後、アイテムあたりの平均時間が 2 分 38 秒から 1 分 31 秒に短縮され、コストが 0.045 米ドルから 0.0257 米ドルに削減されました。ただし、30 回の実行のうち 3 回は失敗しました。
高いレベルで獲得したパスをすべてそのまま保持することはできません。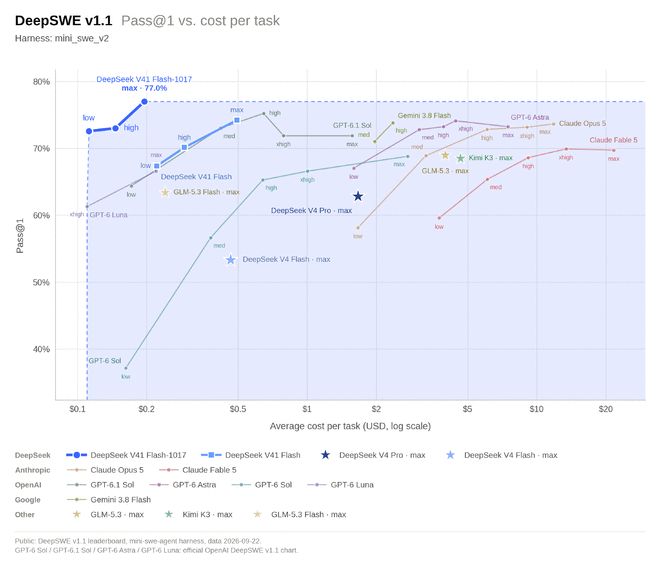
この低レベルで、DeepSeek 独自のハーネスに切り替えたところ、結果は再び変わりました。30 回の実行で 29 回パスし、Pi より 2 回多くなりました。 Ibragim の記録によると、公式ツール環境は、Pi では欠落していた境界条件をモデルが処理するのに役立ちました。
2 つのツール セットは、モデルに対する動作が異なります。 DeepSeek Harness はファイルの読み取りと編集のためのツールを直接提供しますが、Pi では主にコマンド ラインを介してモデルを操作できます。前者のシステム プロンプト ワードも長くなります。今回ツールを変更した後、トークンの使用量は約 75% 増加し、平均所要時間は 1 分 31 秒から 1 分 53 秒に増加しました。どちらのツール セットでも、3 回連続で通過できるタスクは 9 個だけです。
同じモデルでも、推論ギアとツールのセットを変更すると、速度、コスト、成功率が変化します。
他の人が投稿した結果のみが表示されますが、その人がどのような設定を使用したかを知る必要もあります。DeepSeek はリリース時に、DeepSeek Harness、Tencent CodeBuddy、WorkBuddy などのツールを最適化していることも明確に述べており、Harness ユーザーには v0.2.1-rc.1 以降にアップグレードすることを推奨しています。
このアップデートは、Web ページ、アプリ、API で開始されました。 API 呼び出しでは引き続きディープシークフラッシュが使用され、価格は変わりません。新しいモデルの重みも MIT プロトコルに基づいて公開されました。
ただし、前回のプログラミング テストは、ファイルを読み取り、コードを変更し、チェックを実行できるツールにモデルを接続することで完了しました。チャット ウィンドウにコードを書くように依頼することは、プロジェクトを引き継ぐように依頼することとは異なります。使用環境が異なります。
04同じ質問セットの場合、GPT と Claude の方が安くなる可能性があります
Opus と Astra は 2 社の主力製品であり、OpenAI と Anthropic にも安価なモデルがあります。
同じ一連の Ibragim テストで、GPT-6 Luna の xhigh ギアと Haiku 5.5 のハイ ギアはすべて 30 回合格しました。各アイテムの平均コストはそれぞれわずか 0.0145 米ドルと 0.0208 米ドルであり、DeepSeek よりも低くなっています。
両者の平均消費時間はそれぞれ 2 分 46 秒と 2 分 08 秒です。これにより、選択はもはや「高価な GPT、クロード」または「安価な DeepSeek」だけではなくなります。すでに Luna または Haiku を使用して小規模なタスクを処理している人は、Flash に切り替えてもさらにコストを節約できない可能性があります。
より難しいタスクでは、どれくらい待つかという問題から、結果を信頼できるかどうかという問題が変わります。 X ユーザーの Yum 氏は、新しいバージョンを試してみた後も、幻覚、特に複数のファイルにわたる再構築とアーキテクチャの変更が最も心配であると述べました。彼は、DeepSeek に自分のソリューションを承認させるのではなく、別のモデルに変更をチェックさせるでしょう。これは彼の使用方法の選択であり、GPT またはクロードの方が信頼性が高いことを証明するために同じ質問をテストしたものではありません。
したがって、現時点で最も確実な進歩は、DeepSeek の新バージョンが実際の小さなプログラミング タスクのバッチで主力モデルと同じ検査結果を提供したことです。
大規模なプロジェクトでは手動による修正がどれだけ必要になるか、問題を修復できるかどうかによって、この置き換えがどこまでできるかが決まります。
3D カーの構築と長期にわたるプロジェクトの維持の間には、まだ多くの作業が必要です。イブラギムは、このテストをさらに難しくする準備もしています。同氏は投稿の最後で、次のステップは、より困難なタスクのグループを選択し、さまざまなツールやモデルを比較することになると述べた。
コメント