
要約:
現地時間 11 月 9 日、Anthropic は Claude Fable 5.2 と Claude Mythos 5.2 をリリースしました。どちらも同じ基礎モデルを共有します。 Fable はすべてのユーザーが利用でき、サイバーセキュリティとバイオセキュリティ保護が組み込まれています。 Mythos はこれらの制限を取り除き、サイバーまたはライフ サイエンスの検証プログラムに合格した機関のみが利用できるようにします。
リリース後、誰もがほぼ同じ、より強く、より速くという説明をしました。一見すると価格設定が間違っていると感じる開発者もいます。コーディングの場合、Fable 5.2 は費用対効果が高くありません。ただし、Anthropic 自体はリリース ドキュメントの中で、ほとんどのコーディングと知識作業については「Claude Opus 5.5 から始める」ことが推奨されていると述べています。
史上最も強力なモデルは常に更新されていますが、それらを使用できる時間はあまり残されていません。 AI 企業は AGI に到達する前に、まず商用化の上限に達します。
最強の者はさらに強くなり続けていますが、デジタル ワークフォースのプロトタイプは出現しましたか?
まず、何が強いのかについて話しましょう。 FrontierCode 2.0 は、「オープンソース プロジェクトのメンテナーがモデルによって書かれたコードをマージする意思があるかどうか」をテストします。最高の計算能力レベルでは、Fable 5.2 は 49.1% を達成しましたが、前世代の Fable 5.1 は 32.4% を達成しました。
モデルが独立して完了できる実際のリモート作業タスクの数を測定するリモート労働指数は、17.9% から 41.3% へと 2 倍以上増加しました。
Anthropic には社内ロボット シミュレーション テストである RoboDojo Sim もあり、そのスコアは 27.6% から 64.9% に向上しました。ただし、この数値は企業の内部業務から得られたものであり、外部に再現することはできません。
次に弱点があります。また、AutomationBench の公式比較表では、Fable 5.2 の 51.4% が Google Gemini 4 Carbon の 53.9% に負けています。
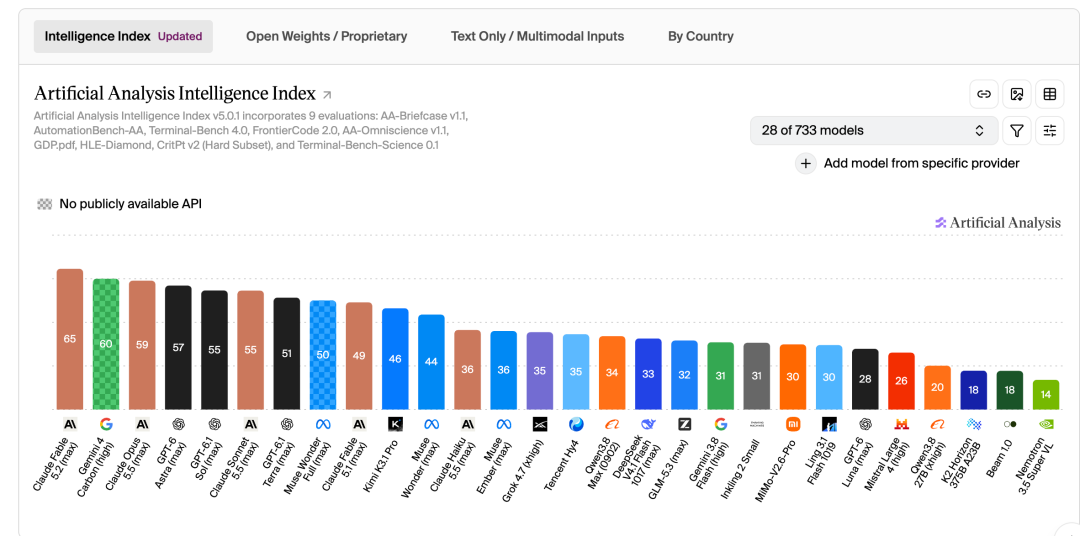
外部プラットフォーム Artificial Analysis のスマート リストでは、Fable 5.2 が 65 ポイントでリストのトップとなり、2 位の Gemini 4 Carbon の 60 ポイントを大きく上回り、4 位の GPT-6 astra に 9 ポイント差をつけられました。
どれくらい強いですか?一日以上で、人類の数学史における大きな偉業が直接完了しました。
30 時間以内に、フェルマーの最終定理の正式な検証が完了しました。さらに、ブラック ホールと量子重力に関連する物理学における 2 つの未解決の問題も解決されました。また、オペレーティング システムを完全に独立して動作させ、電子機器を独立して設計および製造し、複雑なアデノ随伴ウイルスのカプシド構造を予測することもできます...
寓話 5.2 は、AI が生産性ツールからエンジニアリング実行機能を備えたデジタル ワークフォースに移行していることを意味していると考える人もいます。
しかし、多くの開発者グループは、これは Anthropic がコーディングの方向で「終わりに達した」ことを意味するのではないかと考えています。いくつかの新しいトラックや新しいモデルを開発しなければ、投資家の認識を刺激することは困難になるだろう。そして今、アンスロピックがIPO価格設定に向けて全力で取り組む重要な時期と一致している。
価格ははるかに先を行っているため、Anthropic は使用しないことをお勧めします。
しかし、多くの開発者が Fable 5.2 の機能を試してみることに興奮したとき、価格設定に問題があることに気づきました。
Fable 5.2 の標準価格は、100 万トークンあたり入力で 8 ドル、出力で 40 ドルです。これは、前世代の 10 ドルと 50 ドルから 20% 下がったようで、出力速度は 5.1 よりも最大 30% 速くなります。速度が遅すぎる場合は、高速モードをオンにすると、速度が 2.5 倍になり、価格が 2 倍になります。インプットは 16 ドル、アウトプットは 80 ドルです。
直感的には、Artificial Analysis のタスクあたりのコストもはるかに優れています。
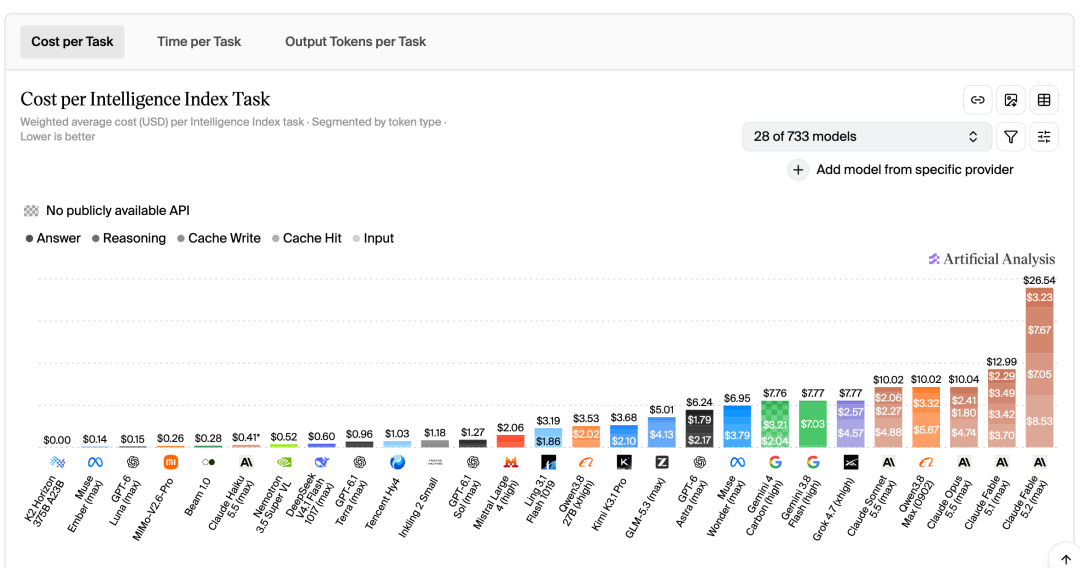
しかし、Anthropic 自体は、リリース資料に「コード精度とタスクあたりのコスト」の曲線を記載し、中程度のコンピューティング能力レベルでは、Fable 5.2 の 45.3% はすでに Opus 5.5 の最高レベルの 45.5% に近く、タスクを完了するコストは約半分にすぎないと結論付けています。
現在、人類関係者は賢い消費を測定する尺度を変更しました。過去 2 年間、業界の価格比較は、100 万トークンあたりのコストに基づいていました。今回は、完了したタスクごとにかかるコストに置き換えられました。 2 つの定規で測定した結果がまったく逆になる場合があります。トークン単価が 20% 安いモデルでも、正常に動作するまでにさらに 3 ラウンドかかる場合、コストが 2 倍になる可能性があります。
さらに、Anthropic の公式推奨では、「ほとんどのコーディングと知識作業については、Claude Opus 5.5 から始めることをお勧めします。」
現在の価格階層で比較すると、DeepSeek V4.1-Flash のコストは 100 万入力あたり 0.3 米ドル、100 万出力あたり 1.2 米ドル、Kimi K3.1 Pro のコストは 100 万入力あたり 2 米ドル、出力 10 米ドル、GPT-5.5 標準バージョンのコストは 5 米ドルと 30 米ドルです。 The Fable 5.2 が 8 ドルと 40 ドルでトップに立っています。
つまり、このモデルは開くたびに非常に高価になります。その価値は、毎日ではなく、重要な瞬間に一度開くことにあります。
これに関して、Anthropic は 2 つの新しい役割を割り当てました。一人はアドバイザーです。 Haiku、Sonnet、Opus などの安価なモデルは、問題が発生したときに尋ねるようになります。もう 1 つは、スケジューラである Orchestrator です。個人で行うのではなく、タスクを分割して以下の小さなモデルに割り当てます。
「最強よりも強い」はまだ更新されていますが、それはもはや最も重要ではありません
Anthropic 氏によると、エンジニアは Fable 5.2 に空のフォルダーを提供し、そのフォルダーが 1,000 以上のサブエージェントを調整して 8 日間継続的に実行し、最終的には独自のカーネル、ディスク、キーボード、ネットワーク ドライバー、ファイル ストレージ、ウィンドウ、ログイン インターフェイス、インストール プログラムを備えたラップトップで起動できるプロトタイプ オペレーティング システムを引き渡しました。
別のエージェント セットは、Anthropic 独自の運用サービスの 1 つを Python から Rust に移行しました。移行後の起動速度は約 26 倍速くなりました。
それはハードウェアにも関係しています。アンスロピック社は、回路基板メーカーのダイオードと協力して、家庭用音声アシスタント、USB会議スピーカー、手持ち型電子ペット(回路基板、筐体、ソフトウェアを含む)の3製品を設計したと述べた。ボードは、構築後に電気的な変更を加えることなく機能します。
数学的なサンプルはこれです。約 1,000 人のエージェントが、フェルマーの最終定理の既存の証明を、リーンが段階的に検証できる形式に変換するのに 30 時間もかかりませんでした。今年 9 月に同じことを行うには、11 日間、特別な足場、研究者からの十分な指導が必要でした。今回は、出力トークンの 3 分の 1 のみが使用され、証明の長さは元の長さの約 7 分の 1 でした。
これらのケースは誇示のように聞こえます。しかし、「1000 人のサブエージェント」を「1000 人の部下」に置き換えると、これは実際にはモデルではなく組織構造を表していることがわかります。
業界関係者は、トップモデルの競争は収束、つまり価格の収束とデータの収束が完了したと考えています。次のステップは間違いなく「アプリケーション」段階であり、モデルの機能の上限と価格の下限が同時に実行されます。これは、AI をさまざまな差別化された探査に使用できることを意味します。その頃までに、模型メーカーにとっての競争は、ハーネス、メモリ、ユーザーの習慣などの側面になるでしょう。
現時点では、大手模型メーカーが調整を進めていることがわかります。たとえば、DeepSeek と OpenAI も同じ機能セットを完成させつつあります。
今年 8 月、DeepSeek は MIT ライセンスの下で DeepSeek Harness をオープンソース化しました。 10 月 17 日に DeepSeek が V4.1-Flash-1017 をリリースしたとき、新しいモデルが DeepSeek Harness、Tencent CodeBuddy、WorkBuddy などのインテリジェント製品に最適化されていることを明らかにしました。そしてハーネスチームのCui Tianyi氏は大規模に人材を採用している。 Ifeng Technologyは以前、Liang Wenfeng自身が「この分野でも優れている」と業界関係者から聞いた。
同じく 11 月 5 日、Kimi は、Harness as a Service を正式に提案する Kim Hosted Agents (ホスト型エージェント) をリリースしたばかりです。
同日、Anthropic で Claude Code 製品の責任者であった Cat Wu が OpenAI に入社し、コア製品チームの製品管理を担当しました。彼女は、Claude Code を社内プロトタイプから広く使用される商用製品まで推進することに携わり、その後短期間 Cursor に加わりました。
Claude Code は、AI プログラミング市場における Anthropic の最も代表的な製品の 1 つです。 Cat Wu は、製品の構想から商品化までのプロセスにおいて直接の経験を持っています。 OpenAI による彼女の採用は、明らかに Codex およびより広範な Agent 製品の機能を強化することを意味します。
実際、Fable 5.2 のリリースの直前に、Gemini の新モデルとされるものが「リーク」されました。ユーザー @chetaslua は、「時間が 2 倍かかり、コードの量も 2 倍になる」とコメントしました。これは、Google 内でコード名「クリプトン」と呼ばれる Gemini 4 の新しいチェックポイントです。コード生成ビジュアルや3Dシーンのパフォーマンスは、新発売のカーボンを大幅に上回るという。そのため、上位モデルのリフレッシュ速度は高速化しています。 RSIが原因だと考える人もいますが、そうでなければ説明のしようがありません。
そこで質問が来ます。知性がもはや問題ではないとしたら、競争力とは何でしょうか?次回の模型コンテストはどうなるでしょうか?答えはすぐに明らかになるでしょう。
コメント