
要約:
コミュニティ開発者によって主導された新しい調査では、NVIDIA GeForce RTX 30 シリーズおよび RTX 40 シリーズ グラフィックス カードには、公式仕様をはるかに超えるコンピューティングの可能性が隠されていることが示されています。基盤となるファームウェアとハードウェア構成のロックを解除することで、開発者は当初制限されていたコンピューティング能力の一部を解放することに成功し、一部のモデルで人工知能とマトリックス コンピューティングのシナリオで最大 2 倍近くのパフォーマンス向上を達成できるようになりました。
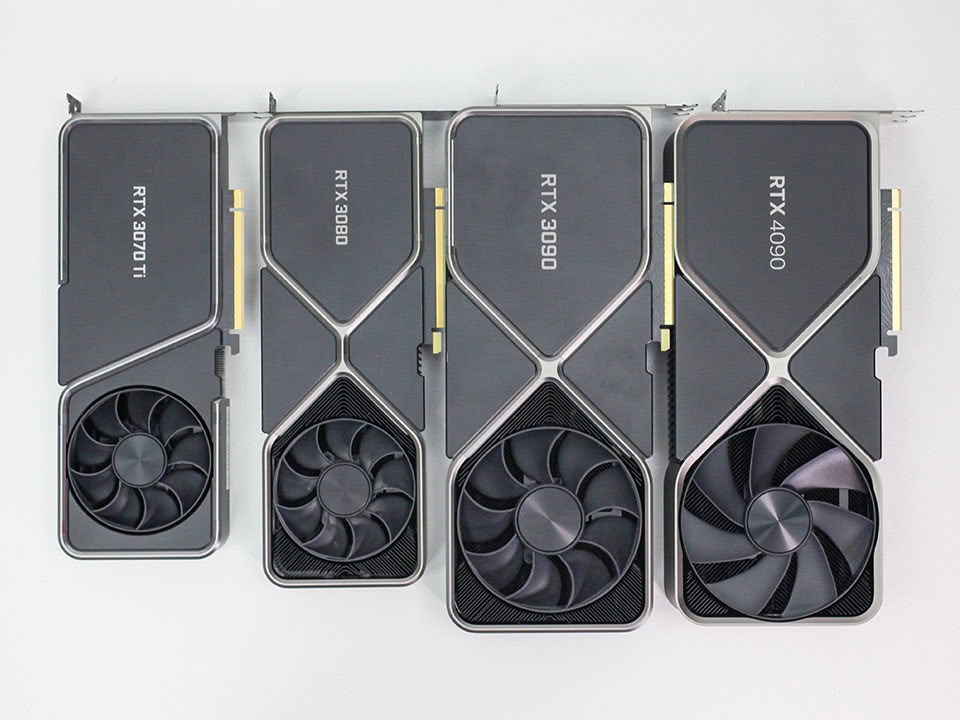
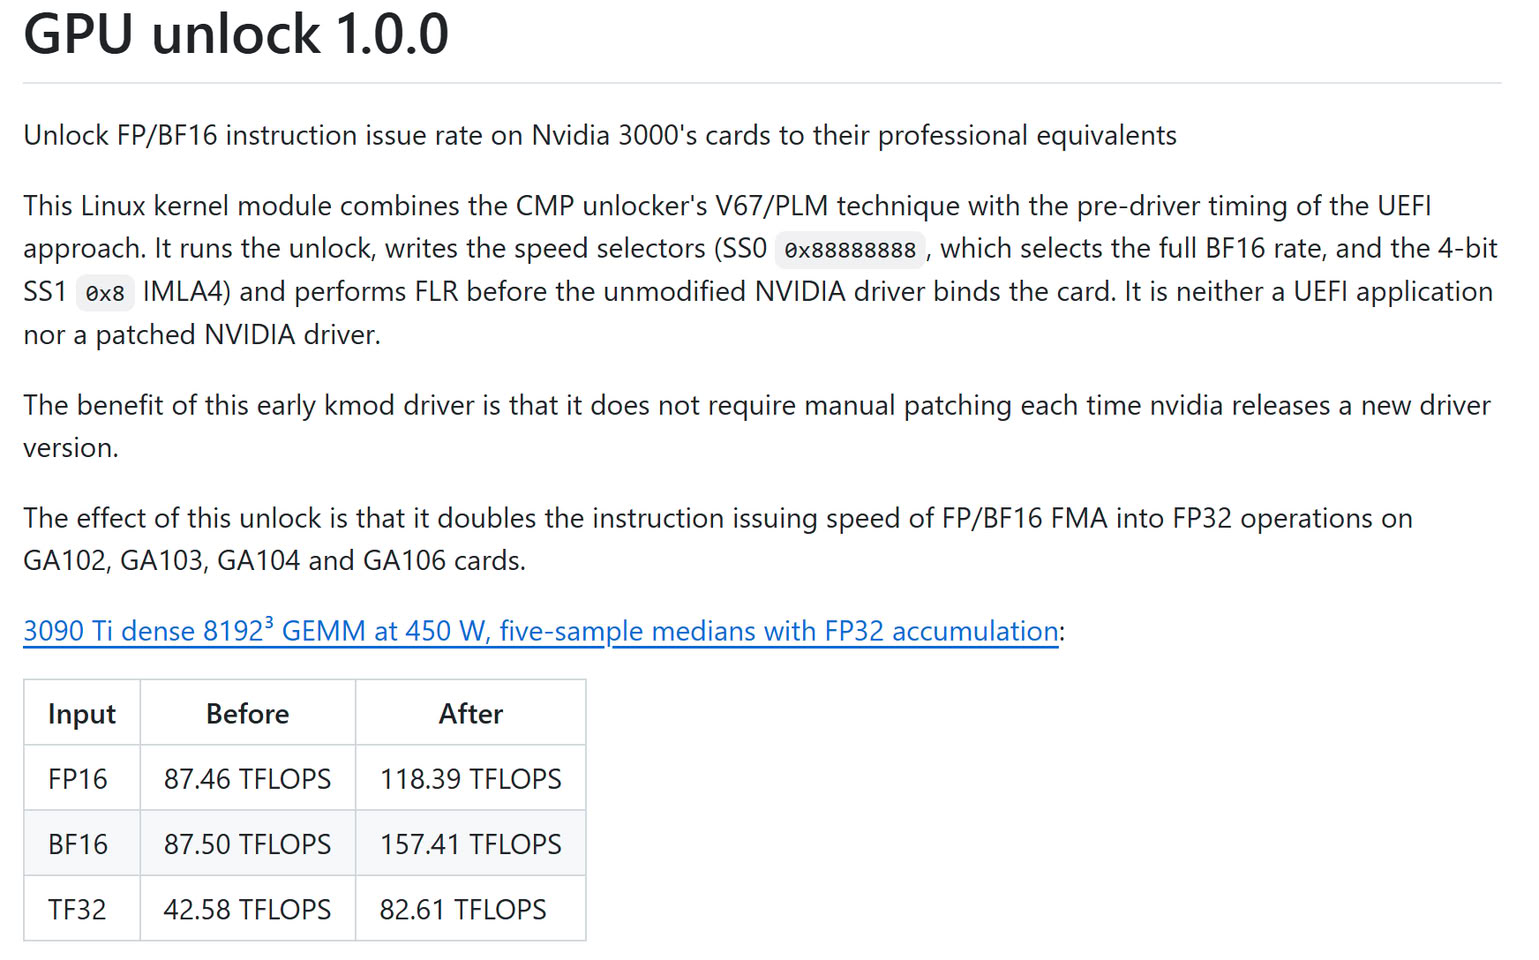
レポートによると、RTX 30 シリーズの「Ampere」アーキテクチャ グラフィックス カードで使用されているコアは、本質的に NVIDIA のプロフェッショナル グレードの GPU と同じシリコンです。ただし、コンシューマ グレードの製品のコンピューティング機能の一部は、ソフトウェアおよびファームウェアのポリシーによって制限されています。研究者によって開発されたロック解除ソリューションは、FP/BF16 FMA から FP32 動作までの命令発行レートを向上させることができ、GA102、GA103、GA104、および GA106 コアに適しています。
実際のテストでは、RTX 3090 Ti の BF16 行列乗算のパフォーマンスが最大約 80% 向上しました。行列乗算はほとんどのニューラル ネットワーク モデルを実行するための重要な基本操作であるため、この改善はローカル AI 推論および機械学習タスクにとって明らかに重要です。
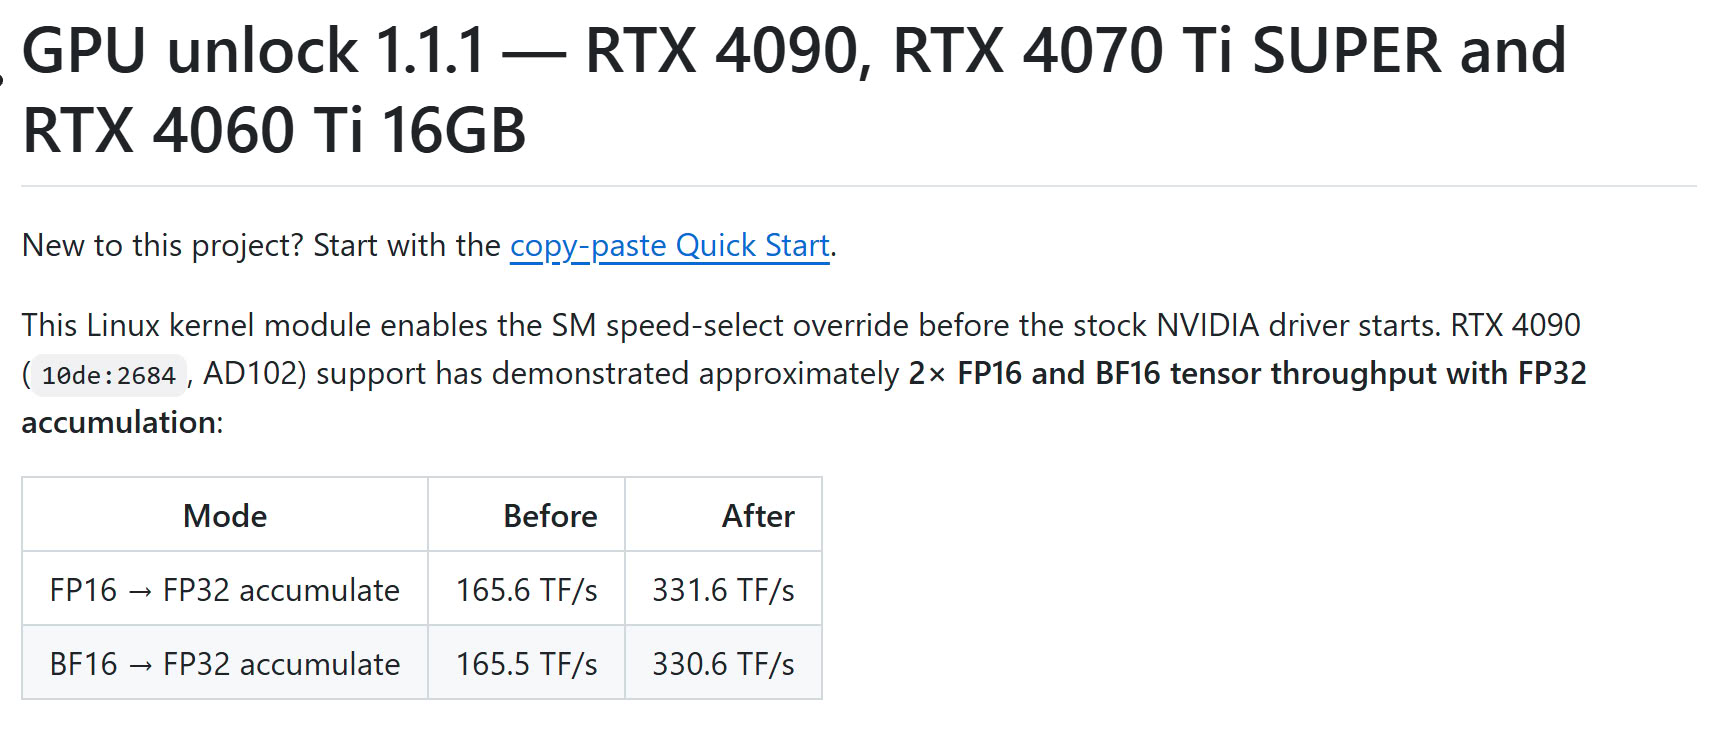
同時に、RTX 40 シリーズ「Ada Lovelace」アーキテクチャの別のロック解除プロジェクトもブレークスルーを達成しました。このソリューションは、FP32 の累算精度を維持しながら、FP16 および BF16 Tensor の約 2 倍の計算スループットを達成します。
RTX 4090 を例に挙げると、FP16 Tensor スループット テストでは、グラフィックス カードは元々 165.6 TFLOPS に達する可能性がありましたが、ロック解除を有効にした後、パフォーマンスは 331.6 TFLOPS に向上し、ほぼ 2 倍になりました。このレベルは、RTX 6000 Ada などの一部のプロフェッショナル グレードの製品のコンピューティング能力に近いか、それに達することさえあります。
研究者らは、これは AD102 コアが消費者向け製品、特に行列の乗算や累算などの主要な AI コンピューティング領域において人為的コンピューティングの制限があることを示していると考えています。これらの制限は、大規模な言語モデルなどの AI アプリケーションの動作効率に直接影響します。現在、ロック解除プロジェクトは AD102、AD103、AD106 コア モデルをサポートすることが確認されています。
RTX 30 シリーズと RTX 40 シリーズ用の 2 つのロック解除ソリューションがほぼ同時に登場し、それぞれ Ampere と Ada Lovelace の 2 世代の GPU アーキテクチャをカバーしていることは注目に値します。開発者は、これらの変更により、NVIDIA ドライバーの完全な検証メカニズムを通過し、PCIe 機能レベル リセット (FLR) 制限を回避できると述べました。したがって、公式のオリジナルドライバーは引き続き使用でき、CUDA 関連のテストソフトウェアは正常に実行できます。
テスト データは、GA102 および AD102 グラフィックス カードの両方が、ロック解除の前後で同じ電力消費制限を維持していることを示しています。たとえば、ボードの合計消費電力が 450 W に設定されている場合、パフォーマンスの向上は、消費電力や周波数がさらに増加するのではなく、解放されたコンピューティング パワーによってもたらされます。
ローカルの大規模言語モデル、生成 AI、その他の高強度のコンピューティング タスクを使用するユーザーの場合、追加リリースされた Tensor コンピューティング能力により、プロンプト ワードの前処理と推論ステージの効率が向上し、それによってより高いトークン スループットとより速い応答速度を実現できます。
ただし、開発者は、そのような変更は非公式であり、グラフィックス カードの保証が無効になる可能性があることも注意しています。さらに、NVIDIA ドライバーが GPU を引き継ぐ前にロック解除操作を完了できるように、システム起動フェーズ中に関連モジュールを最初にロードする必要があります。したがって、このタイプのソリューションは、一定の技術的能力を持ち、リスクを負うことをいとわない上級ユーザーにより適しています。
コメント