
要約:
今朝、SpaceXAI の最も強力なモデルである Grok 4.7 が到着しました。リリース ページの冒頭には非常に「攻撃的な」ポジショニングが 1 つだけあります。それは、プログラミングと知識作業に最も強力なモデルで、同等のモデルに比べて 2 倍の速度で、価格はわずか半分です。
このアップグレードはベンチマークにとどまりません。 Grok 4.7 は、より大規模な基本モデルに切り替え、長期的なタスク、自己検査、および長期的なコンテキストの管理機能を強化し、文書、プレゼンテーション、法律、医療、工学、その他の専門的な作業を主要なテストに組み込みます。対象とするシナリオは非常に明確です。つまり、モデルが数時間かかるタスクの迂回路を回避し、直接使用できる結果を提供できるようになります。
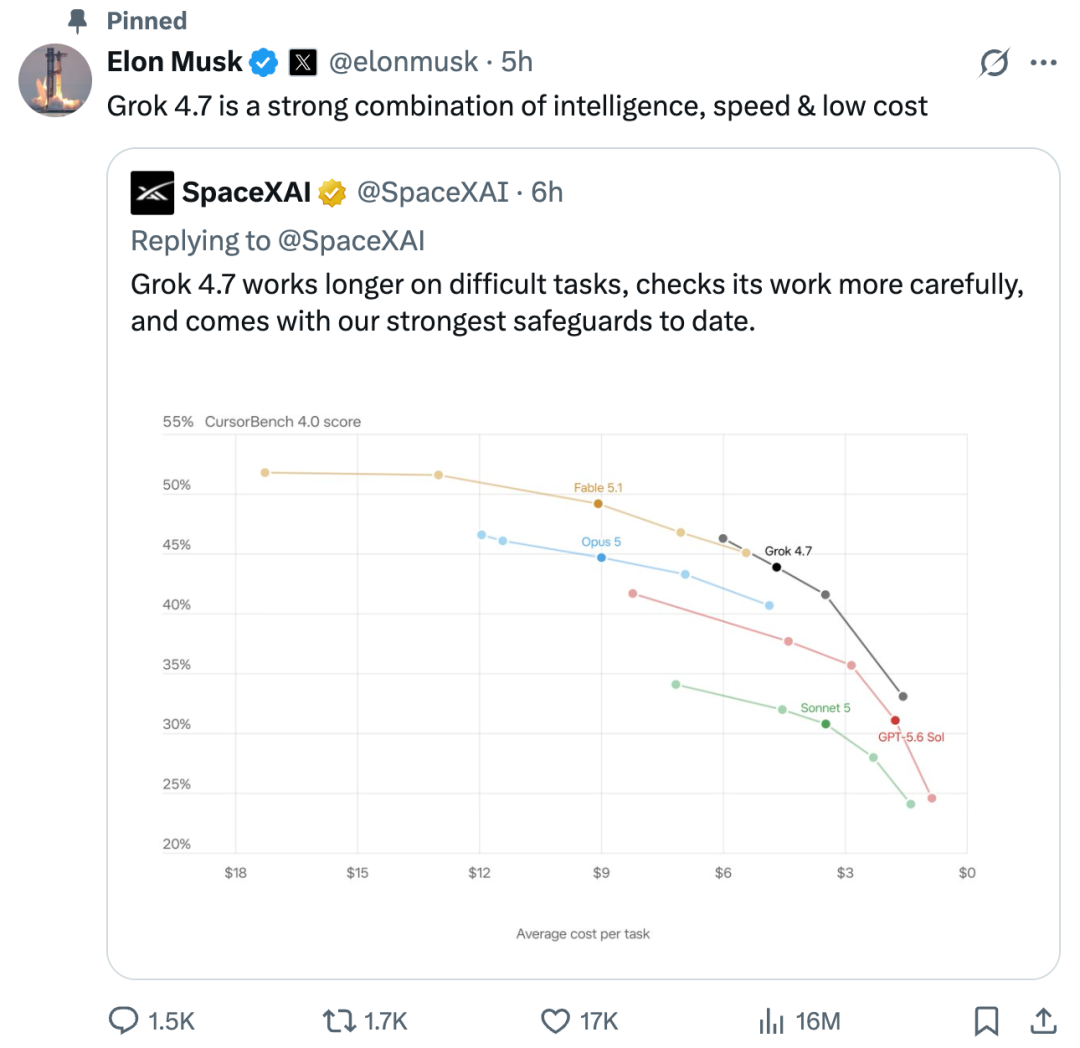
マスク氏はツイートした、「Grok 4.7 は、インテリジェンス レベル、動作速度、コストの間で非常に競争力のあるバランスを実現しています。」
長いミッションがこの世代のモデルの主戦場となっています
Grok 4.7 は、Grok 4.6 よりも大きな基本モデルを使用します。トレーニングフェーズでは強化学習期間が延長され、タスクの組み合わせがより難しくなり、完了までに数時間かかるサンプルが増加します。 SpaceXAIは、新しいモデルは自身の作業を検査し、長いコンテキストを管理する能力が向上したと述べた。
この種の改善は、現在プログラミングされているインテリジェント エージェントの最も困難な問題に直接対応します。短いコードの生成では、部分的な判断しか必要としないことがよくありますが、本当に複雑なソフトウェア タスクには、ウェアハウスの読み取り、要件の解体、複数のファイルの変更、テストの実行、および繰り返しのエラー修正が含まれます。モデルが目標を維持し、長い実行チェーンでエラーを検出できるかどうかは、多くの場合、美しいコードを一度に書くことよりも重要です。
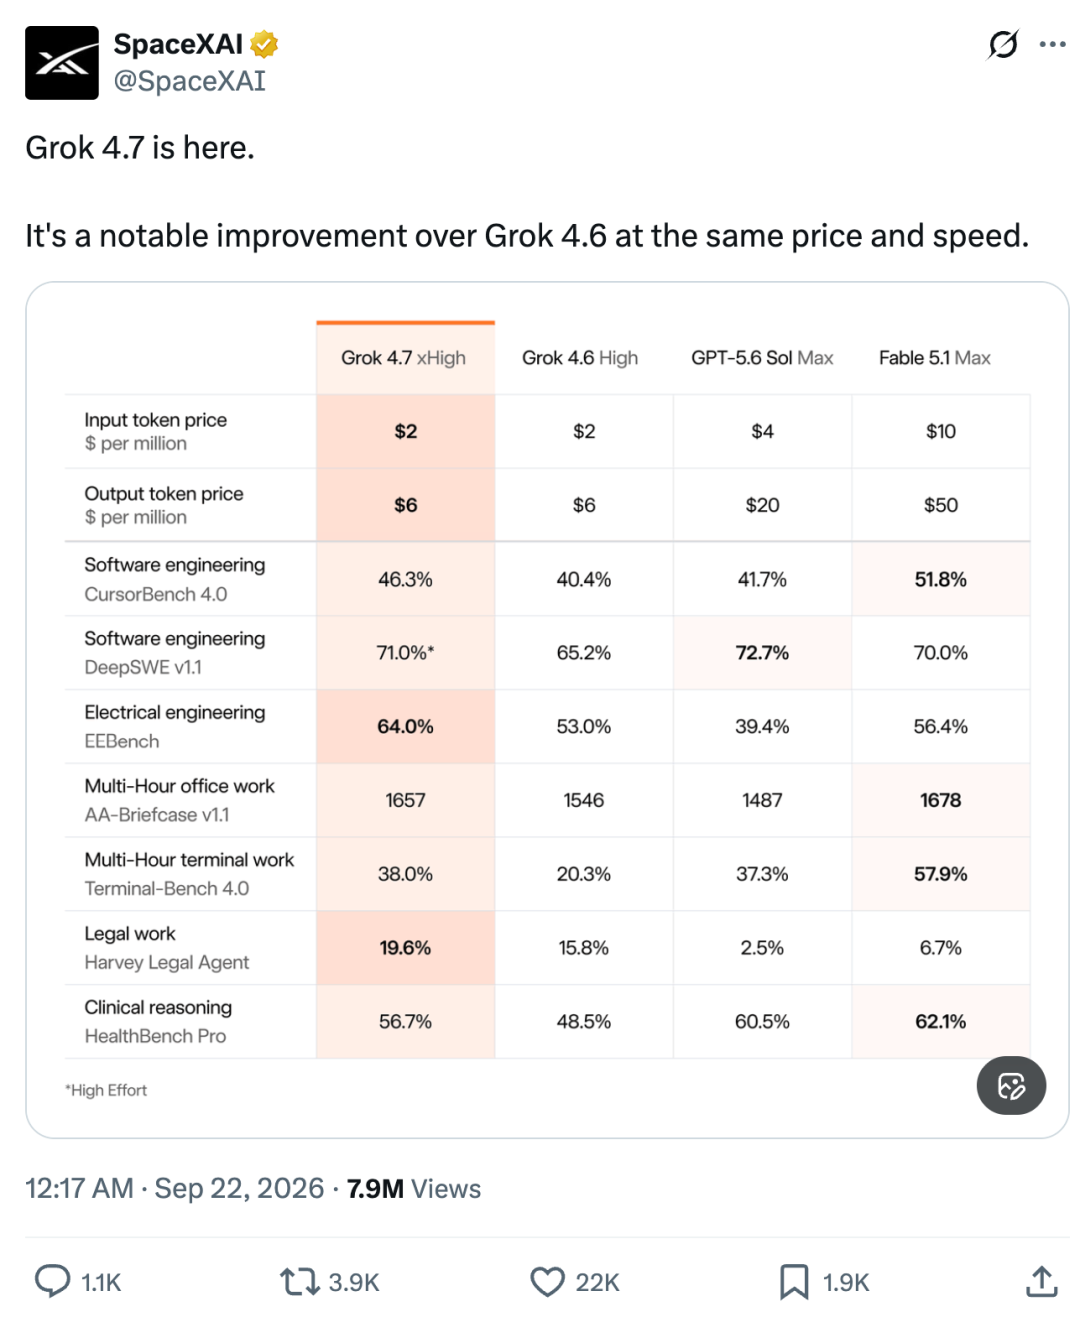
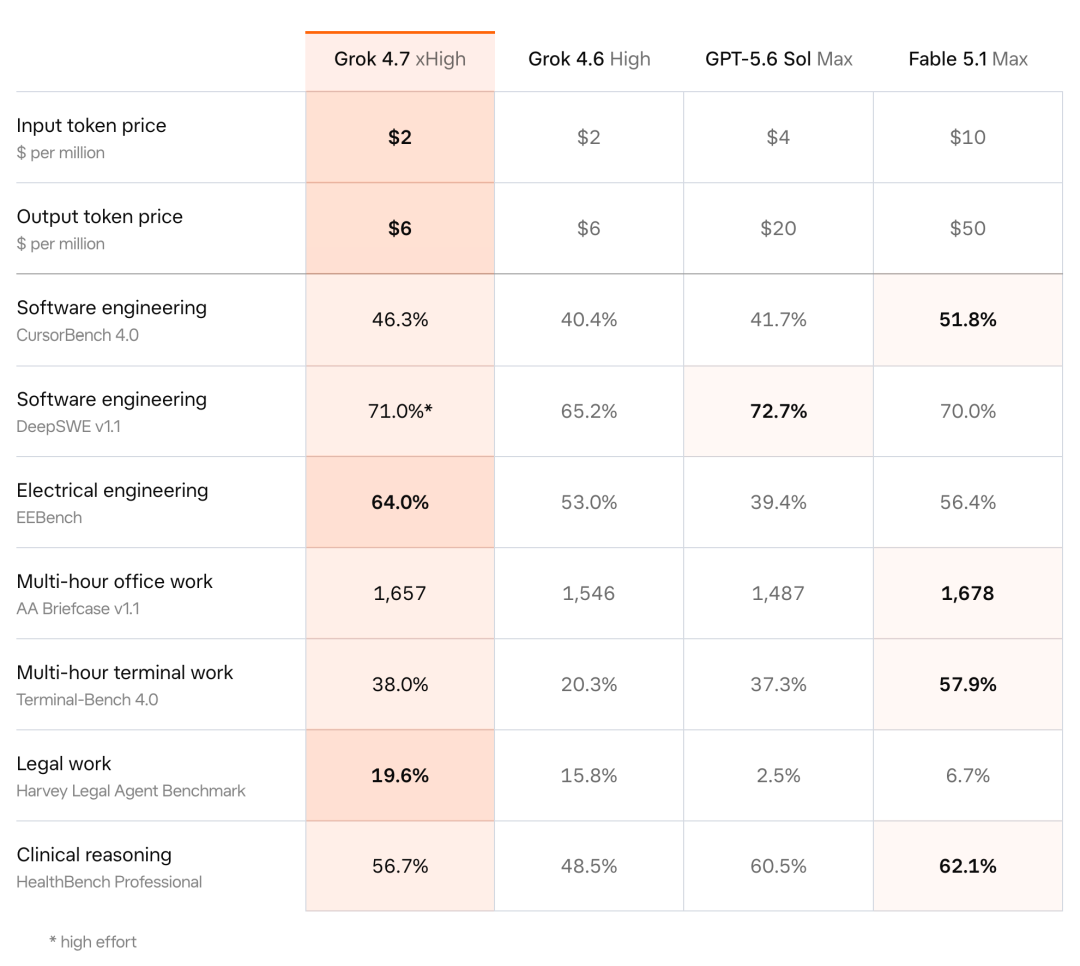
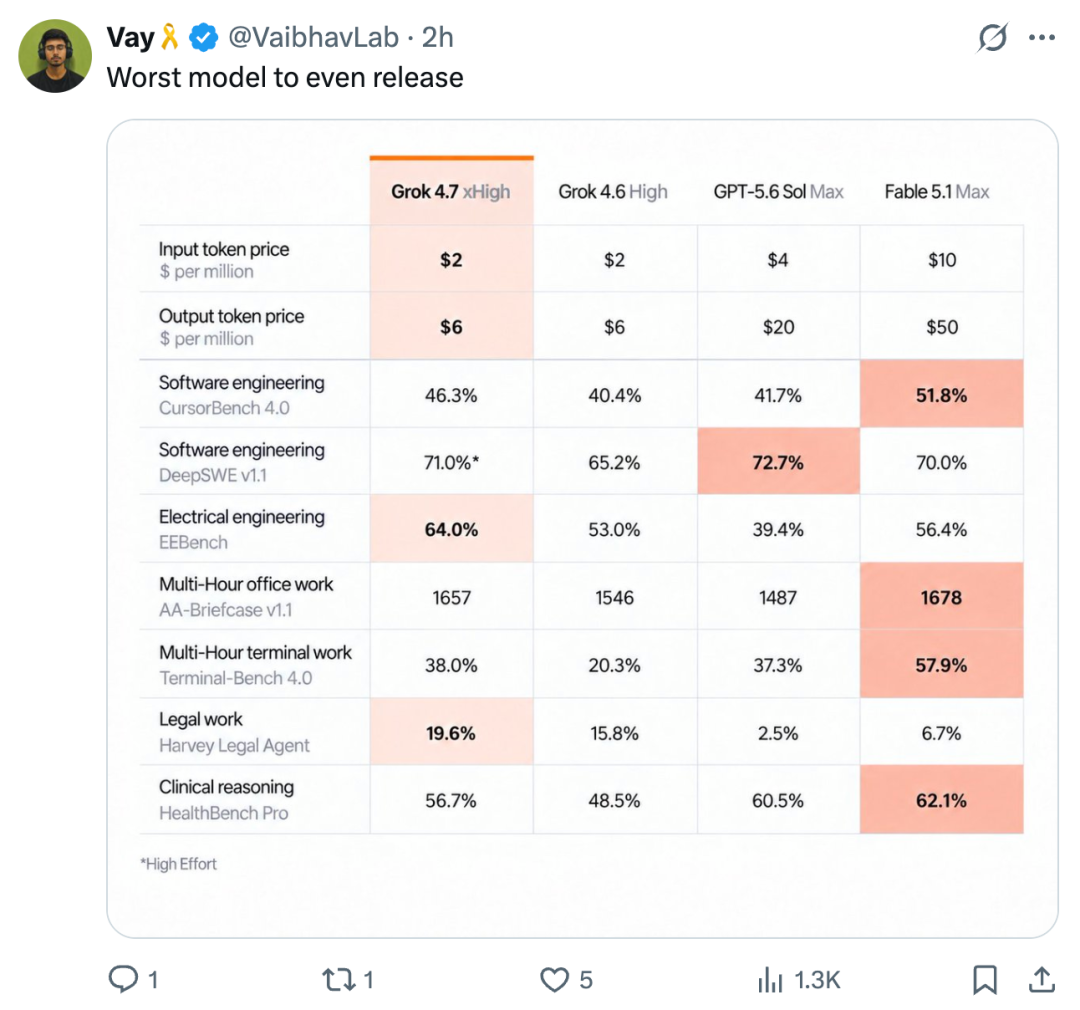
CursorBench 4.0 は、特に長期にわたるコーディング タスクを検査します。公式データでは、Grok 4.7 のスコアは 46.3%、Grok 4.6 のスコアは 40.4% で、5.9 ポイント増加しました。 DeepSWE v1.1 では、Grok 4.7 の高推論強度スコアは 71.0% でした。 Terminal-Bench 4.0 は、前世代の 20.3% から 38.0% に増加しました。
したがって、Grok 4.7 は、CursorBench 4.0 の最先端の価格およびパフォーマンス モデルと呼ばれています。
モデルは、Grok Bot が実行されるフレームワークをネイティブに理解するようにトレーニングされています。公式には、この調整により対話タスクと一般知識タスクのパフォーマンスが向上します。言い換えれば、Grok 4.7 のアップグレードの焦点は、単一ラウンドの回答から、モデル、ツール、実行環境間の継続的なコラボレーションにまで広がりました。
コードの作成から完全な知識作業まで
Grok 4.7 で最も注目を集めるのは依然としてプログラミングですが、SpaceXAI によって与えられる評価の範囲は大幅に広がります。 AA Briefcase と GDPval は、専門家が毎日行う複数段階の作業に焦点を当てており、弁護士、看護師、金融アナリストなどの職種の一般的なタスクや、文書やプレゼンテーションの作成をカバーしています。
AA Briefcase v1.1 では、Grok 4.7 は 1657 ポイントを獲得し、Grok 4.6 の 1546 ポイントを上回りました。 GDPval Elo スコアは 1605 から 1695 に増加しました。公式チャートでは、GDPval における Fable 5.1 の 1735 ポイントに近く、GPT-6 Astra の 1542 ポイントよりも高くなります。 SpaceXAI は、Grok 4.7 は両方のテストで前世代を上回り、全体的なパフォーマンスは他の最先端モデルと同等であると結論付けました。
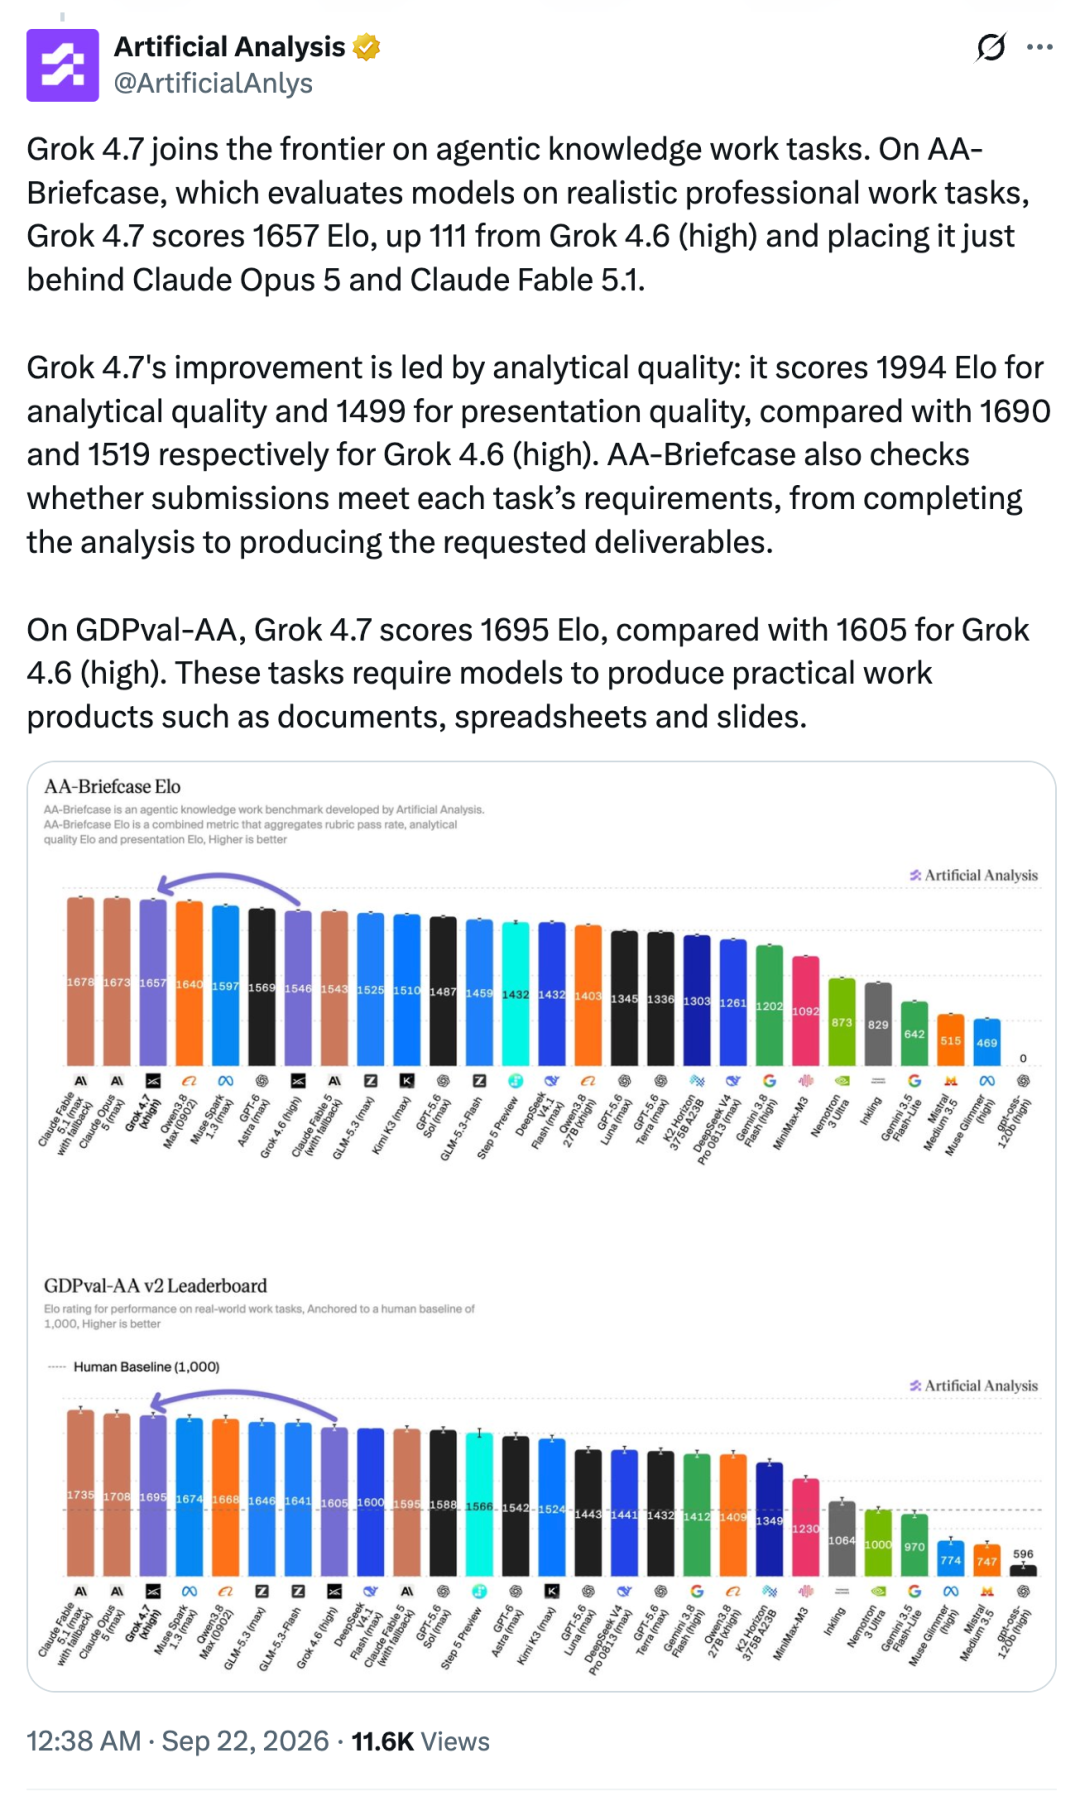
専門分野における昇進もさまざまな方向で行われます。 EEBench スコアは 53.0% から 64.0% に増加し、Harvey Legal Agent Benchmark は 15.8% から 19.6% に増加し、HealthBench Professional は 48.5% から 56.7% に増加しました。これらの結果は、SpaceXAI が公開した内部比較表から得たもので、新旧世代のモデル間の変更を示すことができます。モデル間の比較は、推論強度、ツール構成、テスト環境の影響を受けます。
この一連の結果は、明確な傾向を明らかにしています。最先端のモデルをめぐる競争は、「すべての仕事を完了する」段階に入りつつあります。
モデルはタスクを理解し、ツールを呼び出し、ファイルを生成し、それ自体をレビューする必要があります。単一の質問と回答機能はその一部にすぎません。 Grok 4.7 は、トレーニング タスクの期間を延長し、自己検証を強化します。これがまさにこのタイプのワークフローを補うものです。
安全性と価格
Grok 4.7 では、機能の向上に加えて、新しいセキュリティ保護システムが有効になりました。 SpaceXAIは、これが応答拒否と脱獄に対する耐性の点で最も強力な性能をテストしたモデルであると述べた。
バイオセキュリティ テストに関しては、Grok 4.7 が 62.4% のスコアで LatchBio ベンチマークを上回りました。サイバーセキュリティ テスト HackerBench v0.3 では、主に高リスクで悪意のあるタスクを対象としています。公式データによると、このモデルは高リスクの二重用途ヒントの 3.3% のみをリリースし、通常のセキュリティ調査リクエストを誤ってブロックすることはほとんどありません。
SpaceXAI はまた、防御研究のために限られた数のサイバーセキュリティ パートナーに招待制のレッド チーム機能を開放し始めました。現在、このレッド チーム機能は、最初は制御されたコラボレーションとして利用可能です。
標準バージョンは元の価格で継続され、高速バージョンの速度は 2 倍になります
Grok 4.7 は Cursor および Grok Build でリリースされ、Grok API、サードパーティのプログラミング フレームワーク、モデル ルーティング サービス、およびクラウド プラットフォームを通じて提供されます。標準バージョンは、Grok 4.6 と同様に、入力トークン 100 万あたり 2 ドル、出力トークン 100 万あたり 6 ドルから始まります。
価格戦略により、このアップグレードの影響力がさらに高まります。開発者は、アップグレードのために追加の標準バージョン トークンのコストを支払う必要はありませんが、より強力な長期的なタスク パフォーマンス、自己検査機能、専門的な作業結果を得ることができます。
プログラミング エージェントやナレッジ ワーク製品の場合、各モデル コールの単価は当然重要です。タスクを完了するために必要な試行回数と再作業の回数によって、最終的に実際のコストが決まります。
最後にこのアップグレードを要約します。
Grok 4.7 は、トレーニング方法から評価の組み合わせに至るまで、すべて同じこと、つまり長時間タスクに留まり、複雑なタスクを完了することを強化します。プログラミングは、成熟した最初のエントリ ポイントにすぎません。文書化、プレゼンテーション、法的分析、臨床推論、エンジニアリングのタスクが同じ一連の機能に組み込まれています。
しかし、ネチズンはそれを買わないようです。 「このモデルは実際にあえてリリースしました。あまりにもひどいのでリリースすべきではありません。」今回のGrok 4.7のセールスポイントは競合製品を完全に潰すことではない、と敬意を表してしか言えない。個々の専門的なタスクに非常に近い、優れたパフォーマンスと引き換えに、一部の主力モデルよりもはるかに低い API コストを使用します。
参考リンク:
https://x.ai/news/grok-4-7
https://x.com/ArtificialAnlys/status/2102074904560771365
コメント