
要約:
AMD は、FSR 4 の適用範囲をさらに拡大しています。AMD コンピューティングおよびグラフィックス部門のシニア バイス プレジデントである Jack Huynh 氏は、最近、同社が 2026 年末までに、より多くの APU、ゲーミング ラップトップ、およびハンドヘルド ゲーム PC を FSR 4 で正式にサポートする予定であることを韓国メディアに明らかにしました。これは、現在主に独立型グラフィックス カードを対象としている機械学習超解像度テクノロジが、統合型グラフィックス カードや低電力ゲーム デバイスの分野にもさらに参入することを意味します。
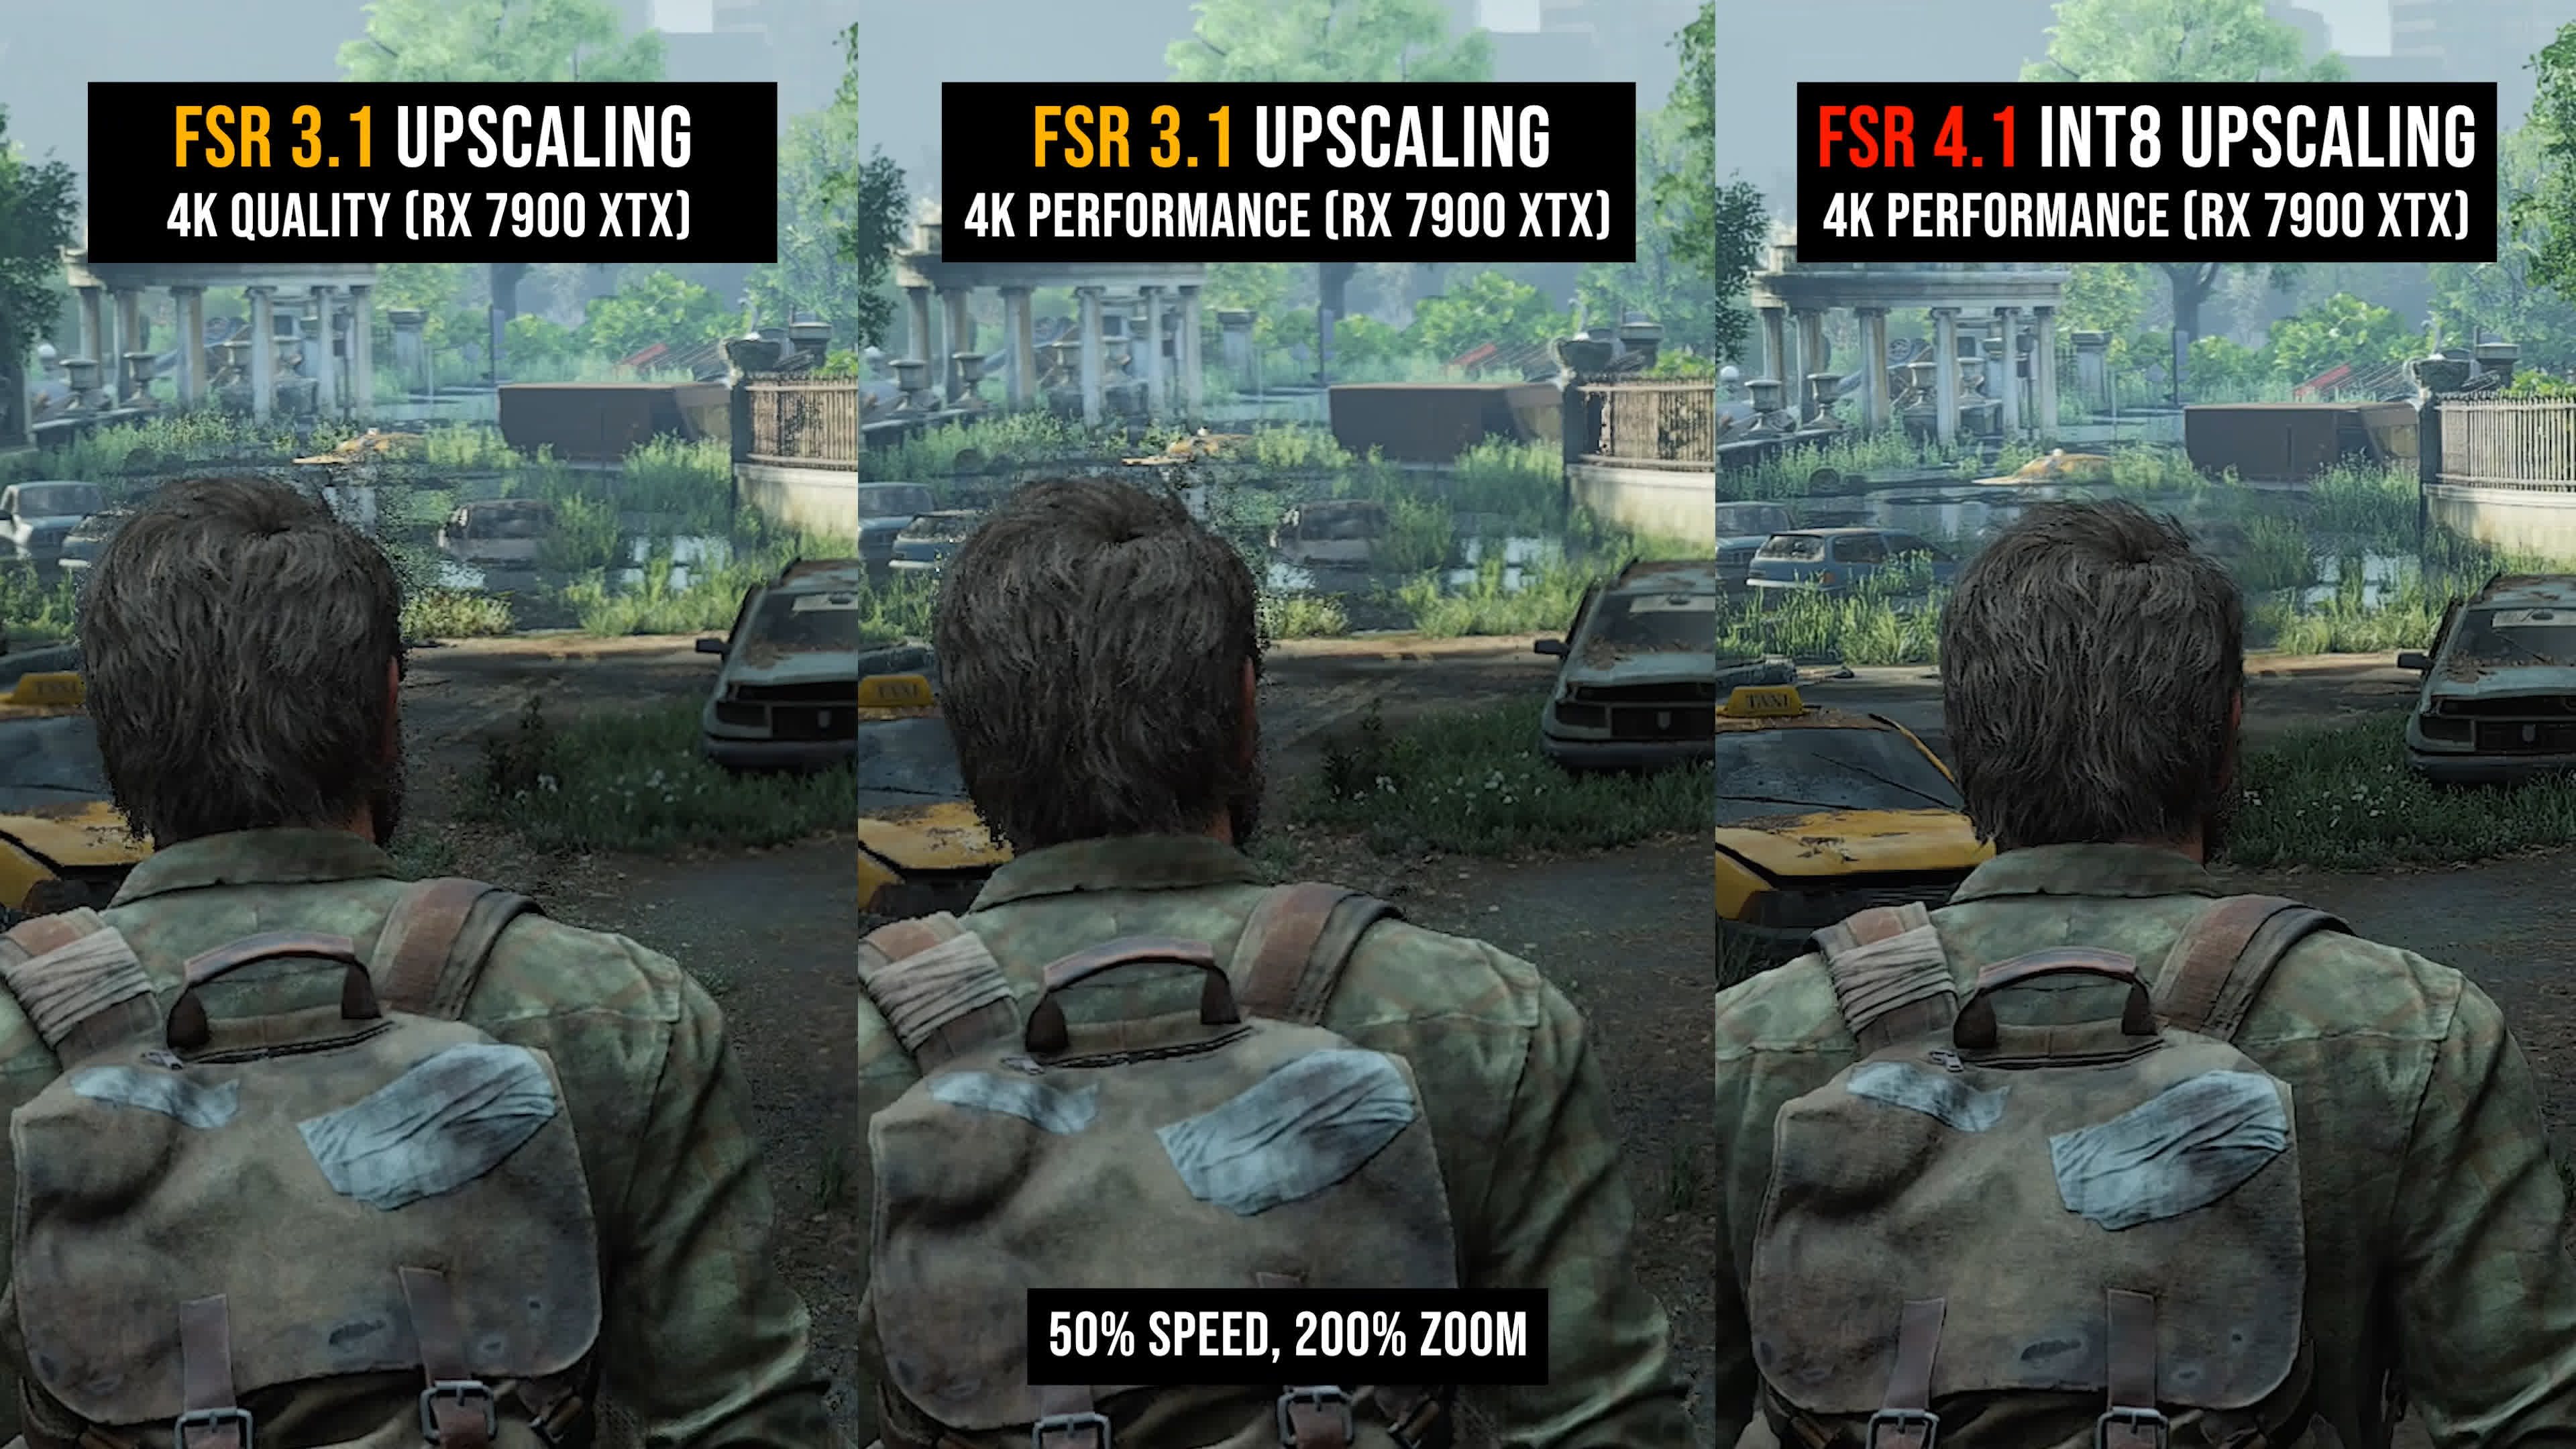
FSR 4 は、機械学習に基づいた AMD の新世代の画像超解像度テクノロジーです。その基本原理は NVIDIA の DLSS と似ています。ゲームは必ずしもターゲット解像度で画像を完全にレンダリングする必要はありません。代わりに、最初に低解像度でレンダリングし、次にアルゴリズムを使用して高解像度の画像を再構築することで、画質を可能な限り維持しながら、GPU に対する実際のレンダリングの負荷を軽減します。
FSR 4 は当初、独立したグラフィックス カードの Radeon RX 9000 シリーズである AMD RDNA 4 アーキテクチャをターゲットにしていました。従来のアルゴリズムに依存していた以前の FSR と比較して、FSR 4 では機械学習推論が導入されているため、動的オブジェクト、詳細、時間的安定性などの問題をより適切に処理できるようになります。
今年 6 月、AMD は、RDNA 3 アーキテクチャに基づく Radeon RX 7000 シリーズ グラフィックス カードに FSR 4 の軽量バージョンを導入しました。 RDNA 3 は RDNA 4 とまったく同じ機械学習ハードウェア機能を備えていないため、AMD はモデルを調整し、元の FP8 計算をより広く利用可能な INT8 計算に変更して、動作要件を削減しました。
今回は、APU およびハンドヘルド コンソール用のバージョンがさらに軽量になります。 AMD は、限られたコンピューティング リソースを持つ APU で機械学習の超解像度を実行できるように、統合グラフィックスのパフォーマンス制限に対して特に最適化された FSR 4 モデルを開発しています。
これはハンドヘルド ゲーム PC にとって特に重要です。現在市販されている Windows ハンドヘルド マシンの多くは、ASUS ROG Ally X、Lenovo Legion Go、GPD Win などのデバイスを含め、AMD Ryzen シリーズ APU を使用しています。これらの製品の GPU 部分は、デスクトップ独立型グラフィックス カードと比較してパフォーマンスが限られているため、ゲームのフレーム レートを向上させるために超解像度テクノロジに大きく依存しています。
これらのデバイスで FSR 4 が正式に実行できる場合、プレーヤーは、より低い内部レンダリング解像度を使用して、より高い解像度に近い視覚効果を得ることができ、それにより、約 15 W ~ 30 W の消費電力範囲内でより高いゲーム パフォーマンスを得ることができます。
AMD は、Ryzen AI Max などの APU 製品へのサポートを拡大することも計画しています。これは、強力な統合 GPU を搭載した薄型軽量ノートブックにも当てはまります。これらのデバイスには、多くの場合、個別のグラフィックス カードが搭載されていませんが、最新の 3D ゲームを実行するのに十分な統合グラフィックス処理能力があるためです。
AMD は今回、FSR 4 をサポートする新世代の APU を 2026 年に発売することも明らかにしました。このニュースにより、新世代の Ryzen ハンドヘルド プロセッサに関する憶測がさらに高まりました。
いわゆる Ryzen Z3 および Ryzen Z3 Extreme に関する関連情報が最近明らかになりました。報道によると、この 2 つのチップは RDNA 3.5 と RDNA 4 の間のグラフィックス アーキテクチャを使用し、RDNA 4 の機械学習機能と RDNA 3.5 の基本設計を組み合わせている可能性があります。
関連レポートによると、Ryzen Z3 シリーズには 12 個の GPU コンピューティング ユニットがあり、4 個の Zen 6 CPU コアと 2 個の低電力 Zen 5 コアが組み合わされている可能性があります。通常版のZ3は消費電力が約15Wに最適化されていると言われているが、Z3 Extremeでは消費電力が約25Wに増加する可能性がある。
ただし、これらの仕様はまだリークであり、AMD によって正式に確認されていないため、最終的な製品パラメータとみなされません。いわゆる「RDNA 4m」アーキテクチャも、主に以前の Linux ドライバーの関連情報に基づいています。 AMDはまだ完全なモバイルRDNA 4製品アーキテクチャを公開していません。
同時に、「Gainsborough」というコードネームのチップも最近のサプライチェーン情報に登場しました。一部の予想屋は、前述の新世代APUと同じアーキテクチャを採用しているのではないかと考えており、将来的にはSteam Deck 2に採用されるのではないかと推測している。ただし、現時点では、Gainsborough が次世代 Steam Deck のコアチップであるという信頼できる証拠はありません。
Steam Deck で使用される AMD APU は、常に特別な内部コード名を使用してきました。例えば、初代スチームデッキでは「エアリス」、スチームデッキOLEDでは「セフィロス」が使用されていました。これらのコードネームは実際には Valve ではなく AMD から来ています。したがって、類似のコードネームが存在するだけでは、特定のチップが Steam Deck 2 のプロセッサであることを証明することはできません。
さらに、現在、互換性に関する重要な問題が発生しています。 Steam Deck は RDNA 2 アーキテクチャを使用しているため、AMD が今年末に FSR 4 をより多くの APU やハンドヘルド コンソールに拡張したとしても、既存の Steam Deck がすぐにサポートされることを意味するものではありません。
現在のルートによると、RDNA 3 以降のアーキテクチャを搭載したデバイスが最初に FSR 4 を受け取ることが予想されますが、RDNA 2 のサポートは 2027 年まで待たなければならない可能性があります。このスケジュールが変更されない場合、Steam Deck、通常の ROG Ally、および RDNA 2 を使用する他の一部のデバイスは待たなければならない可能性があります。
AMD は、将来的に機械学習超解像度のハードウェア対応範囲をさらに拡大することを明らかにしました。 AMD の最新の製品ルートによると、FSR アップスケーリング 4.1 はすでに RX 7000 および RX 9000 シリーズをサポートしていますが、RDNA 2 の機械学習超解像度サポートは 2027 年に開始される予定です。
AMD は、FSR 4 の製品名を段階的に変更し始めていることに注意してください。FSR テクノロジーが単純な超解像度から、フレーム生成、光再構成、放射線キャッシュなどの複数の機械学習機能に拡張されるにつれて、AMD は現在、テクノロジー システム全体を FSR 「レッドストーン」と呼んでいますが、元の FSR 4 は段階的に FSR アップスケーリングという名前に変更されています。
ハンドヘルド市場にとって、この変更は非常に重要になる可能性があります。携帯型ゲーム機の主な矛盾は常に、パフォーマンス、画質、消費電力の間のバランスでした。 GPU スケールを直接増やす場合と比較して、機械学習によって実際のレンダリング負荷を軽減することで、消費電力を大幅に増加させることなく、最終的な画質とフレーム レートを向上させることができます。
特に、高解像度の画面がハイエンドのハンドヘルド コンソールの標準になってからは、FSR などのテクノロジーの価値はさらに高まるでしょう。たとえば、ハンドヘルド コンソールは、約 720p または 800p の内部解像度でレンダリングするだけで済み、その後 FSR を通じて 1080p 以上に再構築することで、GPU がフルネイティブ解像度でレンダリングする負担を負わなくて済みます。
ただし、FSR 4 がハンドヘルド コンソールのディスクリート グラフィックス カードと同じ効果を達成できるかどうかは、さまざまな GPU パフォーマンスと実際のゲーム サポート向けに設計された AMD のモデルに依存します。機械学習の超解像度自体もコンピューティング リソースとビデオ メモリを必要とします。したがって、消費電力が非常に制限されているハンドヘルド コンソールの場合、アルゴリズムによってもたらされるパフォーマンスの向上と、モデルの実行によって発生する追加のオーバーヘッドとの間でバランスを取る必要があります。
AMD が 2026 年末までにこの拡張を正常に完了できれば、FSR 4 はもはや RX 9000 シリーズの独立したグラフィックス カードのハイエンド機能にとどまらず、AMD のゲーム ハードウェア エコシステム全体で徐々に一般的なテクノロジになるでしょう。独立したグラフィックス カードを持たないゲーム用ハンドヘルドやノートブックの場合、これは単に APU の生の GPU パフォーマンスを向上させることよりも重要である可能性があります。
現在の開発ルートから判断すると、AMD は機械学習機能をハイエンドの独立した GPU から APU、ノートブック、ハンドヘルド コンピューターに徐々に分散させようとしています。新世代の低電力チップの出現により、将来のハンドヘルド コンソール間の競争は、もはや GPU コンピューティング ユニットの数とピーク パフォーマンスを比較するだけでなく、機械学習の超解像度、フレーム生成、その他の AI グラフィックス テクノロジの効率にますます依存するようになる可能性があります。
コメント