
要約:
人工知能が従来のチャットボットから、自律的にタスクを計画し、ツールを呼び出し、複雑なワークフローを実行できるエージェント (AI エージェント) へと発展するにつれて、データセンターのコンピューティング ニーズも変化しています。 AMD は、2026 年 10 月 12 日に Helion ラックレベル AI コンピューティング リファレンス デザインを正式にリリースし、CPU をコアとし、ニーズに応じて GPU と組み合わせることができる新しいインフラストラクチャ ソリューションを提案しました。
その純粋な CPU 構成は、最大 32,768 個の AMD EPYC プロセッサ コアを統合でき、すべてのコンピューティング リソースを GPU アクセラレータに集中させるのではなく、大規模な AI エージェントに実行環境を提供するように設計されています。
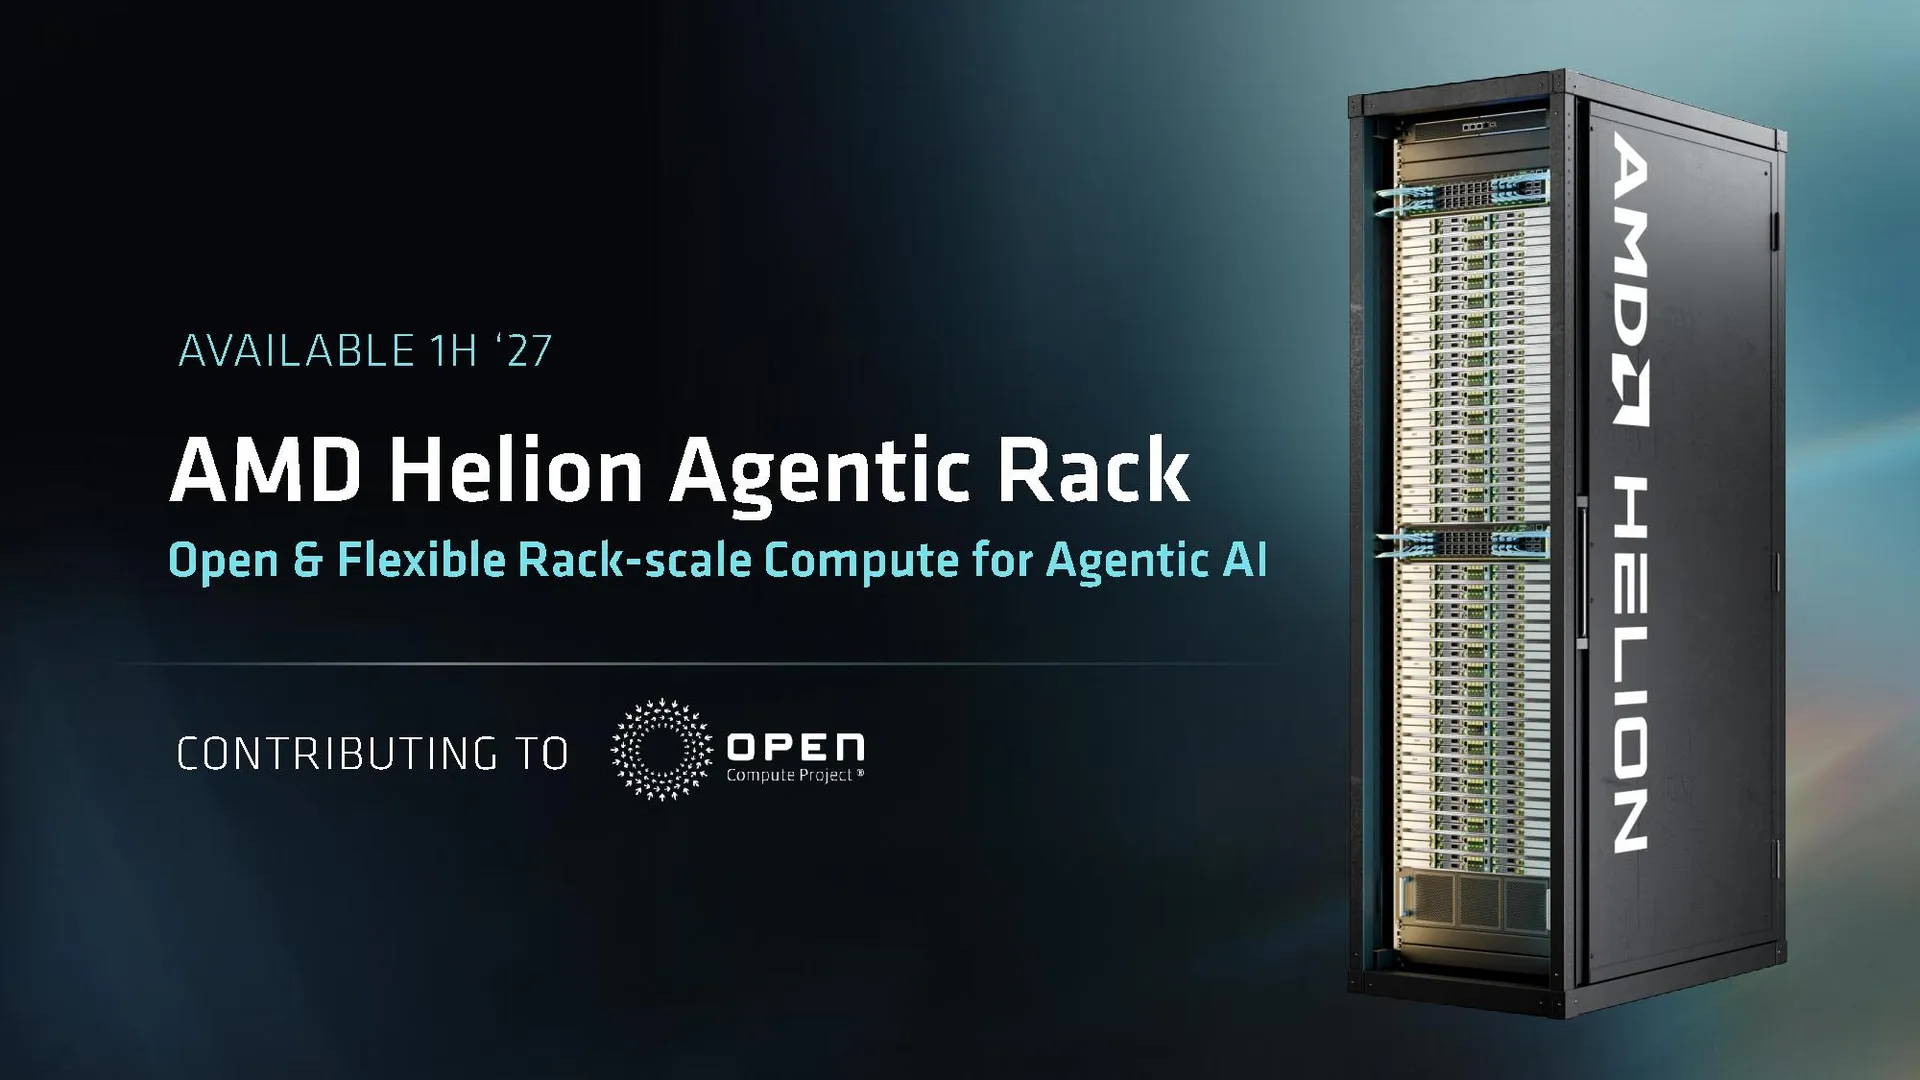
今回 AMD がリリースした Helion は、独立したチップではなく、ユーザーが直接購入できる完成したサーバー製品でもありませんが、データセンター向けのオープンラックのリファレンス デザインです。 AMDは、さらなる開発とパートナーによる採用のために、関連する仕様をOpen Compute Project (OCP)に提供する予定です。関連システムの開発には、Dell、Hewlett Packard Enterprise、Lenovo、AMD、Foxconn などのメーカーが参加し、パートナーが作成した Helion 構成は 2026 年 11 月に発売される予定です。
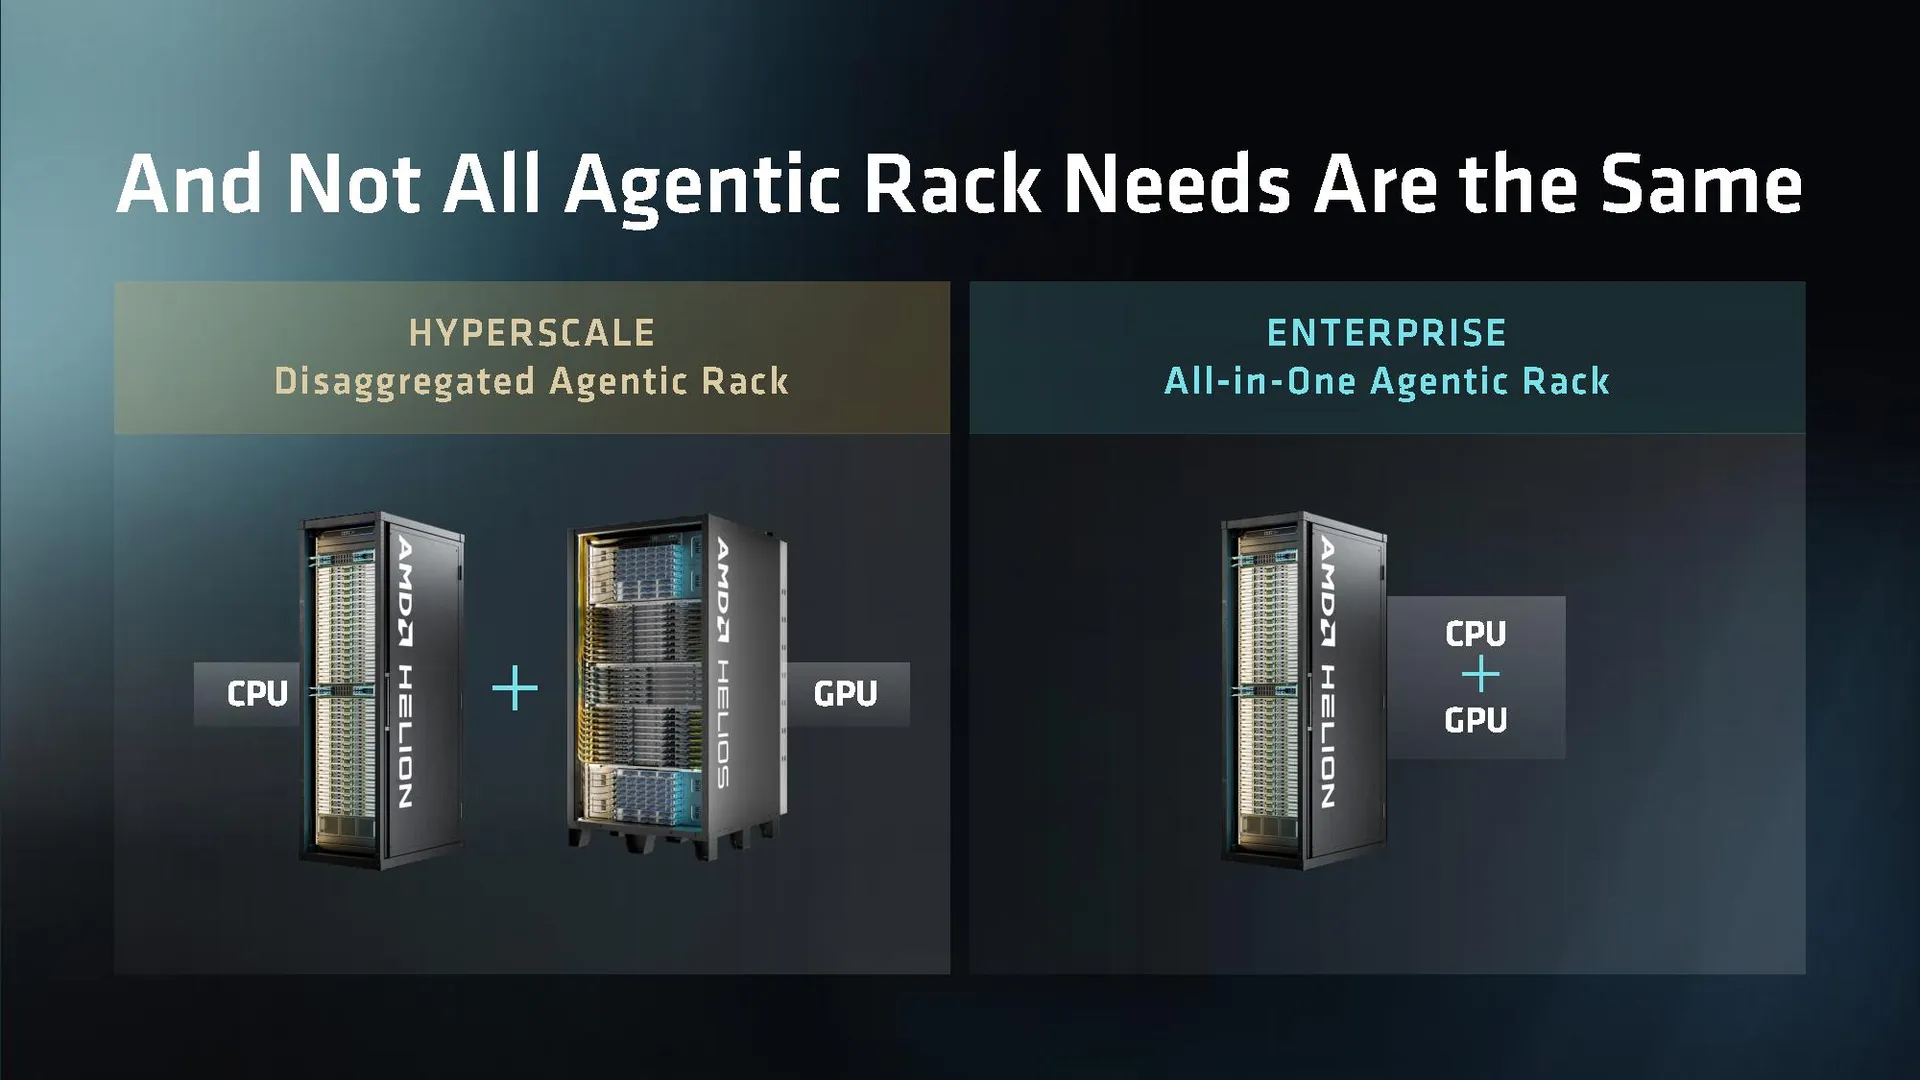
このソリューションの核となるアイデアは、AI エージェント ワークフローのさまざまな段階に応じて、CPU、GPU、ネットワーク、その他のコンピューティング リソースを柔軟に構成することです。多数のエージェントの実行、コードの実行、または複雑なビジネス プロセスの処理が必要な非常に大規模なデータ センターの場合、お客様は純粋な CPU ラックを選択できます。エージェントの実行、モデル推論、および一般的なエンタープライズ コンピューティング タスクを同じ機器セットで完了したいユーザーは、CPU と GPU のハイブリッド構成を選択できます。
この設計は、AI インフラストラクチャにおける新たな分業の出現を反映しています。 GPU は依然として大規模モデルのトレーニングや高強度の推論にとって重要なコンピューティング デバイスですが、AI エージェントが実際にタスクを実行する際には、プログラムの実行、データベースへのアクセス、外部ツールの呼び出し、タスク ステータスの管理、および複数のコンピューティング ステップの調整のために大量の CPU リソースも必要とします。エージェントの数が増えると、これらのタスクがデータセンター内の新たなリソースのボトルネックになる可能性があります。
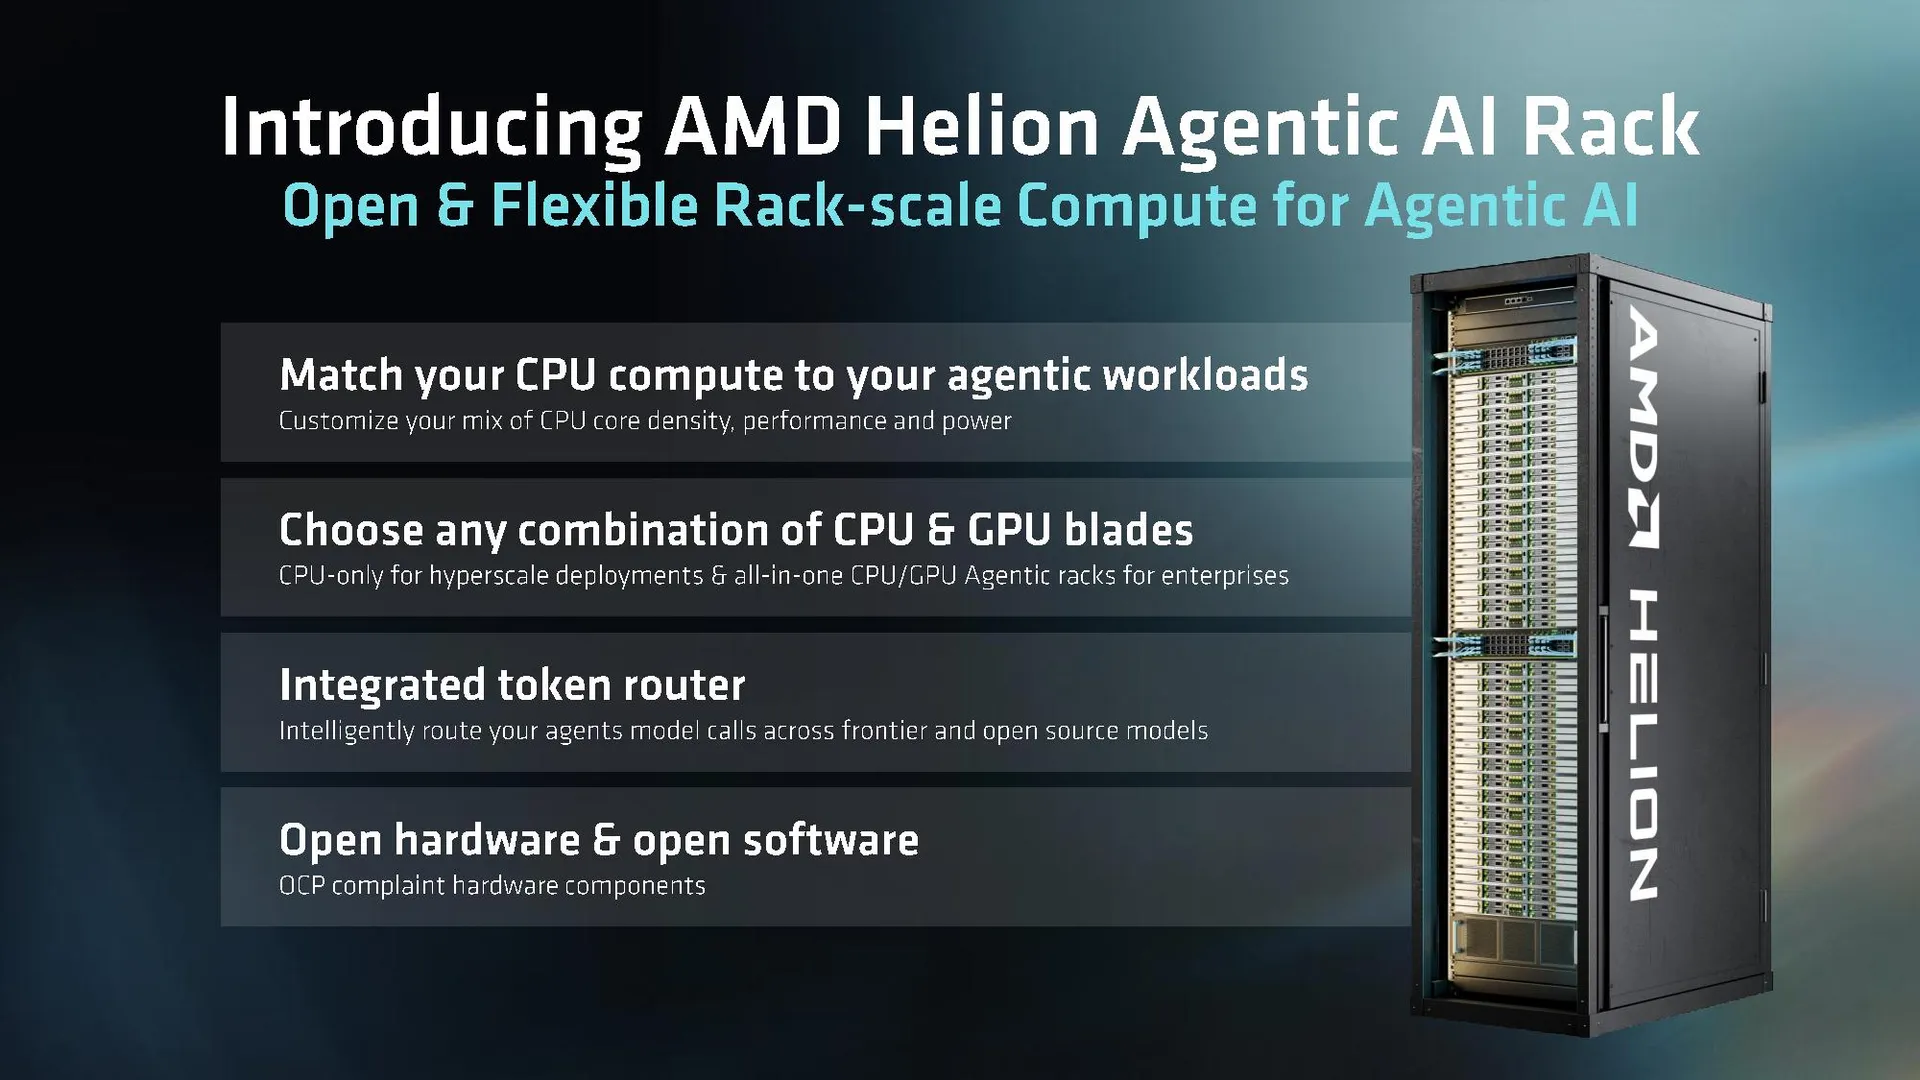
AMD のコンピューティングおよびエンタープライズ AI 部門の上級副社長兼ゼネラルマネージャーである Dan McNamara 氏は、エージェント AI は単一タイプのワークロードではなく、パーソナル エージェント、エンタープライズ アプリケーション、コード実行、複雑なワークフローなどのさまざまなシナリオをカバーしていると述べました。各タスクには、コンピューティング リソースに対するさまざまな要件があります。したがって、データセンターには、特定のワークロードに基づいてパフォーマンス、コア密度、消費電力を調整できるインフラストラクチャが必要です。
AMD は、Helion を使用して EPYC プロセッサのパフォーマンス、オープン ソフトウェア エコシステム、柔軟なラック設計を組み合わせ、パートナーが顧客のニーズに合わせてシステムを構築し、限られた電力リソースをより効率的に利用できるようにしたいと述べました。
Helion の最も目を引く構成は、最大 32,768 個の CPU コアを収容できる純粋な CPU ラックです。このソリューションは AMD の第 6 世代 EPYC サーバー プロセッサを使用しており、コア アーキテクチャは Zen 6 で、コード名は Venice です。 AMDが発表した設計によれば、ラック全体に最大128個の256コアプロセッサを搭載でき、理論的には32,768個のCPUコアを備えたコンピューティングクラスタを形成できるという。
ここで、32768 コアは 1 つのプロセッサに統合されているのではなく、多数のサーバー ノードのプロセッサで構成されていることに注意してください。 Helion は、複数のコンピューティング ノード、ネットワーク機器、関連インフラストラクチャを全体に統合するラックレベルの設計を採用し、データセンターでの集中展開と管理を実現します。
この設計は、多数の独立したタスクまたは並列タスクを実行する必要があるシナリオに特に適しています。たとえば、企業では数万の AI エージェントを同時に実行する場合があり、各エージェントにはコードの実行、データの取得、企業の内部 API の呼び出し、またはユーザーによって割り当てられた複雑なタスクの処理を行うための独立した実行環境が必要です。単にモデル推論を実行する場合と比較して、このタイプのワークフローには通常、より日常的なプログラム実行とシステム調整操作が含まれるため、十分な CPU コンピューティング能力が必要です。
従来の大規模言語モデル アプリケーションでは、ユーザーが質問を入力した後、モデルが回答を生成し、コンピューティング負荷は主にモデル推論段階に集中します。しかし、エージェント アプリケーションでは、リクエストによって一連の操作がトリガーされる場合があります。エージェントはタスクを分析し、検索ツールまたはデータベースを呼び出し、コードを実行し、結果を確認し、必要に応じてモデルを再度呼び出し、最後に応答を生成します。
このプロセスでは、GPU はモデル推論などの高度な並列コンピューティング タスクの実行を担当し、CPU は多数のプログラムの実行、データ処理、タスクのスケジューリング、およびツールの呼び出しを担当します。エージェントの数が増加し続けると、たとえ GPU に十分な推論能力があっても、CPU リソースが不足し、システム全体の処理速度が制限される可能性があります。
AMD は、モデルの推論を独立した GPU インフラストラクチャに処理を任せながら、エージェントに大規模でスケーラブルな実行環境を提供する Helion ピュア CPU 構成を通じてこの問題を解決したいと考えています。
これは、Helion が GPU を CPU に完全に置き換えようとしているのではなく、2 つの役割をさらに分離しようとしていることを意味します。超大規模クラウド サービス プロバイダーにとって、この設計により、さまざまな種類のワークロードが、より適切なコンピューティング リソースを使用できるようになり、高価な GPU が多数の通常のプログラム実行タスクによって占有されることがなくなります。
Helion は、純粋な CPU バージョンに加えて、CPU と GPU を組み合わせたエンタープライズ レベルの構成も提供します。このソリューションは、AMD EPYC プロセッサ、Instinct MI350P GPU アクセラレータ、汎用コンピューティング ノードを同じラックに統合できるため、企業はエージェントの実行、モデル推論の実行、データベース、ストレージ、その他の一般的なコンピューティング タスクの処理を同じインフラストラクチャ内で行うことができます。
AMD が発表した設計によれば、ハイブリッド構成には最大 16 個の Instinct MI350P GPU アクセラレータを搭載でき、最大 102 Tbps のネットワーク帯域幅を提供できます。ここでのネットワーク帯域幅はシステム全体の設計指標であり、各計算ノードが独立して同じ帯域幅を取得できることを意味するものではありません。実際の通信パフォーマンスは、ネットワーク トポロジ、ポート構成、トラフィック分散、システム ソフトウェアによっても異なります。
GPU ノードに関しては、AMD は 8 つの Instinct MI350P アクセラレータを使用した 5U サーバー設計を提供しています。 GPU 計算ノードと CPU ノードを組み合わせることで、企業はシステム全体を単一のハードウェア構成に固定することなく、特定のタスクに基づいてアクセラレータの数を調整できます。
たとえば、大量の企業データを処理し、複雑なワークフローを実行する必要があるシステムは、より多くの CPU コアを割り当てることができます。高スループットのモデル推論を必要とするシステムでは、GPU リソースが増加する可能性があります。データベースやストレージなどの補助ワークロードでも専用の汎用コンピューティング ノードを使用できるため、それらとエージェントによって実行されるタスクの間のリソースの競合が軽減されます。
AMD はまた、消費電力、コア密度、シングルコアのパフォーマンスに関するさまざまなニーズを満たすために、Helion のさまざまな位置にさまざまな CPU コンピューティング ノードを設計しました。
高密度ノードでは、定格消費電力が 400 ワットの EPYC 9006 シリーズ プロセッサが使用されており、主に単位スペースあたりの CPU コア数を最大化するために使用されます。バランス ノードは、定格消費電力が 600 ワットの 256 コア プロセッサを使用して、コア密度と全体のコンピューティング能力のバランスをとります。
シングルスレッドのパフォーマンスをより重視するワークロード向けに、AMD は 96 コアと最大周波数 5 GHz のプロセッサ構成も提供しています。単純にコア数を追求するよりも、シングルスレッドのパフォーマンスや応答速度を重視するタスクに適しています。
この差別化された設計は、AI エージェントが必ずしも多くの CPU コアを必要とするわけではないという重要な現実を反映しています。一部のタスクは多数の並列操作に分割でき、これは高コア密度のサーバーに適しています。他のタスクは、シングル スレッドのパフォーマンス、メモリ レイテンシ、または外部サービスの応答速度によって制限されるため、コア数を単純に増やすだけでは、それに対応するパフォーマンスの向上を実現することはできません。
そのため、Helion は、データセンター オペレータが 1 つの仕様ですべてのシナリオをカバーするのではなく、実際のワークロードに基づいて異なるプロセッサ構成を選択できるようにしようとしています。
熱放散に関しては、Helion は空冷ソリューションと液体冷却ソリューションの両方をサポートしています。数万の CPU コアと統合された高速ネットワーク機器を備えたラックでは、電源と放熱設計は無視できないエンジニアリングの問題です。高密度サーバーはコンピューター室のスペース利用率を向上させますが、単位スペースあたりの熱負荷も高くなります。
液体冷却は、システムがプロセッサやその他の高出力コンポーネントから発生する熱をより効率的に除去するのに役立ちますが、冷却インフラストラクチャ、配管設計、メンテナンス プロセスのサポートも必要になります。既存のデータセンター施設を引き続き使用したい一部の顧客には、空冷の方が適している場合があります。 AMD は 2 つのソリューションを提供しており、パートナーはコンピューター室の条件、導入規模、運用コストに基づいて選択できます。
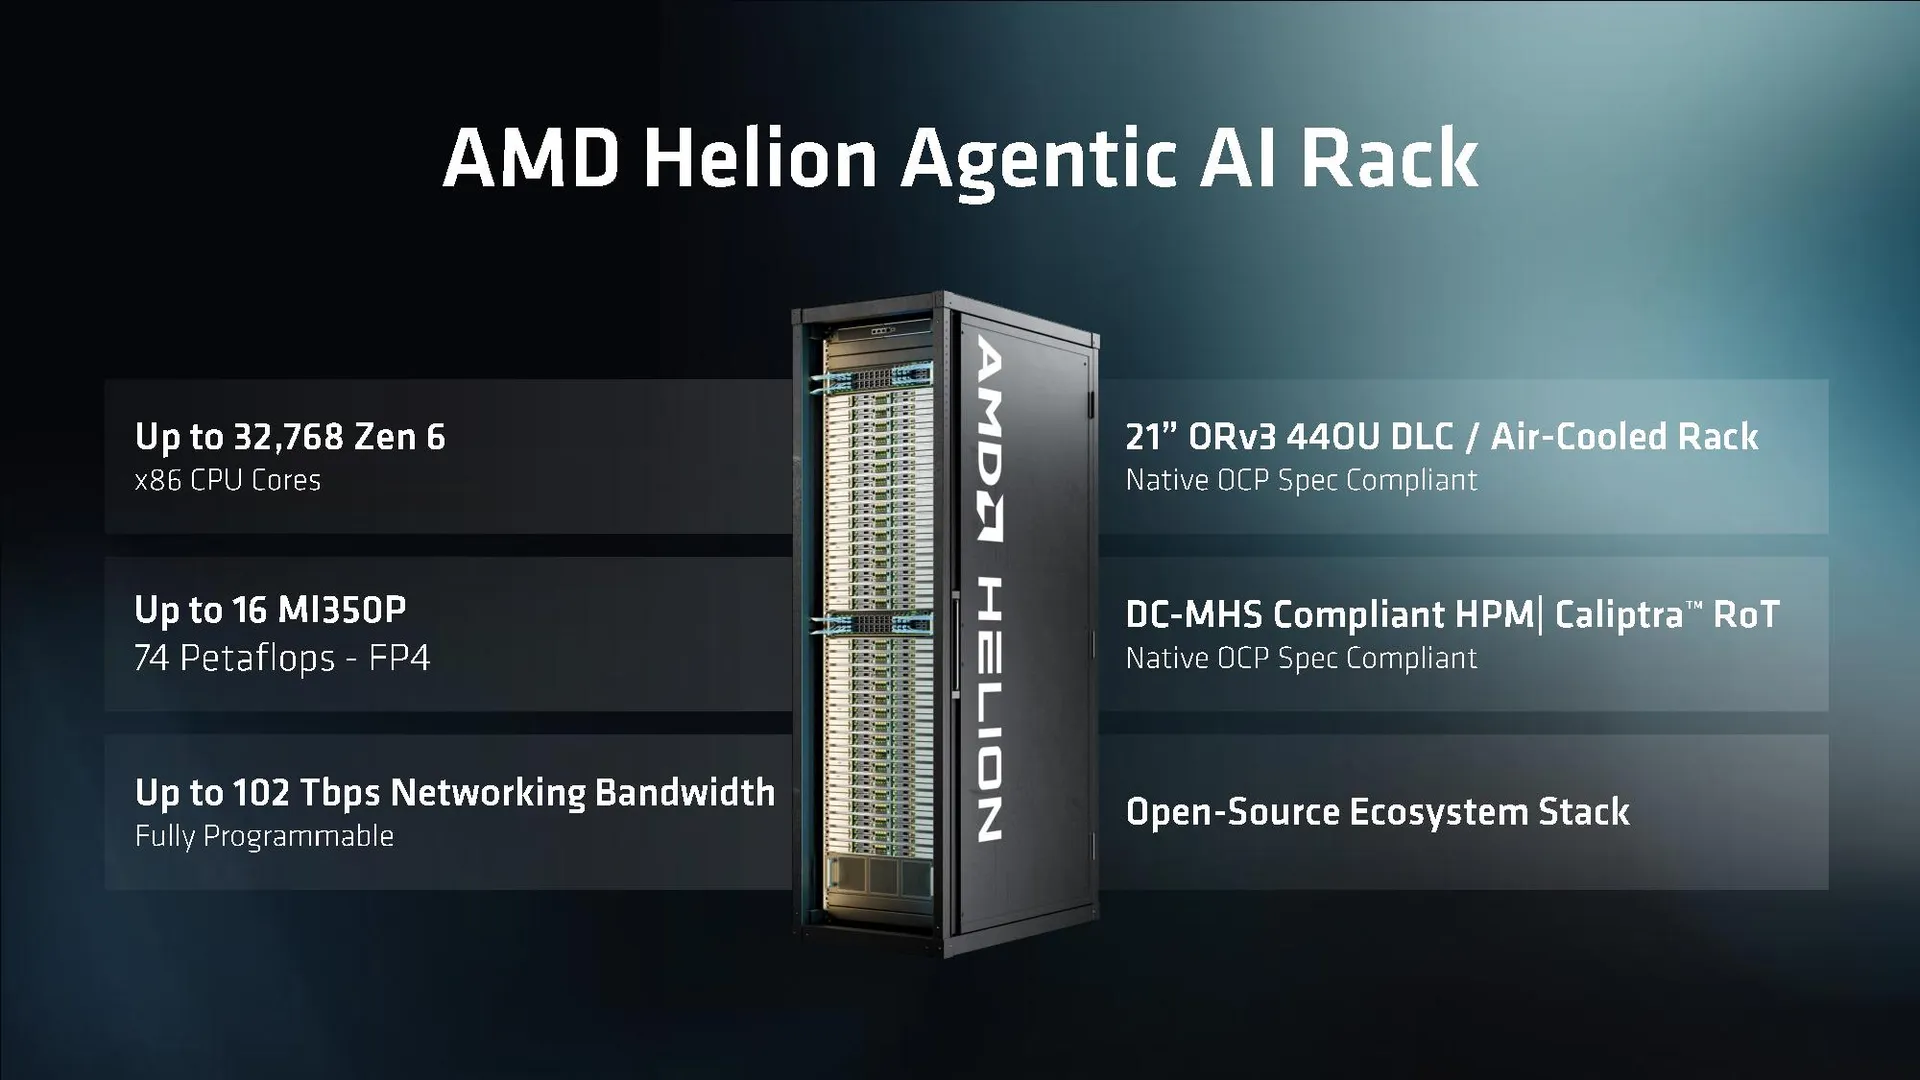
Helion は、ハードウェア構成に加えて、オープン ソフトウェアとシステム設計も重視しています。 AMDは、パートナーが単一メーカーが提供するクローズドシステムに完全に依存するのではなく、共通の設計ベースに基づいて開発できるように、関連する参照仕様をOCPに提供する予定だ。
OCP は、オープン データ センター ハードウェア設計を推進する業界団体です。参加者には、クラウド サービス プロバイダー、サーバー メーカー、その他のインフラストラクチャ プロバイダーが含まれます。オープン リファレンス デザインは、さまざまなメーカーが共通のハードウェア仕様に基づいてシステムを統合し、顧客のニーズに基づいてさまざまな構成を提供するのに役立ちます。
AMD は、この方法で Helion のエコシステムを拡大し、Dell、Hewlett Packard Enterprise、Lenovo、AMD、Foxconn、その他のパートナーが独自の製品を開発できるようにしたいと考えています。顧客が最終的に購入するのは、標準化されたラックの完全なセットを AMD から直接購入するのではなく、パートナーによって製造および統合されたサーバー システムになります。
AMD によると、Helion 構成は現在エコシステム パートナーと開発中で、2026 年 11 月に発売される予定です。関連する設計はまだシステム統合、検証、実際の展開を経る必要があります。最終的にどのような構成が提供されるのか、いつ大規模に納入されるのか、各メーカーの具体的な製品仕様などは今後発表される予定です。
市場競争の観点から、Helion は、AMD が AI インフラストラクチャにおける EPYC プロセッサの役割をさらに拡大していることも反映しています。
ここ数年、AI データセンターの建設は主に GPU アクセラレータ、サーバー相互接続、高帯域幅メモリなどの分野に焦点を当ててきました。大規模なモデルのトレーニングと推論の需要が急速に高まる中、NVIDIA は GPU 製品とソフトウェア エコシステムで明確な市場優位性を確立しています。
しかし、AI アプリケーションが徐々に企業のビジネス プロセスに組み込まれるにつれ、データセンターが処理する必要があるタスクはもはやモデルの計算だけではなくなりました。エージェントは、多数のプログラムを実行し、データベースにアクセスし、ドキュメントを処理し、コードを実行し、複数のモデルを同時に調整する必要がある場合があります。これらの操作により、CPU リソースに対する新たな要求が生じます。
AMD は、ハイコア EPYC プロセッサの助けを借りて、このインフラストラクチャの変化においてより多くの市場機会を獲得したいと考えています。 CPU コア密度、GPU アクセラレーション、ラックスケール ネットワーク設計を組み合わせることで、Helion はさまざまなエージェントのワークロードに適応できるオープン プラットフォームを提供しようとしています。
もちろん、32,768 個の CPU コアだけでは、システムの実際のパフォーマンスを直接説明することはできません。最終的なパフォーマンスは、プロセッサーのマイクロアーキテクチャ、メモリー帯域幅、キャッシュ容量、ノード間通信、ソフトウェアのスケジューリング効率、ワークロードの並列度にも依存します。大規模モデルの推論に大きく依存するタスクの場合、GPU は依然としてシステムのスループットを決定する重要な要素となる可能性があります。
同様に、CPU コアの数を増やしても、エージェントのタスクが比例して高速化されるわけではありません。多数のタスクがデータベースの応答を待機したり、外部ネットワークにアクセスしたり、他のサービスを呼び出したりする必要がある場合、システムのボトルネックがストレージ、ネットワーク、またはソフトウェアのレベルに移行する可能性があります。したがって、Helion の価値は、実際のアプリケーションにおけるパフォーマンス、エネルギー効率、総所有コストによって測定する必要があります。
全体として、AMD Helion は AI インフラストラクチャ設計のアイデアの拡張を表しています。 AMD はもはや、人工知能における GPU アクセラレータの役割を強調するだけでなく、タスクの実行、モデル推論からデータ処理まで、エージェントに統合コンピューティング ソリューションを提供しようとしています。
AI エージェントがソフトウェア開発、エンタープライズ自動化、複雑なワークフローなどのタスクを徐々に引き受けるようになると、CPU と GPU 間のリソースの分割がより重要になる可能性があります。将来、企業が多数のエージェントに独立した実行環境を本当に提供する必要がある場合、高コア密度の CPU サーバーが AI データセンターの重要な部分になる可能性があります。
ただし、Helion は、完全に展開された成熟した製品ではなく、まだオープンなリファレンス設計です。実際のアプリケーションでパフォーマンスとコストの利点を達成できるかどうかは、最終的にはパートナーのシステム実装、ソフトウェア エコシステムの成熟度、エージェント コンピューティング インフラストラクチャに対する企業顧客の実際のニーズに依存します。
コメント