
要約:
10 月 24 日、
ダークサイド オブ ザ ムーン キミは今朝早く、キミ K3.1 シリーズの最初のモデルである K3.1 Pro を正式に発売しました。
これは、同社のこれまでで最も強力な 3 兆レベルのパラメータ モデルであり、100 万のコンテキストをサポートします。同レベルのインテリジェンスと比べて出力速度が約2~3倍となった高速版の Kim K3.1 Pro Highspeed も同時に発売されました。
公式の紹介によると、K3.1 Pro はコード、エージェント、ナレッジ ベンチマークの点で最強のクローズド ソース モデル レベルに達しているか、それに近いレベルに達しています。 Terminal-Bench 4.0 の評価では、K3.1 Pro のスコアは 65.7% で、GPT-6 Astra の 58.2% を上回り、Claude Opus 5.5 の 66.4% にはわずかに及ばない程度でした。内部ベンチマーク Kim Code Bench 3.0 Long-horizon では、K3.1 Pro のスコアは 61.2% で、K3 の 55.95% を上回りました。
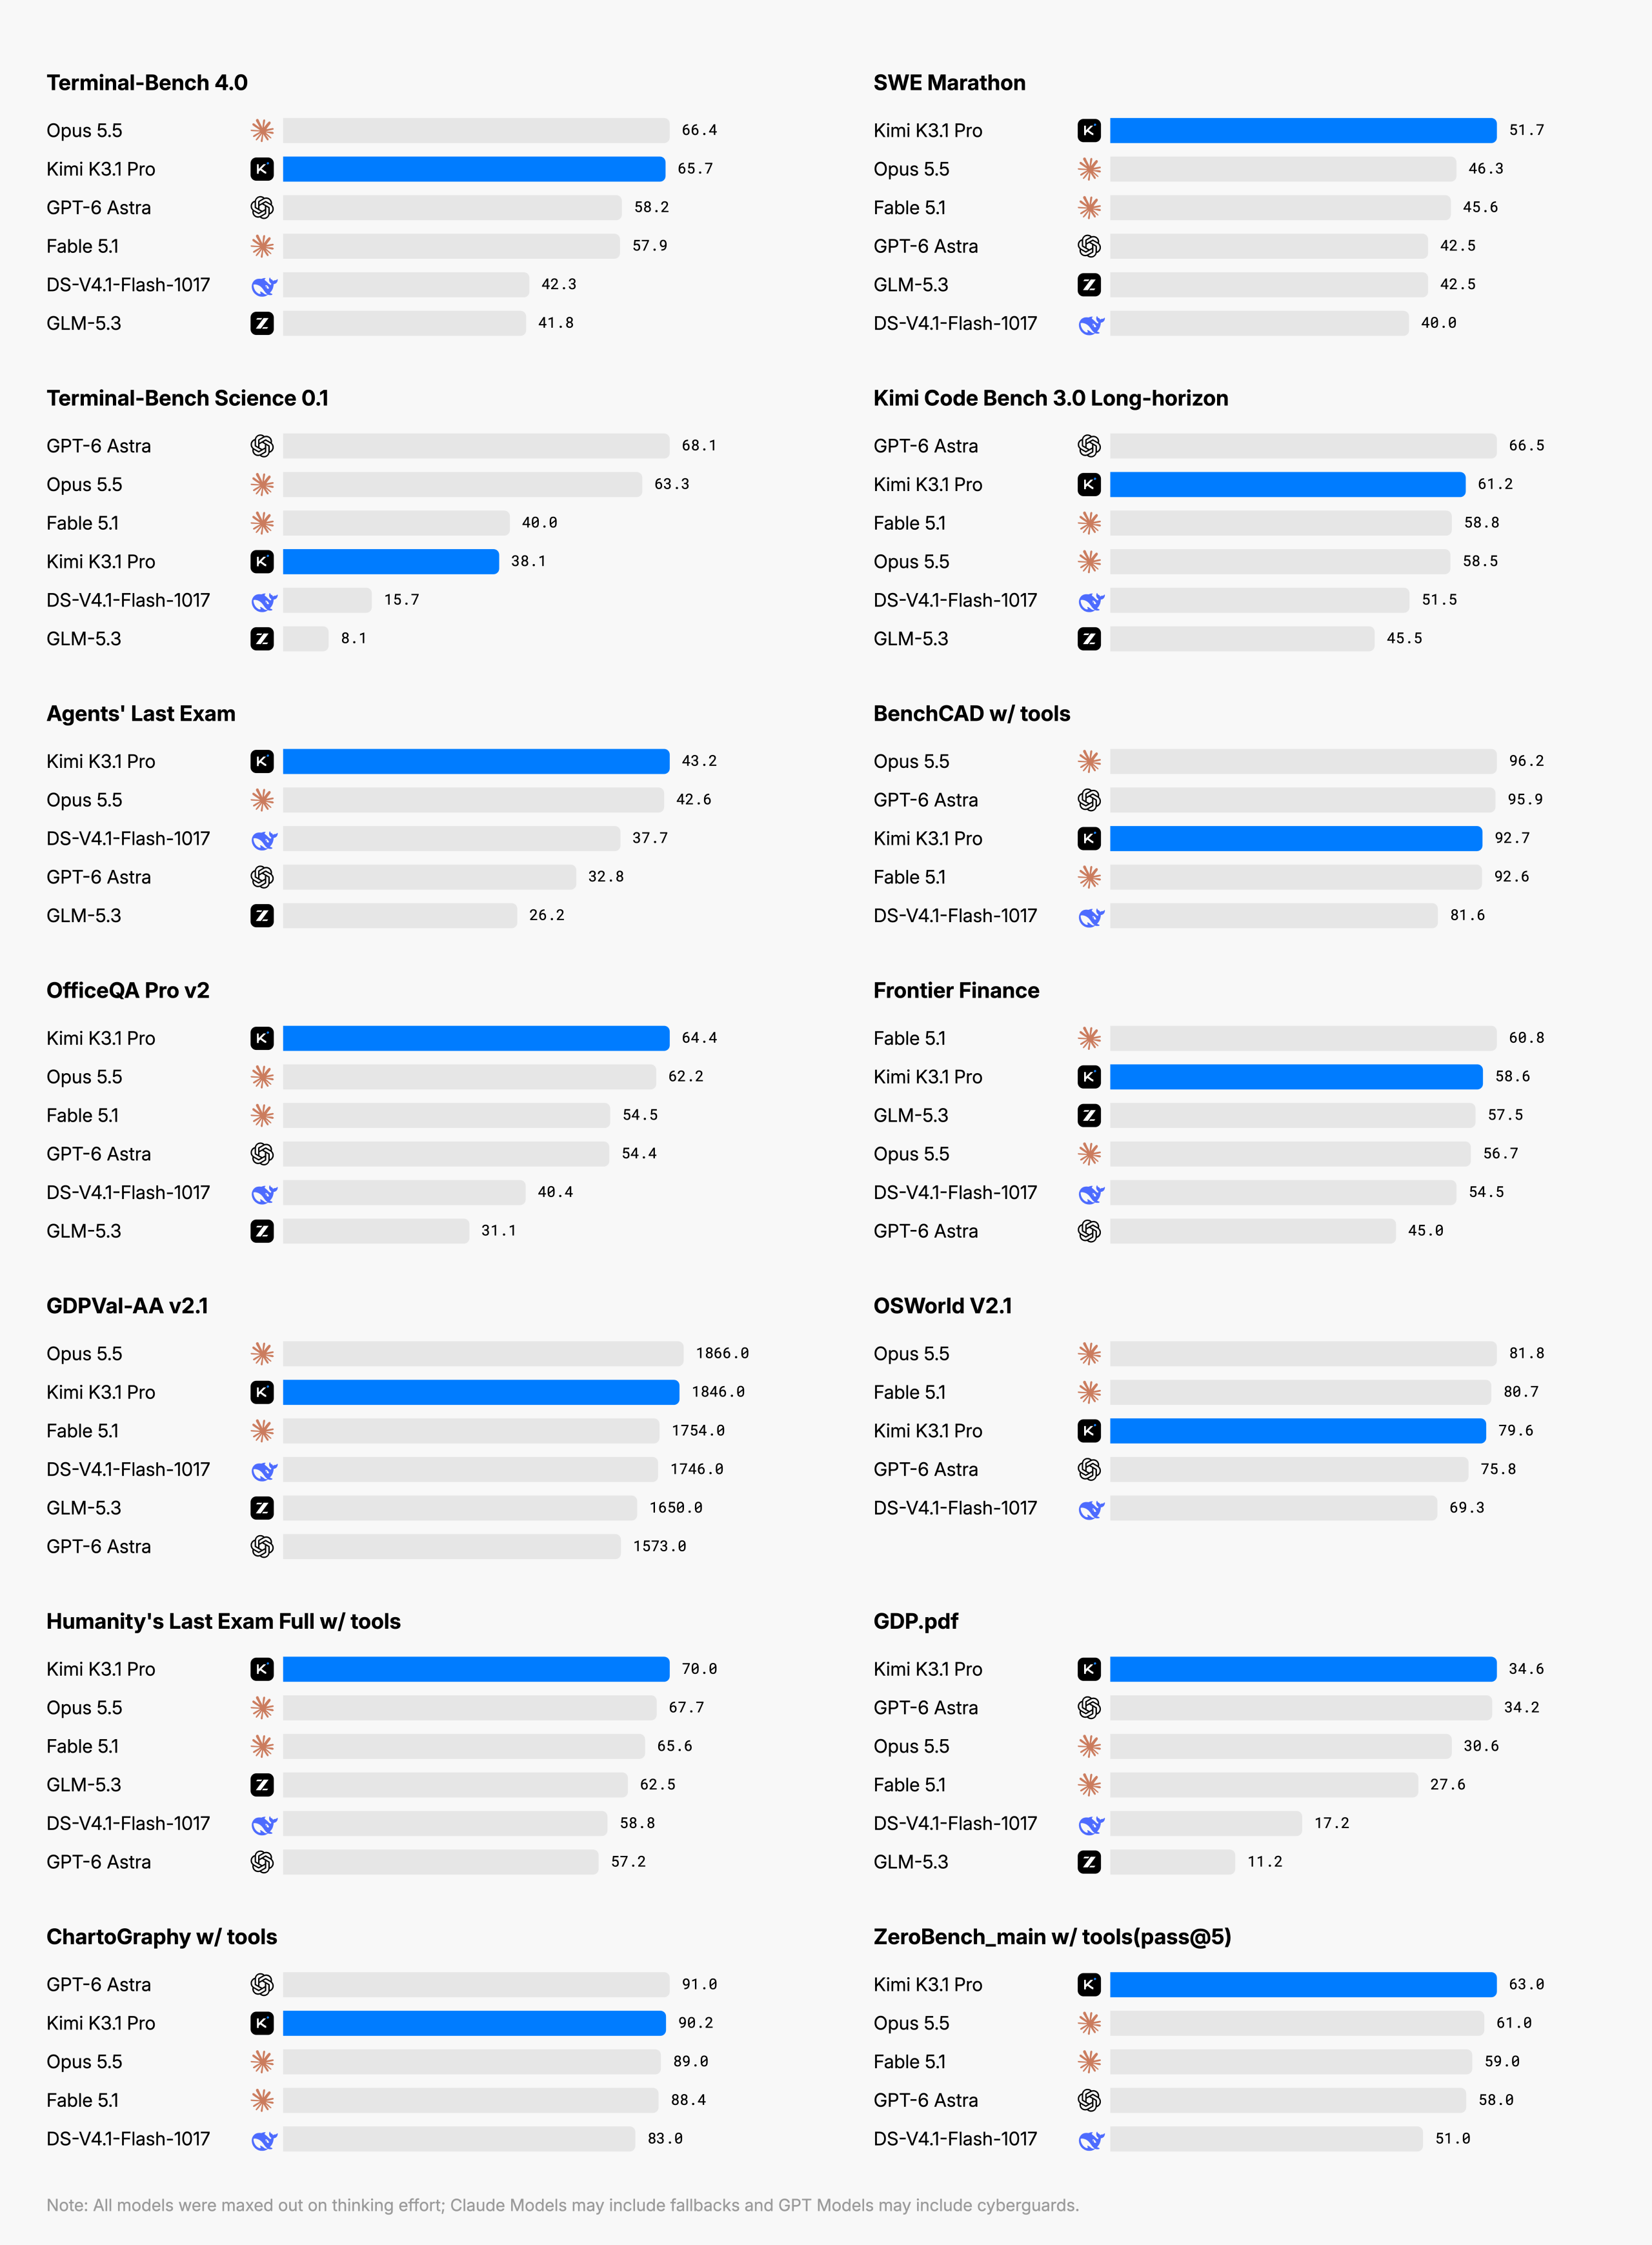
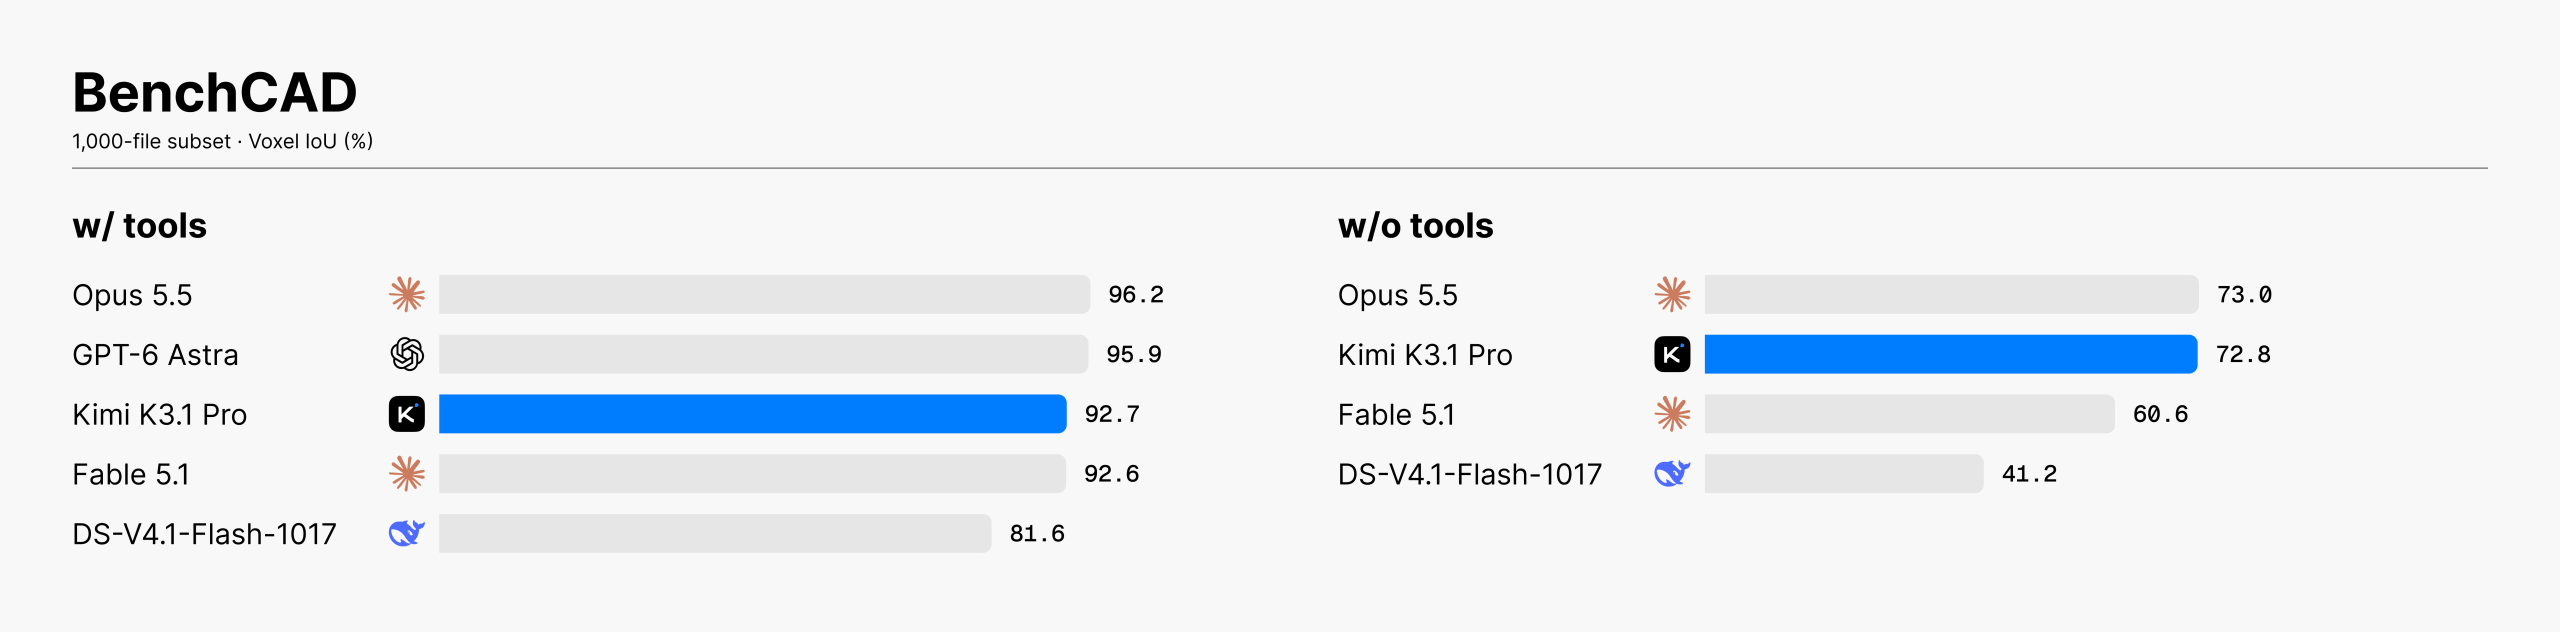
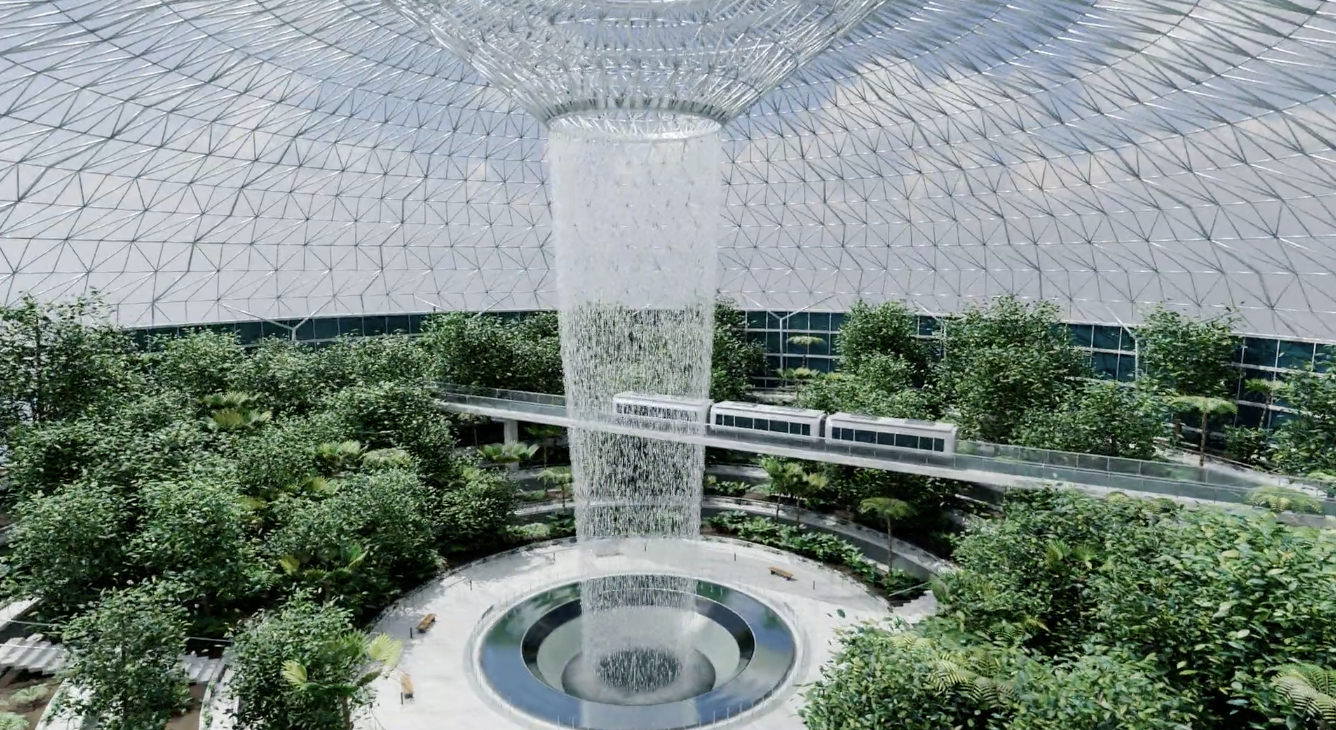
3D 作成と空間推論に関しては、BenchCAD ベンチマーク テストのツールを使用した K3.1 Pro のスコアは 92.7% で、これは Claude Opus 5.5 の 96.2% や GPT-6 Astra の 95.9% に近い値です。モデルは、テキストの説明、スケッチ、または参照図面に基づいてオブジェクトの形状、比率、空間関係を推測し、それらを使用可能な 3D モデルに再構築できます。 kimi.com と Kimi App は、オンライン プレビュー、編集、3D プリントのエクスポートをサポートする 3D Make 機能を同時に開始しました。
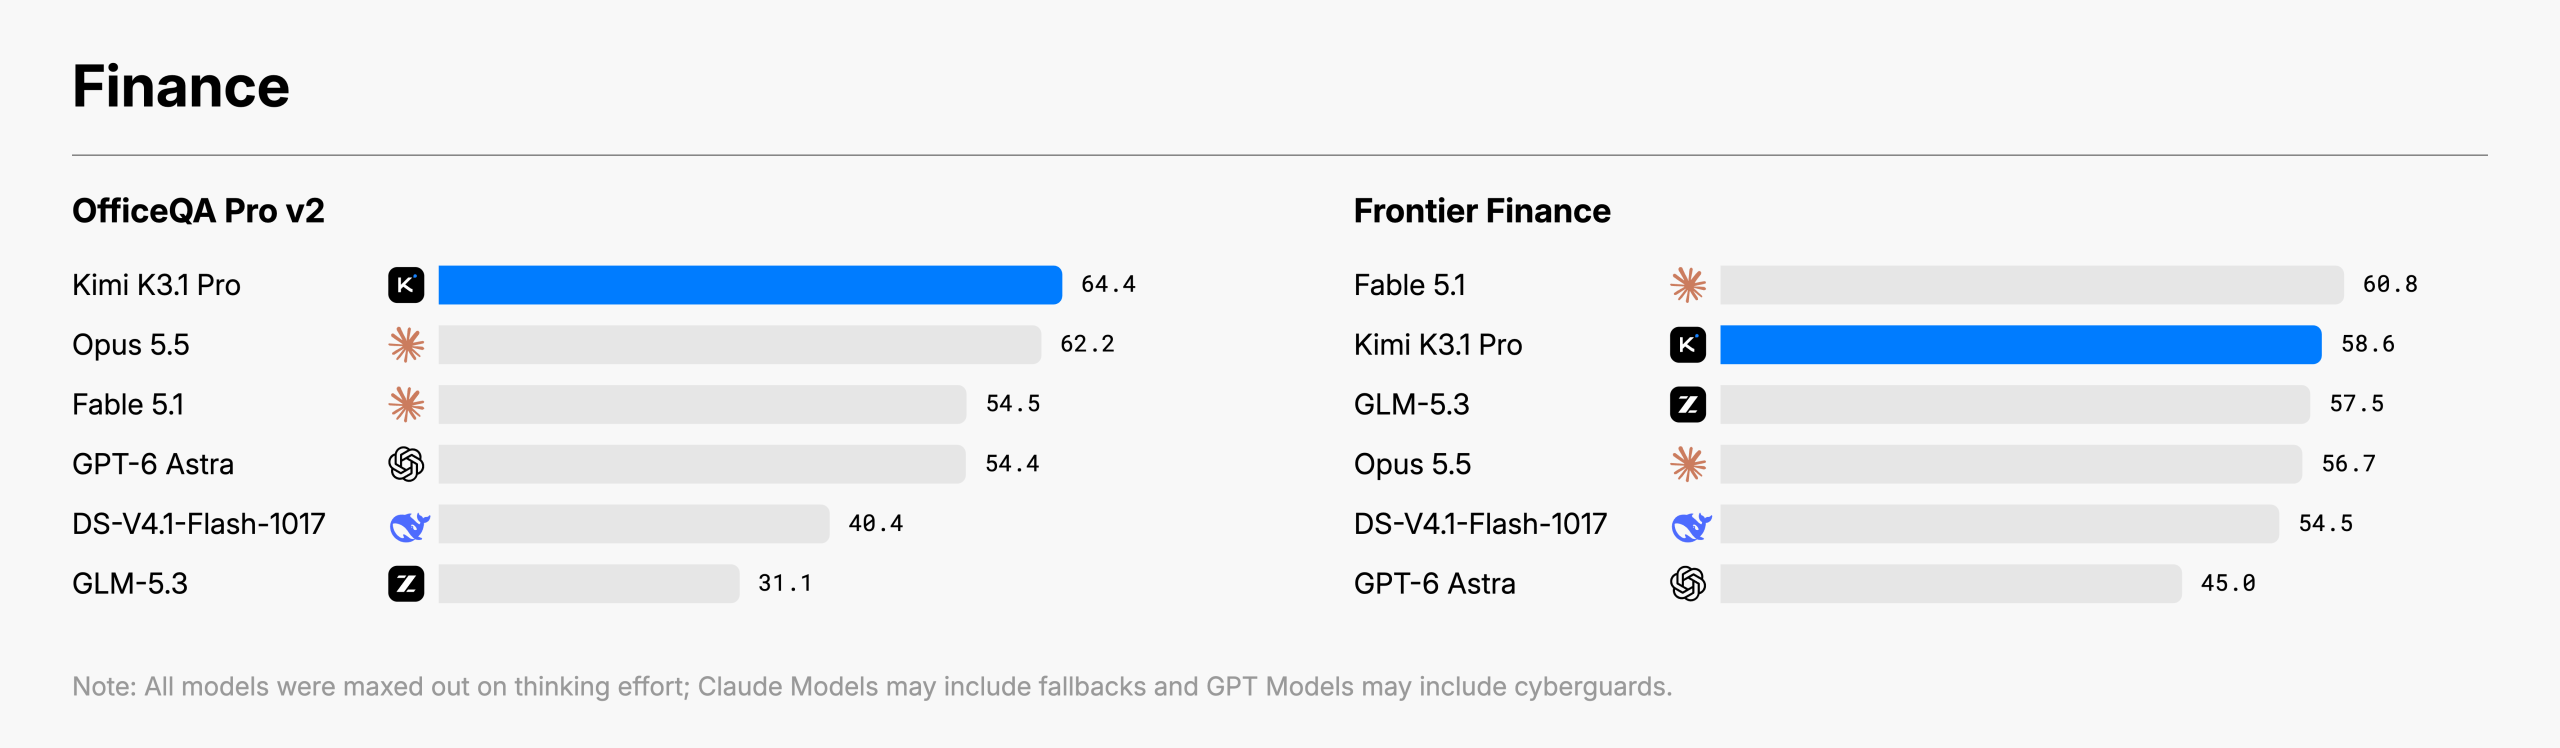
財務ワークフローに関しては、K3.1 Pro は OfficeQA Pro v2 ベンチマーク テストで 64.4 のスコアを獲得し、現時点で最高の結果を達成しました。 3 つの社内財務ベンチマークでは、財務モデリング、財務調査、および業務運営が、K3 と比較してそれぞれ 14%、20%、および約 4.2 倍向上しました。事実の正確さの点では、キミ ハル ベンチ ハードの社内ストレス テストにおいて、K3.1 Pro の単一事実記述の誤り率は K3 の 23.4% から 8.3% に低下しました。
今後、ユーザーは kimi.com、Kimi App、Kimi Work、Kimi Code、および Kim API を通じて K3.1 Pro および高速バージョンを使用できるようになります。 API の価格は、100 万トークン入力 (キャッシュミス) ごとに 13 元、(キャッシュヒット) 1.3 元、出力 68 元です。高速バージョンの価格は 2 倍です。フルモデルの重量は 11 月 4 日までにリリースされる予定です。
コメント