
要約:
NVIDIA は、HBM4 高帯域幅メモリ帯域幅や NVLink 高速インターコネクト帯域幅など、次世代 Vera Rubin 人工知能コンピューティング プラットフォームの一部のハードウェア仕様を調整しました。以前に発表または配布された指標と比較すると、新しい仕様は低下していますが、水平方向の拡張ネットワーク帯域幅は増加しています。この変更は、Nvidiaが実際の量産に基づいてチップのパフォーマンス、供給能力、システムコストのバランスを再調整していることを意味する可能性があります。
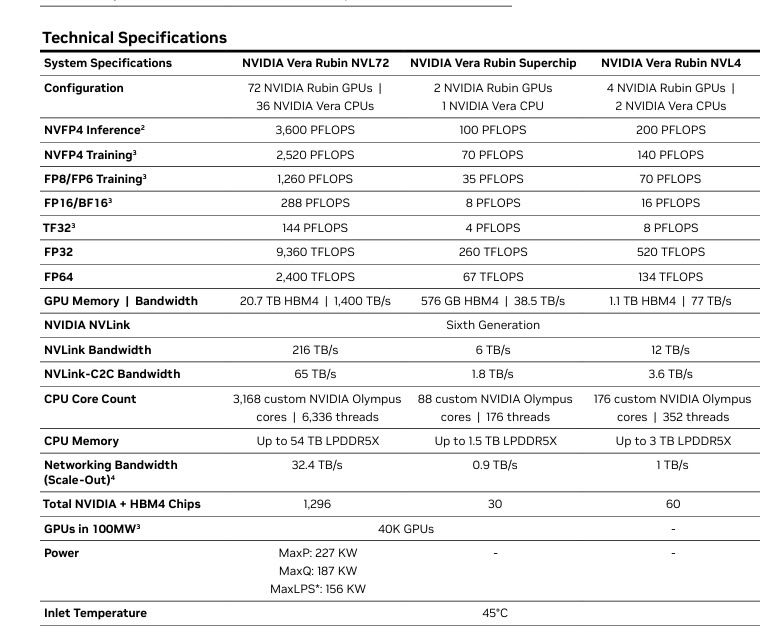
NVIDIA が現在発表している Vera Rubin プラットフォームの仕様によると、Rubin GPU には 288GB HBM4 メモリと 19.2TB/s のメモリ帯域幅が搭載されています。以前、NVIDIA の技術データでは、最大メモリ帯域幅の指標が 22TB/s とされていました。両者を比較すると、現在発表されている値は約12.7%低い。 Nvidia は以前は「達成可能な最大」指標を使用していたため、これは仕様数値の変更を反映しており、必ずしもすべての製品が実際のパフォーマンスが同等に低下したことを意味するわけではないことに注意することが重要です。
HBM4 は、より広いメモリ インターフェイスを使用して、人工知能モデルのトレーニングと推論により高いデータ スループット機能を提供する新世代の高帯域幅メモリ テクノロジーです。モデルのサイズが拡大し続けると、GPU はより強力な計算能力を必要とするだけでなく、大量のモデル パラメーターと中間データを継続的に取得する必要があります。メモリ帯域が不足すると、たとえ理論上の演算能力が高くても、データ待ちにより性能を十分に発揮できない場合があります。
Rubin プラットフォームによって以前に追求されていた高いメモリ帯域幅も、HBM4 サプライ チェーンに高い技術要件をもたらしました。ビデオ メモリのメーカーは、より高いデータ転送速度での消費電力、熱放散、信号の完全性、長期信頼性の要件を満たす必要があります。帯域幅の仕様が高くなるほど、通常、設計検証や量産プロセスで直面する課題も大きくなります。
NVIDIA がメモリ帯域幅要件を引き下げれば、製品規格を満たす HBM4 チップの範囲が拡大する可能性があり、サプライヤーは認定製品の生産比率を高める機会も得られます。これは、ビデオ メモリ メーカーが製品セット全体を再設計しなければならないという意味ではありませんが、以前の最高性能目標を達成できなくても、新しい要件は満たしている一部の製品が供給システムに参入できるようになり、全体的な供給能力が向上する可能性があります。
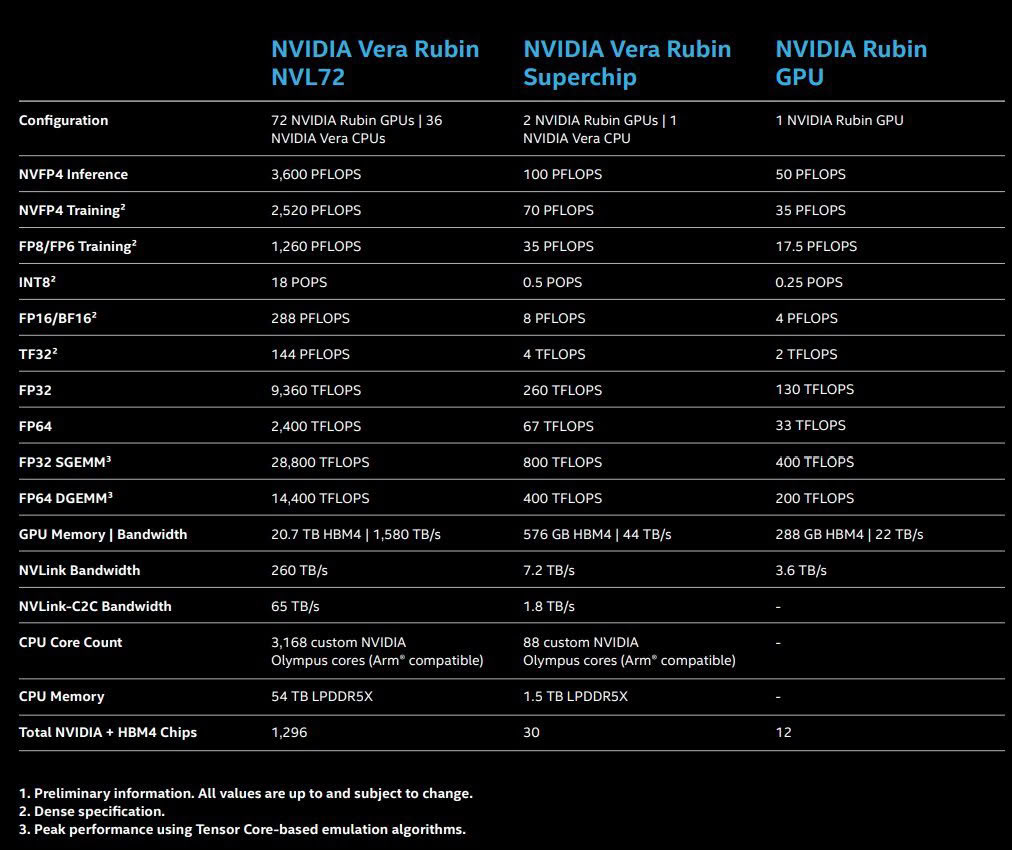
メモリ帯域幅に加えて、Nvidia は Vera Rubin スーパー チップの NVLink 相互接続仕様も調整しました。現在の製品情報によると、Vera Rubin スーパー チップの NVLink 帯域幅は、以前の 7.2TB/s から 6TB/s に調整され、約 16.7% 減少しました。 NVLink は、GPU 間の高速通信のための NVIDIA の相互接続テクノロジです。マルチ GPU システムにおけるデータ交換、モデルの並列トレーニング、および複雑な人工知能推論タスクにおいて重要な役割を果たします。
大規模な人工知能クラスターでは、勾配、アクティベーション値、その他の中間データを GPU 間で頻繁に交換する必要があります。異なるコンピューティング ユニット間の通信は、専門的なハイブリッド アーキテクチャを備えた大規模モデルにとって特に重要です。したがって、NVLink 帯域幅インジケーターを減らすと、一部の通信集中型タスクのパフォーマンスに影響が出る可能性がありますが、最終的な影響はモデル アーキテクチャ、ソフトウェア スケジューリング方法、実際の負荷によって異なります。全体的な計算能力の損失は、帯域幅削減率に基づいて単純に計算することはできません。
同時に、Nvidia は一部のスケールアウト ネットワークの帯域幅メトリクスを増加しました。既存のデータによると、Vera Rubin スーパー チップの水平拡張ネットワーク帯域幅は、以前の 0.8TB/s から 0.9TB/s に増加しました。このタイプのネットワークは主に、さまざまなコンピューティング ノードを接続するために使用され、データ センターが多数の GPU を統合されたコンピューティング クラスターに編成できるようにします。ネットワーク帯域幅を増やすと、特にコンピューティング タスクをサーバー間で協力して完了する必要がある場合に、ノード間のデータ転送機能が向上します。
この 1 ダウンと 1 アップの調整は、人工知能コンピューティング プラットフォームの設計におけるトレードオフの関係を反映しています。GPU 内とキャビネット内の通信機能は重要ですが、クラスターの規模が拡大するにつれて、クロスノード通信も全体的なパフォーマンスを制限する要因になる可能性があります。 Nvidia は、実際のアプリケーションのニーズに基づいてシステム設計のパフォーマンス バジェットを再割り当てしている可能性があります。
ただし、仕様変更自体は、Nvidia がビデオ メモリの不足を確認したことを証明するものではなく、また、仕様変更だけでは、指標を下げることが生産量を増やすことであることを証明することもできません。関連する説明は、サプライヤーの量産進捗状況、製品認証ステータス、および Nvidia によって開示されたその後の情報に基づいて判断する必要があります。
HBM4 サプライ チェーンの場合、仕様の調整によりサプライヤー間の競争の焦点が変わる可能性があります。以前は、メーカーはより高速なデータ伝送速度を追求する必要がありました。 Nvidia が量産製品の帯域幅要件を引き下げた場合、競争は歩留まり、供給規模、消費電力、安定性、コストにさらに重点を置くようになる可能性があります。認定された製品を大規模に提供できるサプライヤーは、結果としてより多くの機会を得る可能性があります。
プラットフォーム全体の観点から見ると、Vera Rubin はパフォーマンスを決定するためにメモリ帯域幅だけに依存しているわけではありません。 GPU の計算能力、ビデオ メモリ容量、チップ間の相互接続、ネットワーク アーキテクチャ、およびソフトウェアの最適化がシステム パフォーマンスを決定します。 Nvidia が正式に発表した Vera Rubin NVL72 キャビネット構成には 72 個の Rubin GPU が含まれており、第 6 世代 NVLink を介して複数の GPU を接続して、大規模な人工知能のトレーニングと推論タスクをサポートします。
したがって、一部のハードウェア指標が初期の目標よりも低い場合でも、Vera Rubin はコンピューティング アーキテクチャ、ビデオ メモリ容量、システム レベルの最適化を通じてさらに高いパフォーマンスを達成できる可能性があります。本当に注目すべきは、NVIDIAが仕様調整後に計画通りに出荷を拡大できるか、そして実際のモデルのトレーニングや推論のパフォーマンスが顧客の期待に応えるかどうかだ。
コメント