
要約:
NVIDIA に買収された AI 推論チップ企業である Groq は、現在広く使用されている SRAM ソリューションを置き換えるために、3D スタック DRAM テクノロジーを次世代 LPU (言語処理ユニット) 製品に導入することを計画しています。この調整は、同社が大規模な人工知能モデルの需要の拡大に適応するために、将来的にチップストレージ容量の増加にさらに重点を置くことを意味します。
今年初め、NVIDIA は Groq LPX ラック製品を発表し、AI 推論パフォーマンスを強化するために Vera Rubin エコシステムにこれを組み込みました。このラックは今年 8 月に本格的に量産に入りました。初期のテスト結果によると、NVL72 サーバーと連携して動作すると、システムは 1 秒あたり 3,400 トークンの推論速度を達成でき、新しいパフォーマンス記録を樹立することができました。
現世代の Groq LPU は 500MB SRAM で設計されており、最大 150TB/s のメモリ帯域幅を備えています。 LPX ラックでは、システムはこれらのチップ 256 個で構成され、合計 128 GB の SRAM 容量と 640 TB/秒の拡張帯域幅機能を提供します。単一の Groq LPU は、約 1.20 PFLOP の FP8 コンピューティング能力を提供できます。
しかし、Groq は次世代の製品に向けて、まったく異なる道を歩む準備をしています。同社はSRAMのみへの依存をやめ、DRAMを採用し、3Dスタック(3次元積層)パッケージング技術と組み合わせて新たなアーキテクチャを構築する計画だ。 SRAM と比較した場合、DRAM の最大の利点は、SRAM よりもはるかに高い記憶容量を提供できることですが、その代わりに帯域幅とアクセス速度が比較的低いという点です。
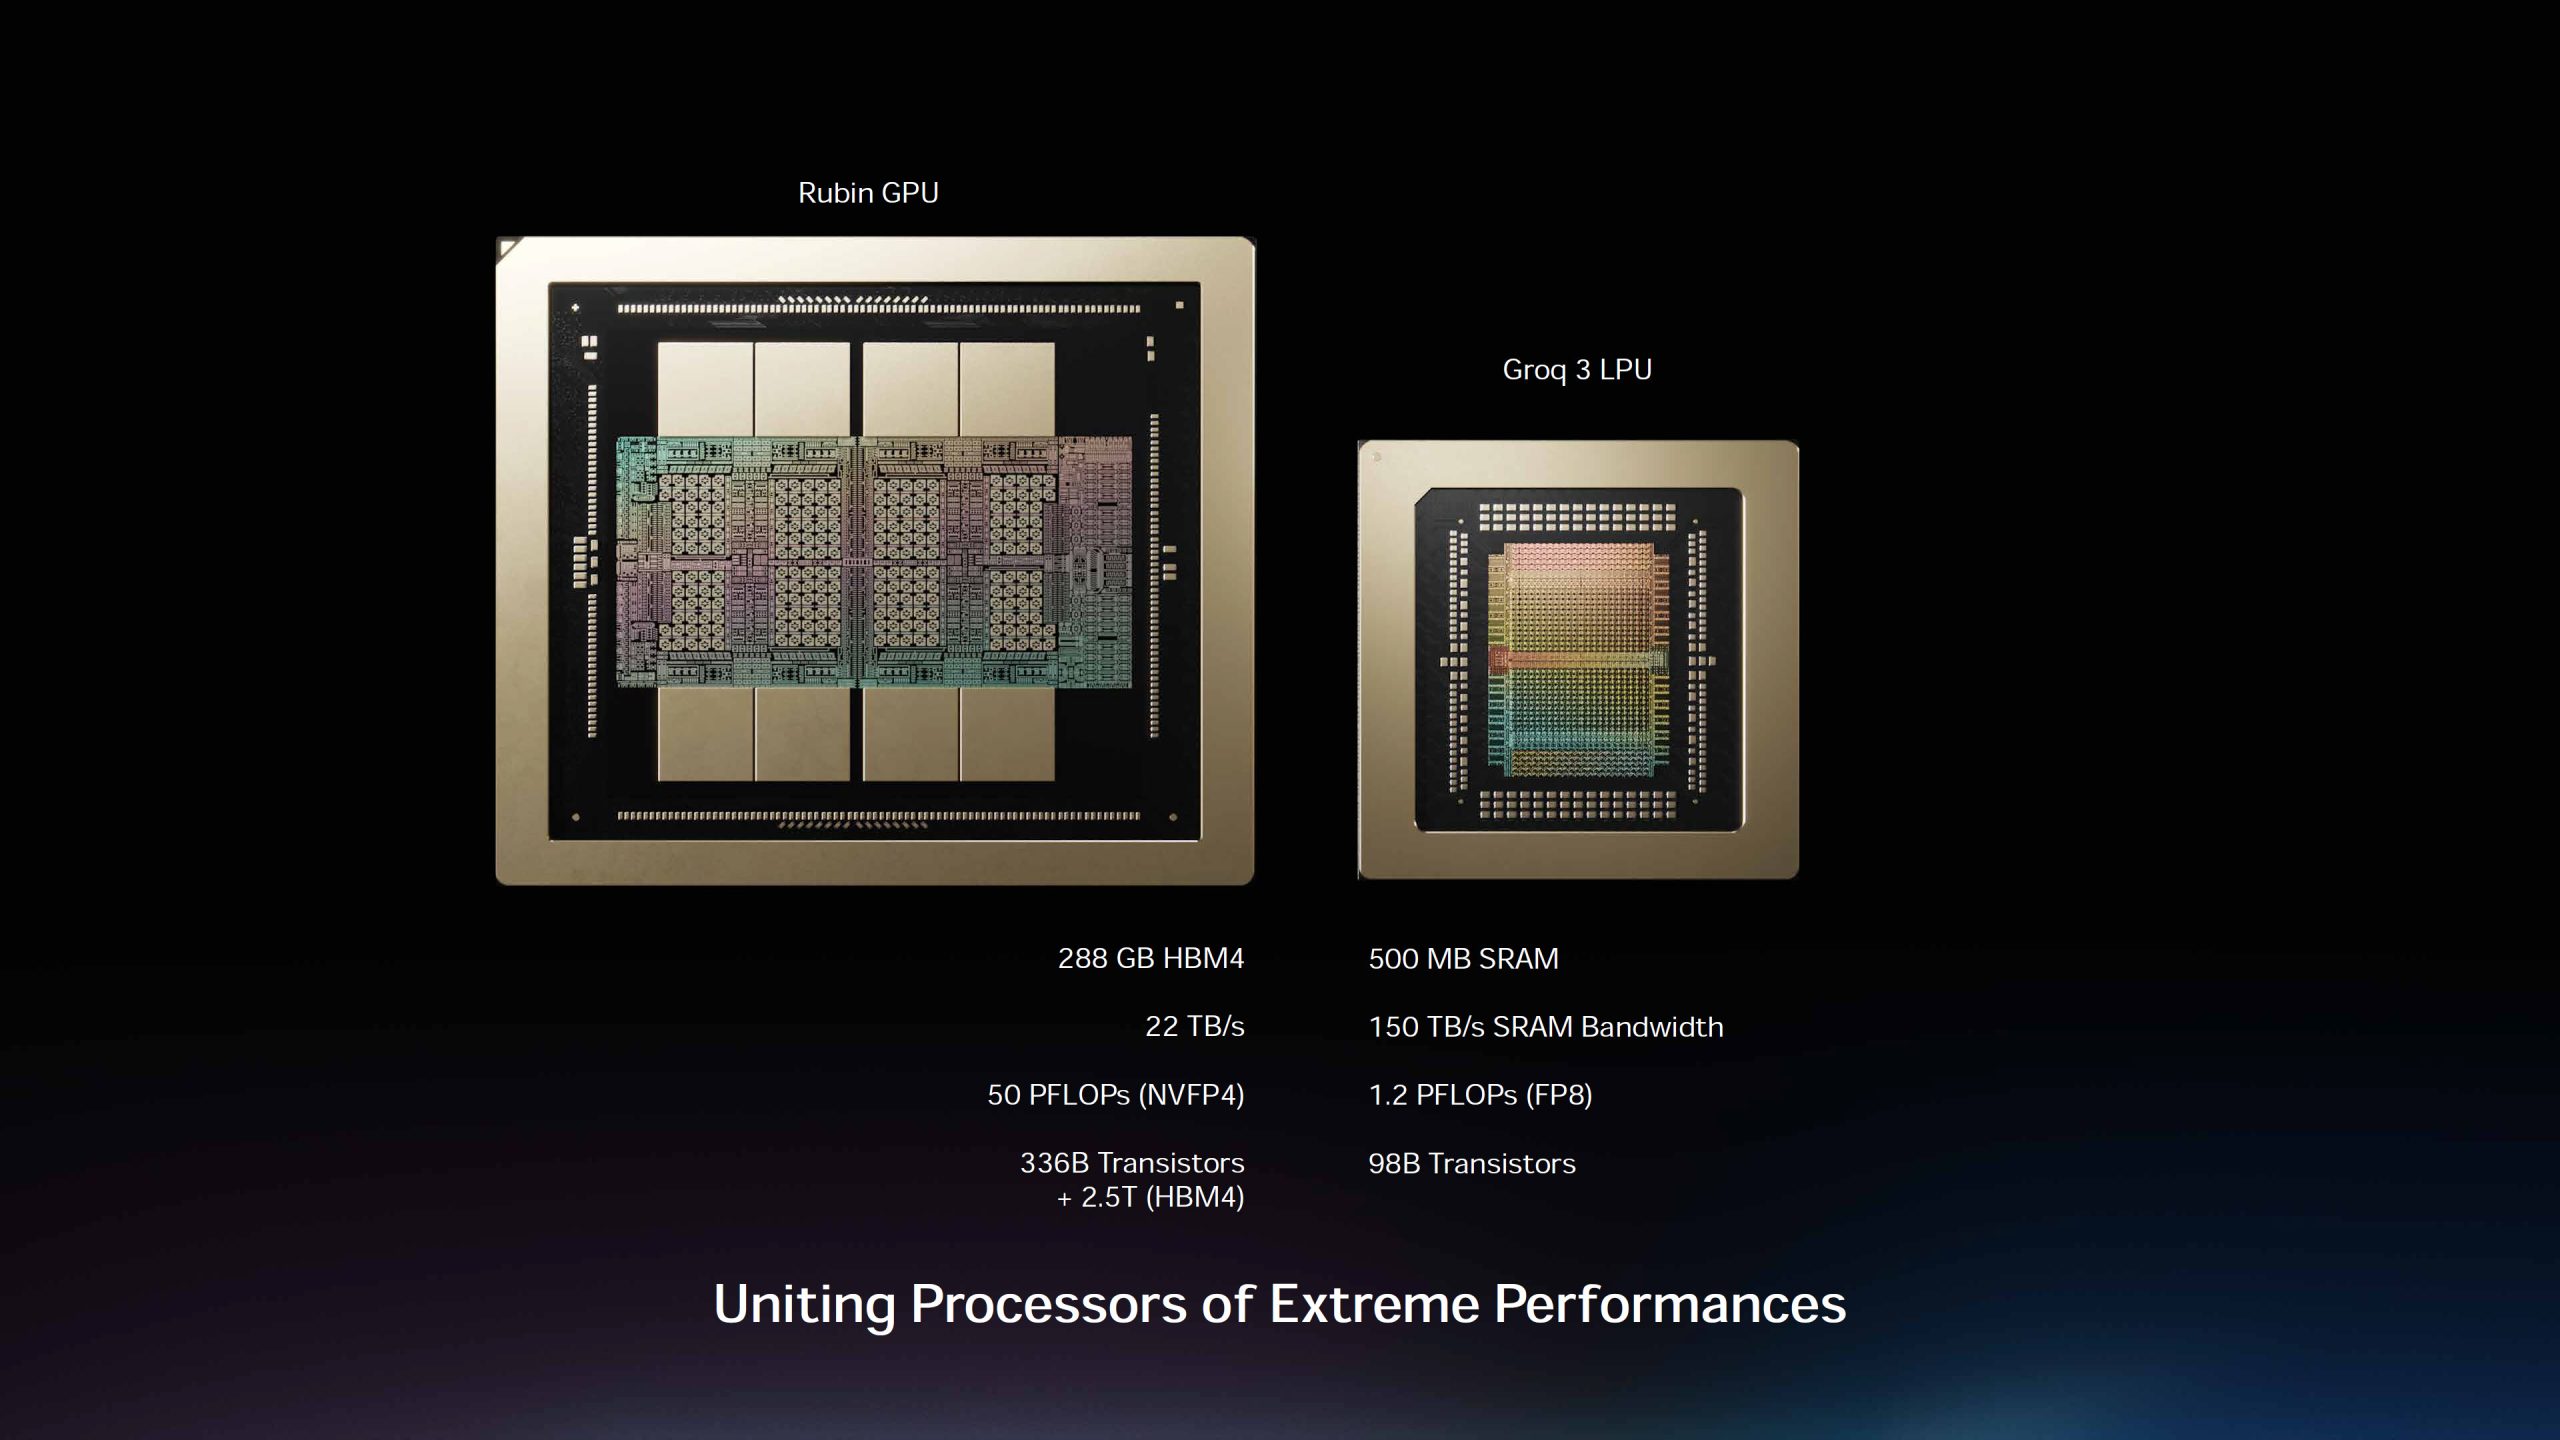
半導体業界関係者によると、Groq は次世代チップに 3D パッケージング技術を導入する計画があり、積層対象は既存の SRAM から DRAM に変わる予定です。この動きは、チップのストレージ容量を大幅に増やしたいというGroqの願望として業界で広く解釈されている。 SRAM は非常に高速ですが、その容量拡張には限界があります。それに比べて、DRAM は低速ですが、大規模なストレージ システムの構築に適しています。
Groq は、3D スタッキング テクノロジーを使用して、単一の垂直構造チップ内に複数の DRAM 層をスタックし、TSV (スルー シリコン ビア) テクノロジーを利用して層間接続を実現できます。この設計コンセプトは、現在の高帯域幅メモリ HBM の実装方法と非常に似ています。従来の DRAM パッケージングと比較して、3D スタッキング ソリューションは単位面積あたりの記憶密度を大幅に高めるだけでなく、エネルギー効率を向上させ、スペース要件を削減することもできます。
これまでに開示された情報から判断すると、Groq の製品アップグレードの焦点は明らかにストレージ容量に移っていますが、SRAM アーキテクチャによってもたらされる高帯域幅の利点を可能な限り維持したいと考えています。生成AIモデルの規模が拡大し続けるにつれて、大容量高速メモリのニーズが高まり続けているため、新世代のGroqチップはさらに広く使用されることが予想されます。
レポートでは、Groq が将来的に SRAM を完全に放棄するわけではないが、DRAM と SRAM 製品ラインを並行して開発し、さまざまなアプリケーション シナリオに応じて差別化されたソリューションを提供する予定であるとも述べています。 AI ファクトリーや AI プラットフォームを構築している NVIDIA にとっても、この種の高容量推論チップは将来的により重要な役割を果たすことが予想されます。
コメント