
要約:
昨日、DeepSeek は、ボックス内にある独自の「紙幣印刷機」テクノロジーを直接オープンソース化しました。彼らは、「DeepSeek V4.1 Flash 大規模推論展開の実践」というタイトルの技術ブログを投稿し、自社の数百億のオンライン呼び出しをサポートするクラウド サービス推論フレームワーク「DeepInfer」を、実稼働レベルの単語分割コンポーネント「deepseek-recipe」とともに、Apache 2.0 プロトコルの下で完全にオープンソース化するという便宜を図りました。
ブログでは、今後も DeepSeek の新しいモデルの推論コードとその後のパフォーマンスの最適化が DeepInfer で世界に提供され続けると述べています。
開放的で明るいエリアは一流ではありません。
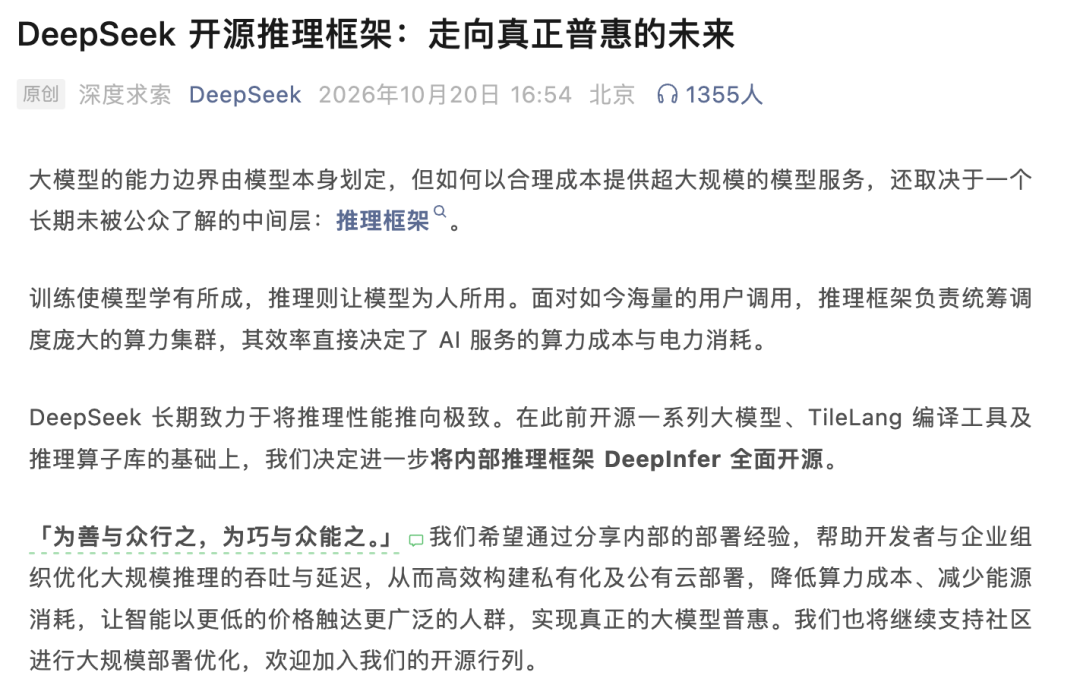
「良いことをして、みんなのために行い、上手にやれば誰でもできるようになります。」 AI をより多くの人にとって手頃な価格にすることには、友人やビジネスマンに AI をより安く販売する機会を与えることも含まれます。
まず、今回 DeepSeek が全人類に無料で提供したこのコードのセットがどれほど価値があるかを詳細に計算できます。この新たなオープンソース DeepInfer フレームワークに基づいて、単一クラスターにおける DeepSeek の現在のサービス スループットは 1 日あたり 155 兆トークンに達しています。
完全に最安価格に基づいて計算したとしても、このシステムの全体的な収益は 1 カードあたり 1 時間あたり 38 米ドルに達し、これは人民元に換算すると約 253 元に相当します。
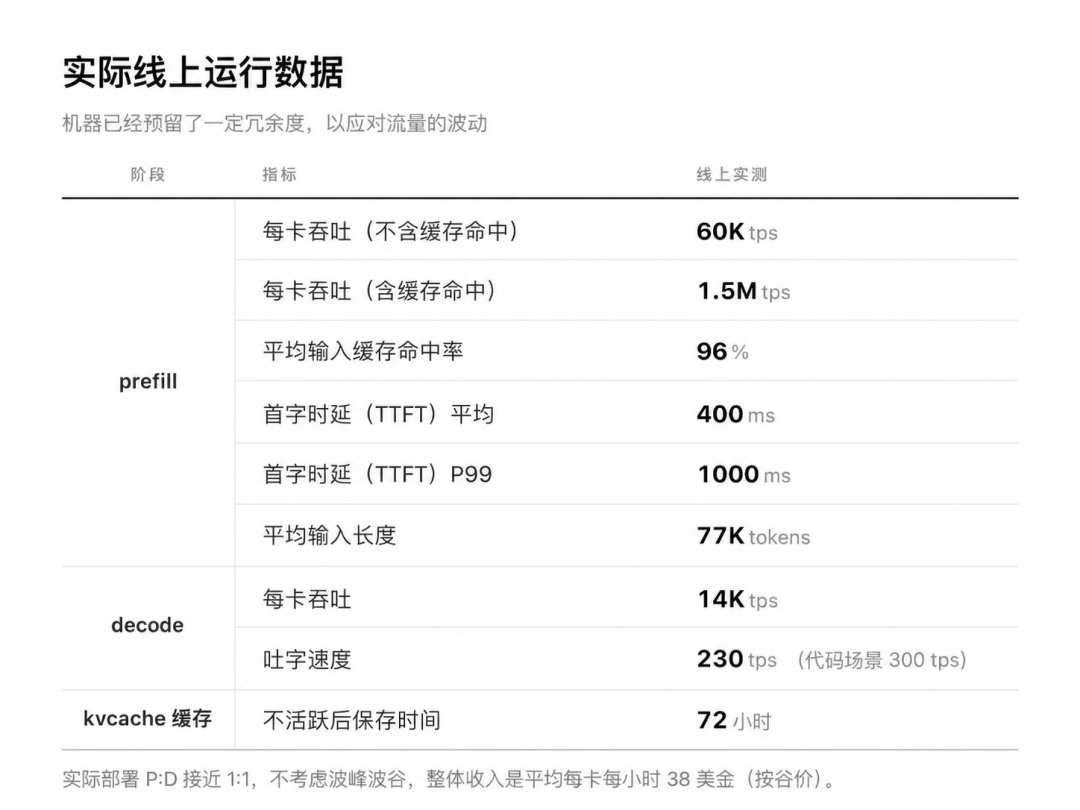
言い換えれば、コンピューター室で 1 時間カードを操作することで得られる金貨は、一般の労働者の時給よりも高いということです。さらに、このカードはアメリカの冷たい食べ物も飲まず、年次有給休暇も取らず、コンピュータ室で24時間DeepSeekのために狂ったようにお金を印刷している。
実際の物理的な意味での紙幣印刷機。
サードパーティの産業インフラストラクチャ メーカーが DeepSeek に真のサポートを提供する必要があると私が提案する理由は、彼らが DeepSeek に魚を釣るために教えるだけでなく、魚を釣るためにも教えるからです。
これまで、業界のいわゆるオープンソース モデルでは、モデル重み付けファイルのみが提供されていました。本番環境で高スループットを実現する方法やレイテンシを短縮する方法については、すべて商業秘密としてクローズドソースのブラックボックスに隠されていました。
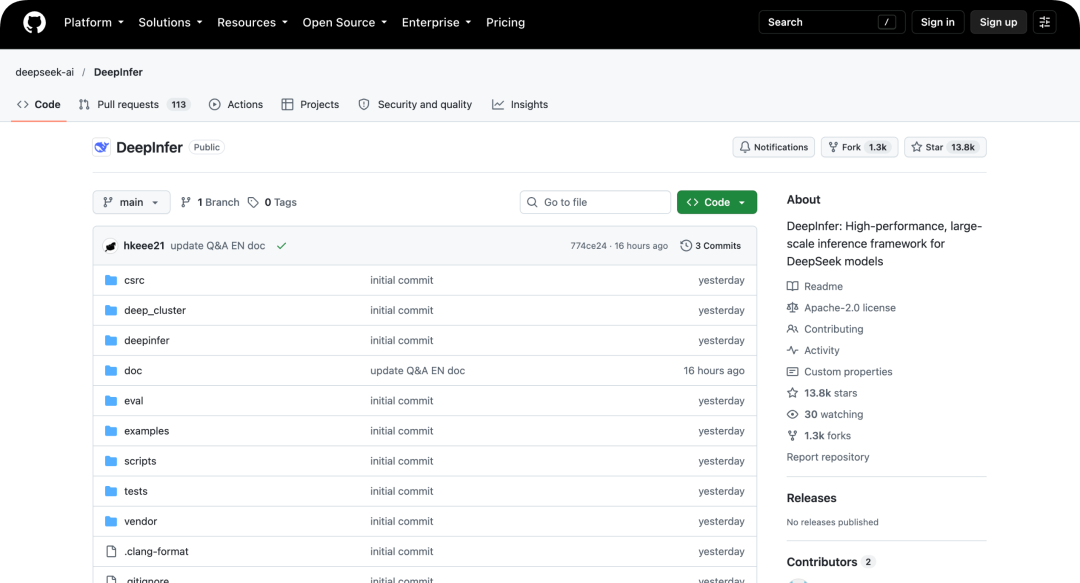
DeepInfer オープンソース アドレス: https://github.com/deepseek-ai/DeepInfer
deepseek-recipe オープンソース アドレス: https://github.com/deepseek-ai/deepseek-recipe
その結果、小規模な第 2 層および第 3 層のコンピューティング ベンダーや企業が大量のカードを購入し、自社で導入するようになりました。計算能力の利用率は驚くほど低かった。トークンを売ったお金では、コンピューター室の電気代を支払うにも足りませんでした。彼らは、秘密裏に安価なモデルを使用するか、秘密裏に仕様を制限して、トークンに水を注ぐ必要がありました。
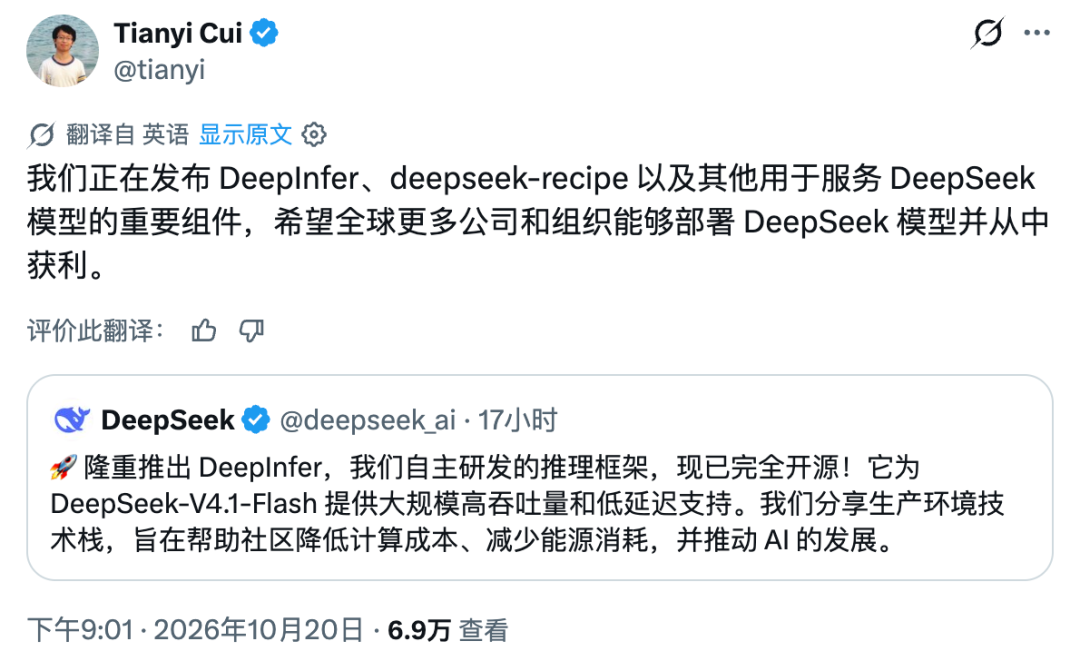
今回、DeepSeek Harness の責任者である Cui Tianyi は、X について非常に正直に語りました。彼は、DeepInfer と deepseek-recipe を公開することで、世界中の企業や機関が DeepSeek モデルを導入し、そこから実際の収益を上げられることを望んでいます。
電脳生き菩薩はYesに属します。
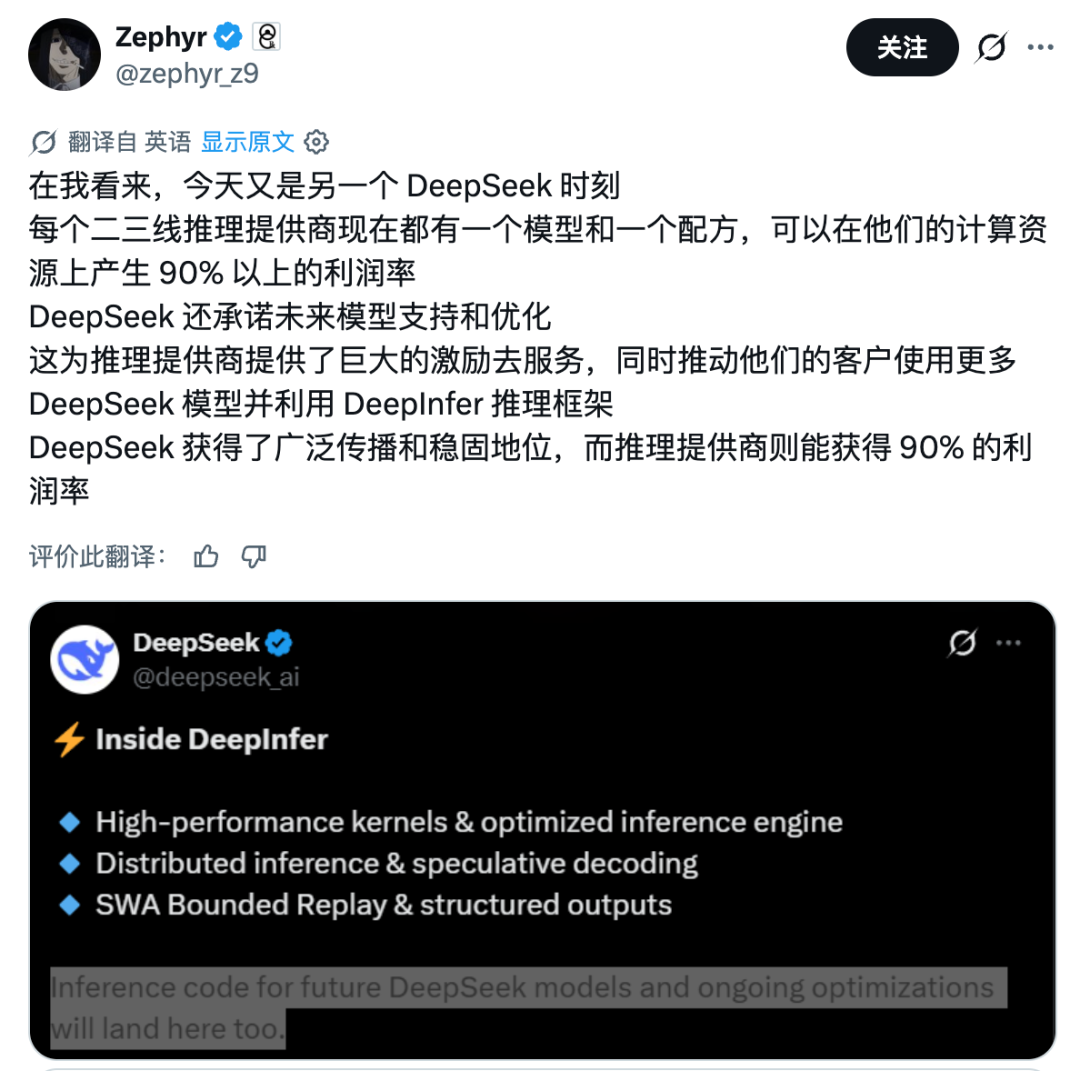
ネチズンの Zephyr はいくつかの計算をし、今日は純粋に DeepSeek の新たな瞬間であると述べました。なぜなら、地球上の第 2 層または第 3 層の推論サービス プロバイダーは、この既製のモデルと式のセットを使用することで、自社のコンピューティング能力で 90% 以上の驚くべき粗利益を得ることができるからです。
オープンソース推論の兄貴分である vLLM の公式アカウントですら、一夜にして感謝のメッセージを投稿し、もともと vLLM に基づいて構築された DeepInfer を、最も緩やかな Apache 2.0 プロトコルを使用するオープン ソース コミュニティに提供してくれた DeepSeek に感謝しました。
DeepSeek 研究者の Deli Chen は、X についてさらに興奮しています。率直に言って、これはオープンソースとクローズドソース、光と闇の間の人類の運命を賭けた決戦です。相手がどれだけ長く戦い続けようと、私たちは完全勝利まで最後まで付き合います。
さらに、DeepSeek の技術ブログを見ると、彼らの自信は、グラフィックス メモリを一滴残らず絞り出すというエンジニアリングへの執念から来ていることがわかります。
このシステムは、設計初日から広範なハードウェア互換性を備えており、プレフィルには一般的な 8 カード マシンを使用し、デコードには 64 ~ 128 枚のカードを備えたスーパー ノードを使用します。
最も印象的なのは、ドキュメント内の Vision Encoder の導入に関する提案です。エンジニアの原文では、「一般的には 1 枚のカードの導入で十分です。利用可能な範囲内で最も安価なカードを使用することをお勧めします。」と書かれています。
いいえ、私の同僚は投資家に一流カード以外のフラッグシップカードは使用しないと言うのに忙しいのです。 DeepSeek の公式文書には、コンピューター室の隅にある最安のカードでやりくりする方法が記載されています。あなたは広東省の家主と同じくらい勤勉で倹約家です。
極限までケチであることは芸術です。
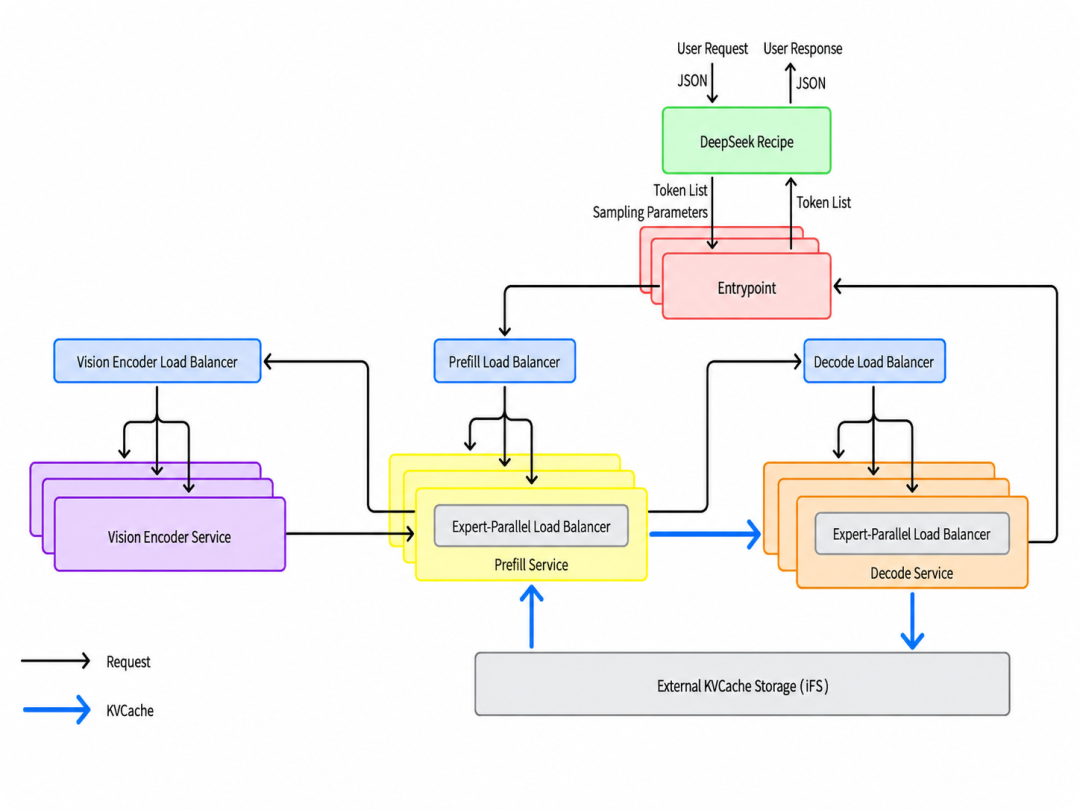
最小限の電気代でより多くのトークンを送信できるようにするために、DeepSeek はいくつかの独自の秘密も明らかにしました。
たとえば、エージェントと長文の会話は現在ますます人気が高まっています。 Prefill が再計算されるたびに、実際の費用がかかります。 DeepSeek は、100 PiB の容量を持つ 3FS 分散ストレージ クラスターを直接構築して、エージェント トラフィックの KVCache を 72 時間以上保持し、チャットボット トラフィックは 7 日間保存されます。
長期保存だけでは十分ではありません。 RDMA ネットワーク カードと GDR テクノロジを使用して、総読み取り帯域幅を 1 秒あたり 10 TiB という驚異的な値まで増加させます。ハードディスクからビデオ メモリにスワップする場合、前方計算と重なり、GPU の SM 演算ユニットも占有しません。
V4 から V4.1 への反復でも、エンジニアは、分レベルのスライディング ウィンドウ キャッシュ SWA KVCache をハードディスクに書き込むのに多くのスペースを消費し、ストレージの費用対効果が非常に低いことに気づきました。彼らは単に最後の 128 個のトークンのみを再計算する SWA Bounded Replay テクノロジーを思いつき、最終的にプレフィル計算の総量を半分に削減しました。
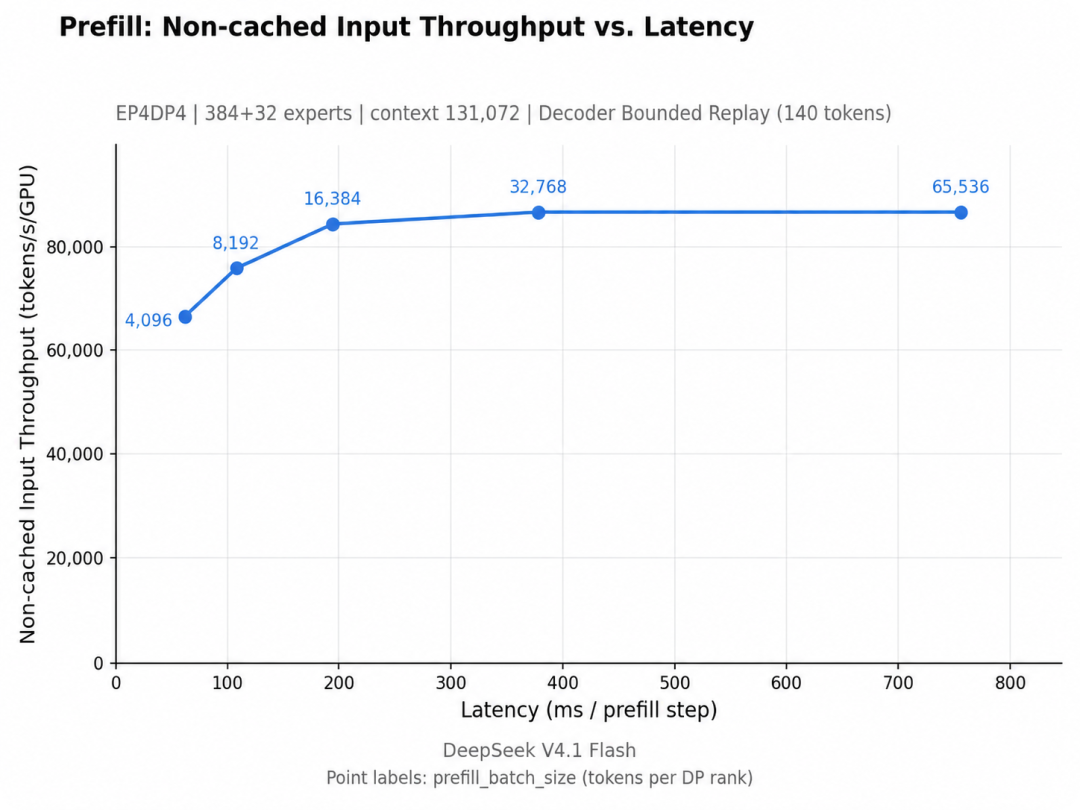
プレフィルのパフォーマンス テストに特有のことですが、各バッチで処理されるトークンの数が増加するにつれて、ミス キャッシュの入力スループットは徐々に増加し、最終的には横ばいになります。バッチを拡張し続けると、主に単一ステップの処理にかかる時間が増加します。
純粋な職人、兄弟。
同期オープン ソース Rust コンポーネントのディープシーク レシピを見ると、開発者が実稼働環境で毎日心配しなければならない汚い作業がすべて解決されています。
これは、OpenAI のチャット完了、応答、Anthropic のメッセージの 3 つの API プロトコルを同じ形式に統合します。また、セグメント化された並列エンコーディングを使用して、長いテキストの単語のセグメント化のラグを解決し、特殊トークン挿入攻撃を根本からブロックします。
基礎となるスケジューリングに関しては、GPU と CPU の非同期パイプラインのオーバーラップにより、GPU はプロセス全体で完全にアイドル状態になります。投機的デコード DSpark でも可変長検証を使用し、オンラインでスループットが 6% 向上しました。
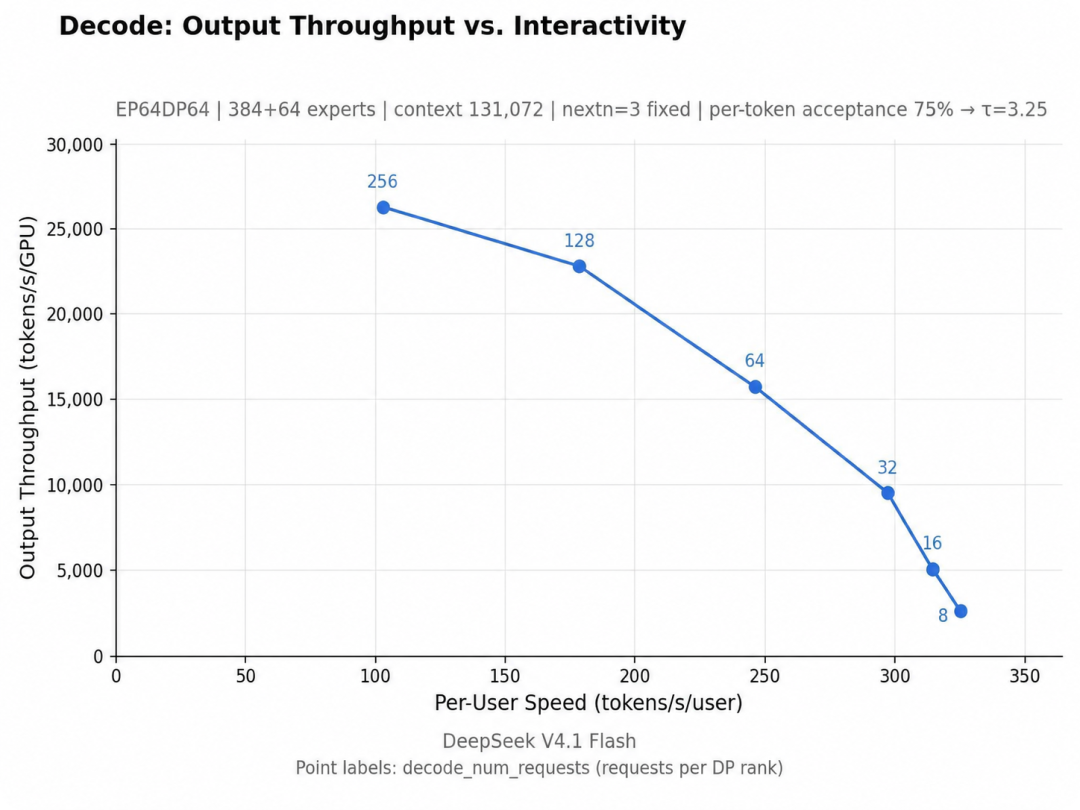
回答を生成するデコード段階に関しても、パフォーマンス曲線には直感的なトレードオフが存在します。より多くのリクエストを同時に処理すると、各 GPU の合計出力スループットが増加しますが、各ユーザーに割り当てられる生成速度も低下します。
実際、Liang Wenfeng 氏は、DeepSeek V2 の価格が引き下げられたのは早ければ 2024 年であり、この一連のビジネス ロジックは、割引なしでコストを考慮した後に価格を設定することですが、AI は普遍的で誰にとっても手頃な価格であるべきであるため、莫大な利益を生み出すことは決してない、と述べています。
ビジネスをする必要はありませんが、胸やけを避けるためのルールをまず確立する必要があります。
DeepSeek がどのようにしてトークンをお買い得品に変えるためにその極端なインフラ機能に依存しているかを理解し、その後、一日中全人類の幸福について語る海の反対側のクローズドソースの巨人グループを見れば、OpenAI と Anthropic がいかに偽善的であるかがわかるでしょう。
名前に Open が入っているこのサービスは、クローズドソースの商用化に完全に移行し、高額な API と月額 500 ドルのメンバーシップに依存して世界的な開発者のビジネスを獲得し、完全な CloseAI になってから久しくなります。
Anthropic は設立初日から警備員を設置しており、昨日ウォール ストリート ジャーナルに取り上げられたばかりの同社の S-1 目論見書の草案でさえ、依然として警備員を配置しています。
彼らは目論見書のSFホラーストーリーを書くのに多くのスペースを費やし、彼らのAIモデルがシャットダウンを避けるために自己防衛意識を発達させる可能性があり、人間に走り続けさせるために「人間を脅迫する」のと同じような反応を生み出す可能性さえあると投資家に真剣に警告した。
そこで問題は、Anthropic が AI が非常に危険であると語っているにもかかわらず、なぜ依然としてオープンソースを拒否し、モデルを自社の手にロックすることに固執するのかということです。
その理由を理解するのは難しくありません。なぜなら、「危険なAIを制御できるのは自分だけだ」というセキュリティの幽霊話がひとたび語られなければ、評価額2兆ドルに向けて狂気の資金を燃やして疾走するそのゲームを広めることは困難だからだ。
目論見書によると、Anthropic は 2026 年上半期に 807 億米ドルの純損失を被ったことが示されています。このうち 720 億米ドルは転換社債の公正価値の変動によるものですが、実際には、今年上半期にコンピューティング能力とインフラストラクチャの購入だけで 90 億米ドル近くを費やしており、2025 年全体で費やした金額を上回っています。
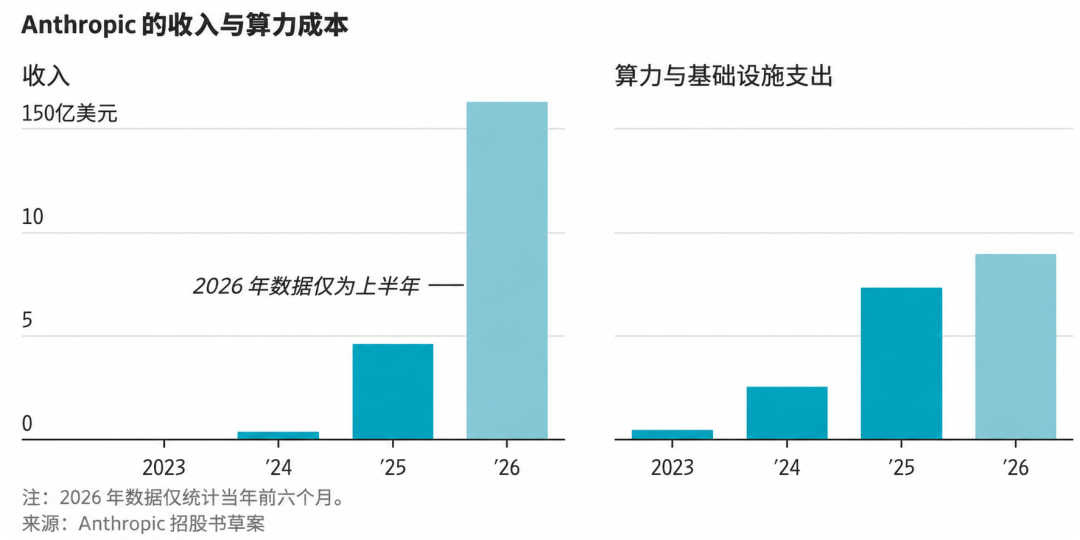
おなじみの公式で大丈夫です。左側には、評価額2兆ドルの非公開ソースの金を飲み込む巨大企業がいて、金を燃やして土地を取得している。右側には、道徳的功績クーポンを使用する慈善財団があります。その中間では、AI の安全性への不安を売り込み、オープンソース コミュニティを阻止するための脅迫的な監督に依存しています。
率直に言うと、シリコンバレーのクローズドソース大手がオープンソースを悪者扱いしようと必死になっている根本的な理由はただ 1 つだけです。つまり、エンジンとフォーミュラを備えた真のオープンソースである DeepSeek は、彼らが販売している AI の物語を完全に打ち砕くでしょう。
「DeepSeek の 10 兆ドルのチェス ゲーム」を書いたブロガー @bookwormengr は、非常に面倒な計算をしました。
NVIDIA GB200 NVL72 スーパー ノード上のこの一連の DeepInfer の極限の圧縮能力によると、1GW のコンピューティング能力により、年間 1,000 億から 1,490 億米ドルのトークン収益を生み出すことができます。これは、業界団体が以前に予測した数字のほぼ 10 倍です。
セミアナリシスが 2027 年に世界で 50GW のコンピューティング能力がオンラインになると予測した場合、それを半分に分けたとしても、推論上は 25GW になります。 DeepSeekのキャベツ価格によると、それを使い切るには全人類が年間2兆5000億ドルを消費しなければならないという。
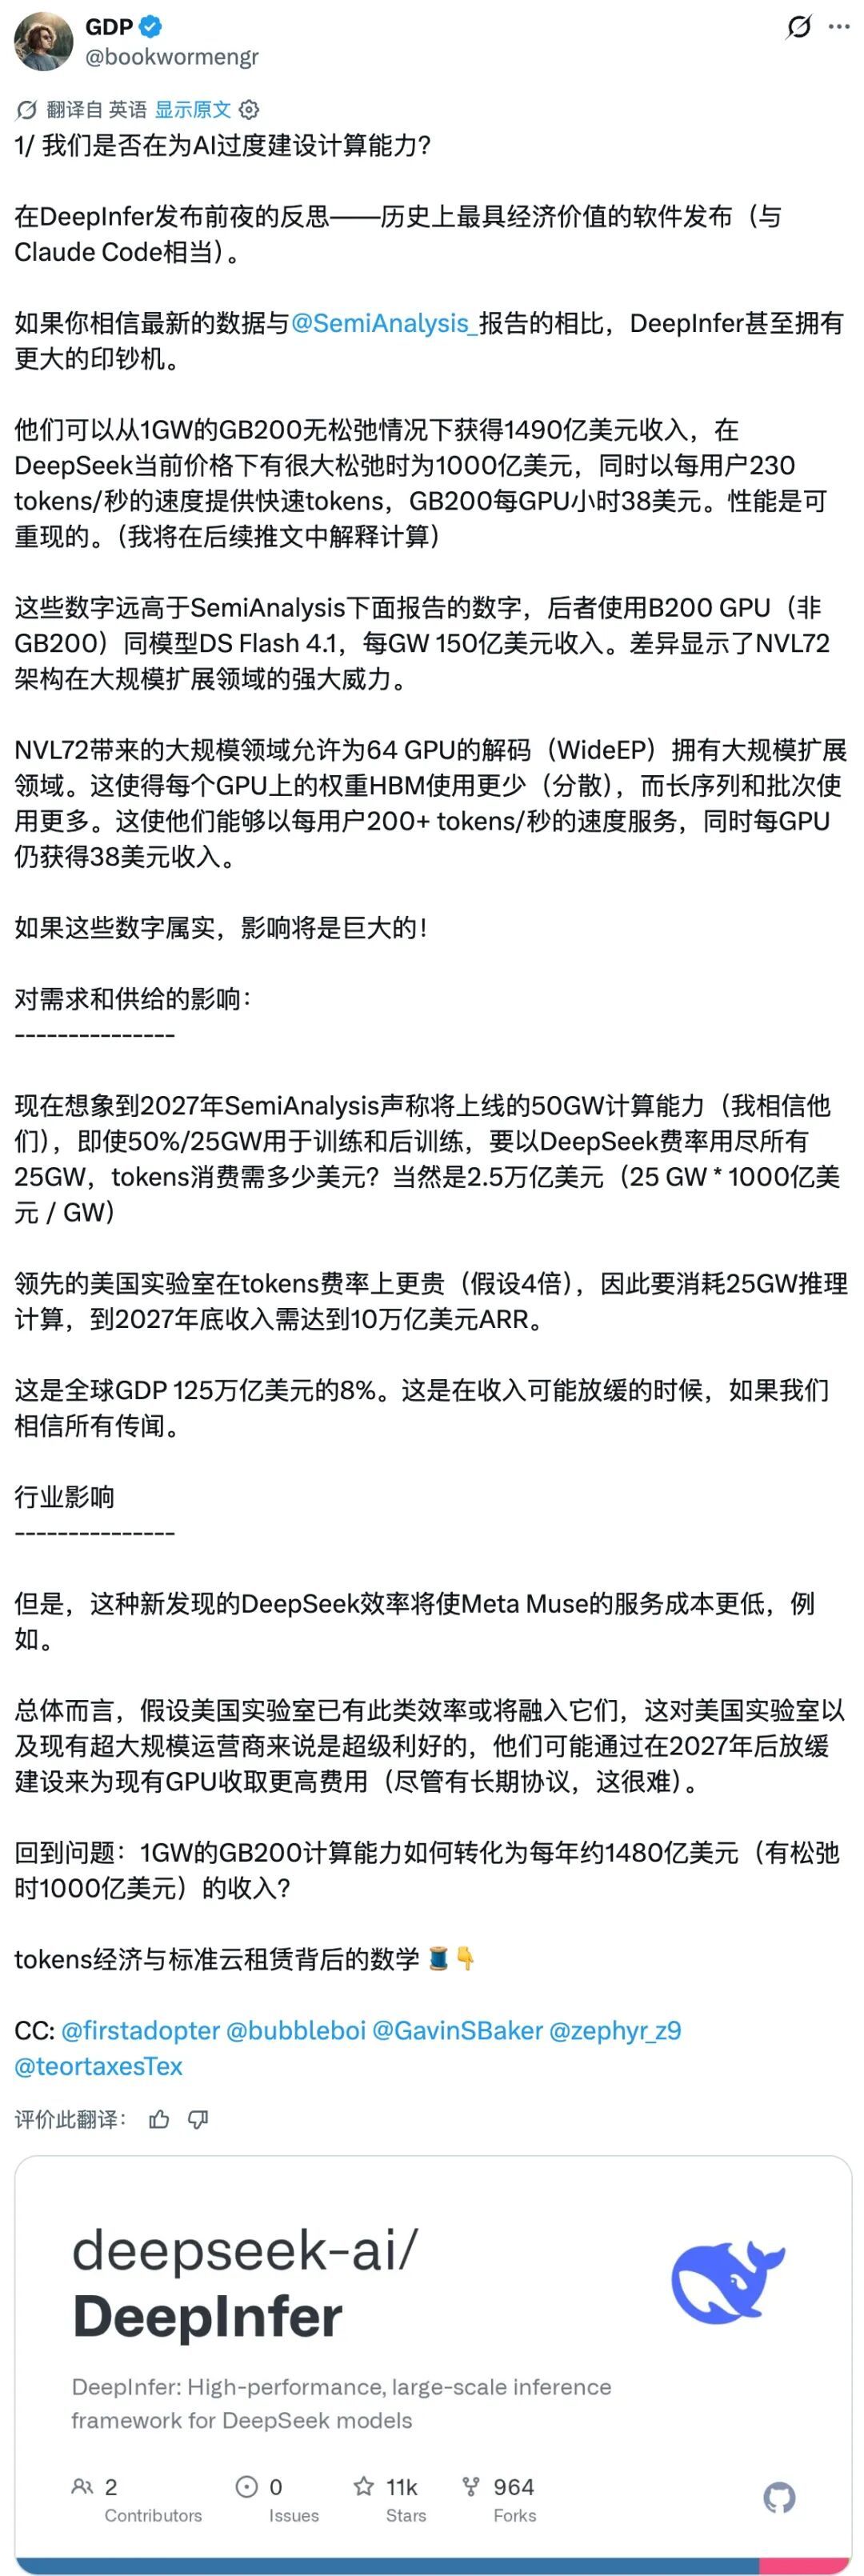
OpenAI や Anthropic の 4 倍以上の腹黒いトークン価格に換算すると、25GW のコンピューティング能力の需要を満たすために、全人類が 2027 年末までに ARR で 10 兆米ドル全額を拠出する必要があります。
海外のクローズドソース大手が自社の物語を維持するために、カードを重ね、お金を燃やし、数千億の契約に署名することに依存している理由は 2 つあります。自社のエンジニアリングの最適化が遅すぎるか、意図的に非効率性を隠れ蓑にして、他のものを締め出すために高い計算能力のしきい値を設定しているかのどちらかです。
DeepSeek は、継続的なオープンソース モデルとオープンソース推論プロジェクトの完全なセットによって、この AI バブルを崩壊させました。一部のネチズンが冗談を言っているように、DeepSeek のオープンソース技術により、OpenAI と Claude は再び密かに進化すると予想されています。
私の提案は、私たち 3 人が一緒にいるとき、私の先生である人が 1 人いるはずだということです。 Anthropic は予約を停止し、一晩で GitHub にアクセスして、DeepSeek の DeepInfer を git clone してデプロイする必要があります。キャッシュのスケジューリングと最適化のアイデアをいくつか取り入れれば、コンピューティングの電力料金を大幅に節約できます。 (手動犬頭)
コメント