
要約:
Microsoft は、11 月 12 日から 13 日にかけて広範に発生した Microsoft 365 の障害に関する予備調査結果を発表し、障害の原因は数か月間眠っていた Windows サーバーの欠陥、Teams のトラフィックの切り替え、ゲートウェイの利用可能な容量の減少であると述べました。この事故は11月12日の16時20分(協定世界時)から翌日の16時10分(協定世界時)まで、ほぼ24時間続きました。
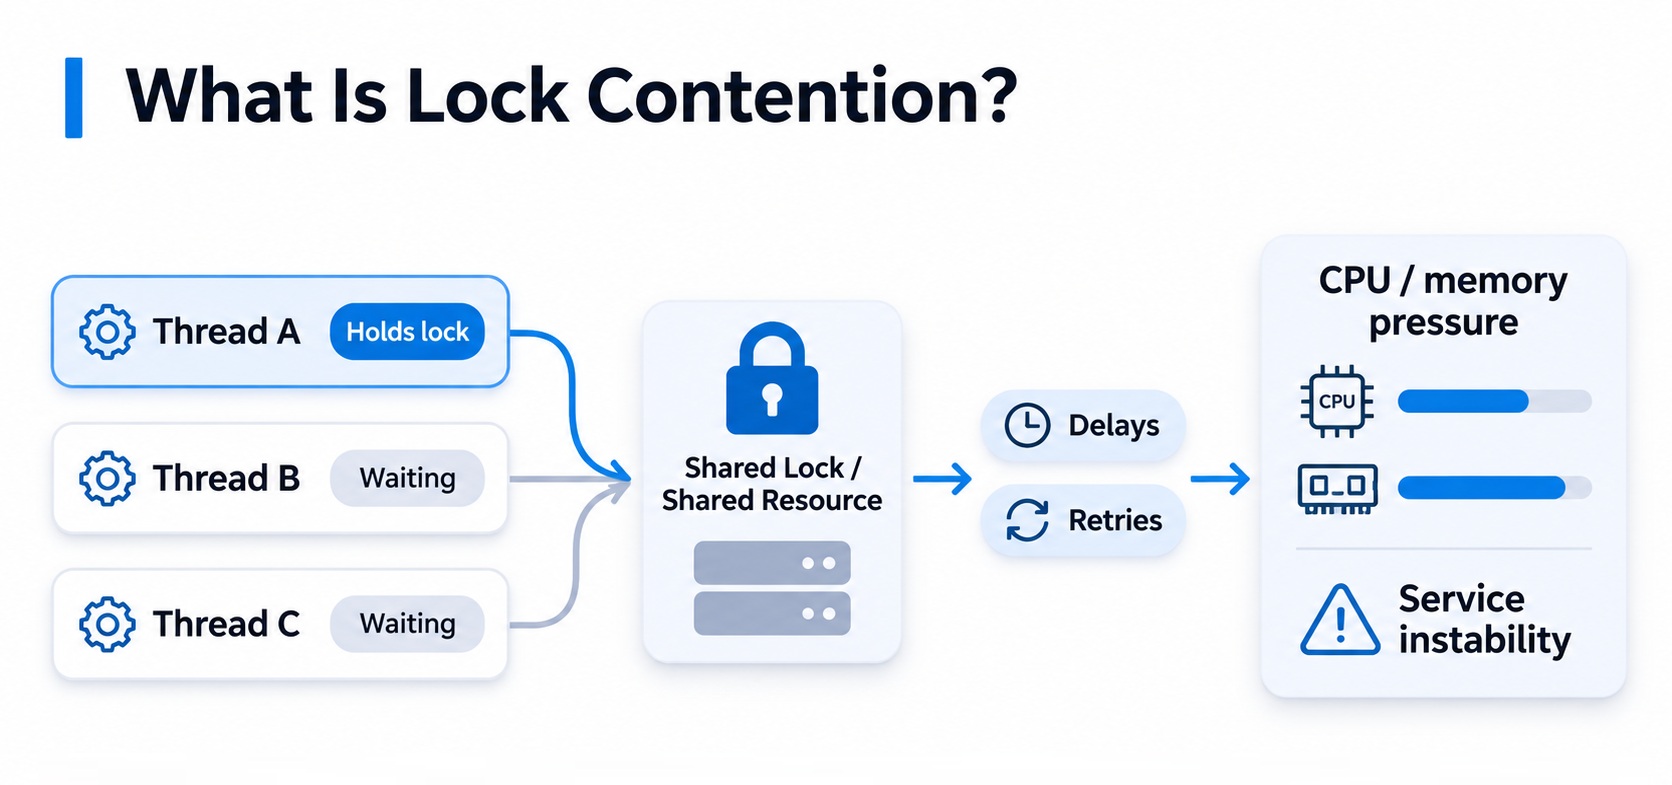
Microsoft は、この欠陥は今年 7 月に Microsoft 365 Network Gateway Server に展開された修正プログラムに起因すると述べました。特定の負荷がかかると、Windows の内部プロセスでロック競合が発生し、サーバーの CPU リソースとメモリ リソースが徐々に枯渇し、最終的には応答しなくなります。この問題は以前は検出されませんでしたが、その理由の 1 つは、Microsoft のテスト環境で使用されていたコア数の少ないハードウェアでした。調査の結果、コアの多い新しいサーバーではロック競合が激化する可能性が高いことがわかりました。 Microsoft は、この欠陥と関連修正は Microsoft 365 ゲートウェイ インフラストラクチャのみに関係しており、他の Windows 展開には影響しないと強調しました。
障害の約 15 時間前に、Teams のトラフィックがバックアップ ネットワーク ゲートウェイから Exchange Online と共有されるプライマリ ゲートウェイに切り替わり、トラフィック パターンが変化し、負荷が増加しました。同時に、前日に発生した別の問題により、ゲートウェイのサーバー容量の約 14% が一時的に利用できなくなりました。 Microsoftは、これら2つの要因だけでは影響はなかったが、潜在的な欠陥と組み合わさるとサーバーの過負荷を引き起こしたと述べた。
サーバーが応答を失うと、トラフィック管理システムはリクエストを他の正常なノードに転送します。これにより、残りのサーバーに大きな負荷がかかり、障害が 1 つずつ広がります。 2 時間以内に、ゲートウェイ サーバーの 80% 以上が応答しなくなりました。当初、異なるリージョンの障害を隔離するために使用されていた保護手段では、問題がリージョン間で広がるのを防ぐことができませんでした。 Microsoftは、今回のインシデントで最も深刻なインシデントはExchange Onlineで、多くのユーザーがメールボックスにアクセスできず、メールを正常に送受信できなかったと述べた。 Teams、Copilot、SharePoint、OneDrive などの Exchange 機能に依存するサービスも程度の差はありますが、一部のサービスのチャットおよび会議機能は引き続き使用できました。
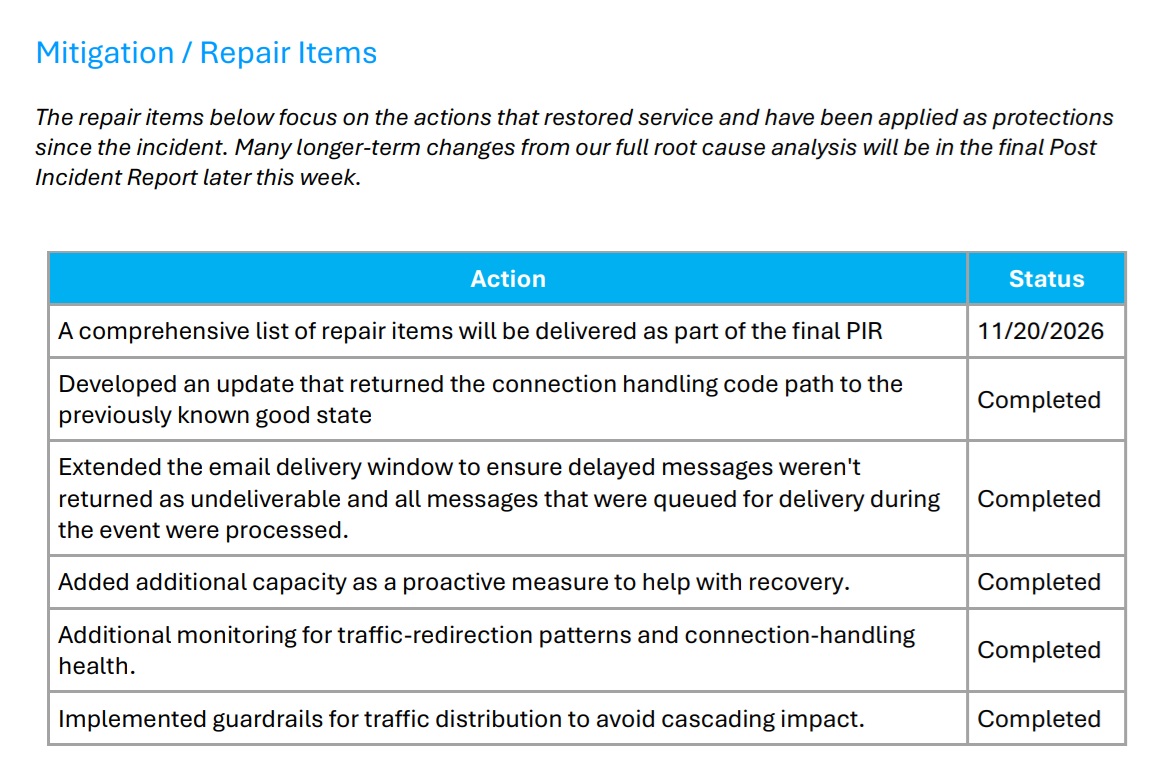
再起動されたサーバーがバックログのトラフィックを受信するとすぐに再び応答しなくなる可能性があり、欠陥が数か月前に展開されていたため、定期的なロールバックや機能の切り替えをすぐに元に戻すことができなかったため、回復プロセスが長期化しました。エンジニアは最終的に、接続処理コードを以前の安定したバージョンに復元し、バッチで修復し、サーバーを再起動して、トラフィックを徐々に回復しました。 Microsoft は、グローバル Web メール サービスが 11 月 13 日 14 時 17 分に予想レベルに復旧し、同日 16 時 10 分にユーザーがインシデントの直接的な影響を受けなくなったことが確認されたと発表しました。遅延した電子メールはその後処理されました。
Microsoft は、サーバーの容量と監視を強化し、トラフィック分散保護措置を追加し、バックログのメールが配信失敗と誤って判断されるのを防ぐためにメール配信の待機時間を延長しました。同社は、現時点ではこの事件に悪意のある活動や人工知能エージェントが関与した兆候はなく、長期的な是正措置を補足するために11月20日までに最終的な事後報告書を発行する予定だと述べた。
コメント