
要約:
韓国の GF Securities のアナリストである Jeff Pu 氏は、NVIDIA が 2028 年後半に Foveros パッケージング技術を採用する可能性があると考えています。このニュースには依然として注意が必要です。関連する契約や特定の製品はまだ発表されていません。この推測は、今年1月のDigiTimesの初期レポートを反映しています。当時のレポートでは、Nvidia の将来の Feynman シリーズ GPU のサポート コンポーネントには Intel の 18A または 14A プロセスが使用される可能性がある一方、メイン GPU チップの生産は依然として TSMC の高度なプロセスによって完了される予定であると述べられていました。
言い換えれば、インテルは主に非コア IP モジュール、またはベア ウェーハ製造が完了した後のバックエンド プロセスを担当することになります。 14A プロセスは 2028 年後半に大規模生産が開始される予定であり、これは Jeff Pu が示したスケジュールと一致しています。
AI アクセラレータの製造は、フロントエンド プロセスとバックエンド プロセスに分かれています。フロントエンドでは主にウェハ上に回路が製造されます。バックエンドには、ウェーハの切断、相互接続、さまざまなベア ダイのパッケージング ケースへの統合が含まれ、最終的にはデータ センターで使用できるチップが製造されます。
インテルは、最先端プロセスのファウンドリ分野で TSMC に追いつこうと依然として努力しています。しかし、パッケージング回路では、インテルの EMIB、EMIB-T、および Foveros テクノロジーは比較的成熟しています。 GoogleはEMIB-Tに関心を示しており、自社開発のAIテンソルプロセッサTPUに利用する計画だと言われている。
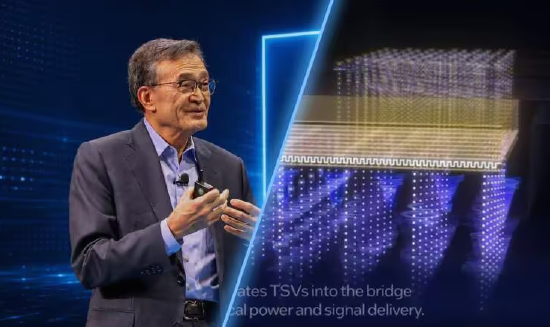
EMIB は、基板に埋め込まれたシリコン ブリッジを利用して複数のコアを横方向に接続します。 EMIB-T は、このアーキテクチャに TSV (Through Silicon Via) を追加します。これは、電力と信号を直接送信するためにシリコン ウェーハを貫通する垂直相互接続チャネルです。
Foveros は、コンピューティング ダイまたはその他のチップをベース ダイの上に垂直に積層することで、さらに一歩進んでいます。この構造により、パッケージの横面積を縮小し、配線を短くすることができるため、帯域幅の増加とエネルギー効率の向上が期待されます。
NVIDIA にとって、バックエンド パッケージング サプライヤーの多様化により、TSMC のパッケージング生産能力への依存を減らすことができます。現在、世界的な AI アクセラレータに対する強い需要があり、TSMC のパッケージング生産能力は非常に逼迫しています。
インテルにとって、ファインマン関連プロジェクトを獲得した場合、高度なリソグラフィ分野で即座に勝利を収めることよりも、Foveros テクノロジーの産業検証を完了することがより重要な意味を持ちます。
コメント